5.2 成本治理与性能优化
5.2 成本治理与性能优化
本节摘要:按量计费是 Serverless 最动听的承诺,也是最需要管理的风险——用得好是"为零为弹性付费",管不好是"为浪费付费"。本节拆解计费模型的构成、四类典型浪费模式、成本优化的优先级排序、以及预算告警的设置方法。核心观点:成本治理的本质不是省钱,是让每一分支出都能追溯到一段合理的业务价值。
学习目标
阅读完本节,你应当能够:
- 拆解函数应用的计费构成,建立自己的成本模型
- 识别四类典型浪费模式并对号治理
- 按优先级排序优化动作,避免捡芝麻丢西瓜
- 设置预算与异常告警,让成本失控在小时级被发现
一、计费模型:知道为什么收费
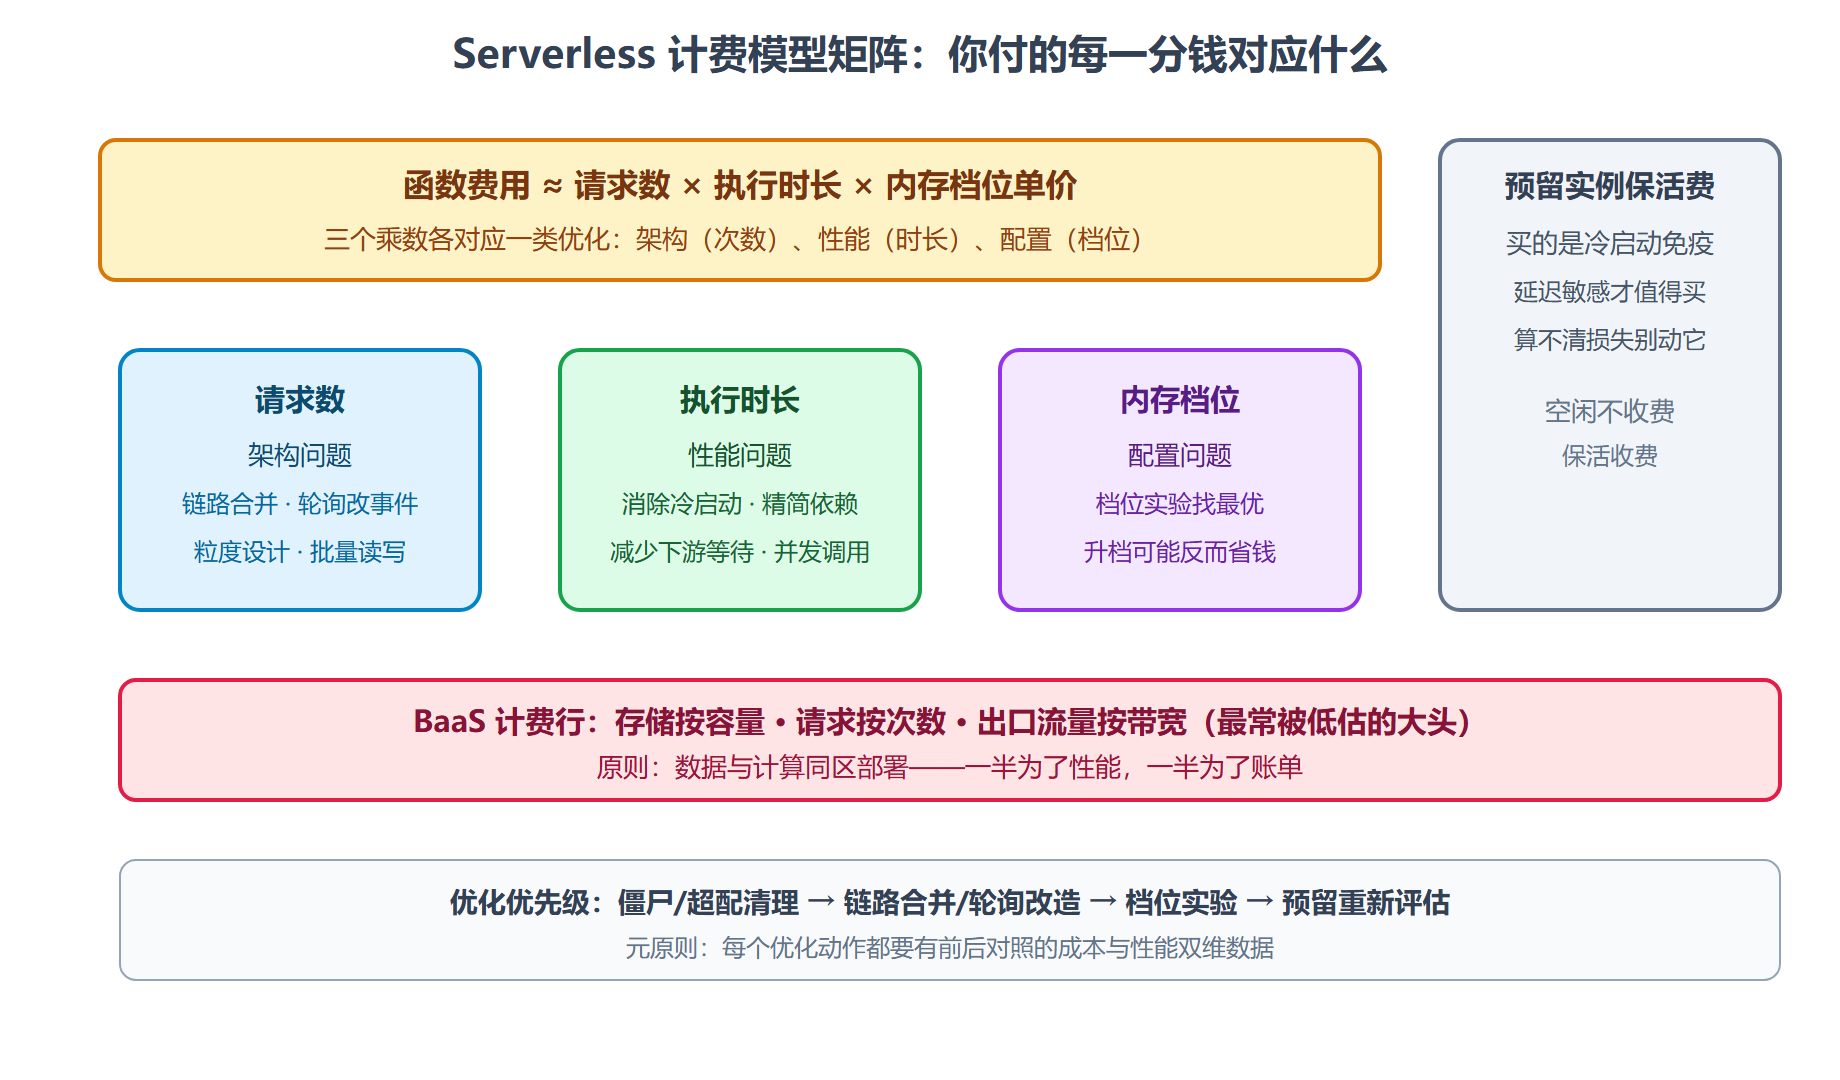
函数本身的计费维度通常是三件事的乘积:请求数(每次调用计一次)、执行时长(按毫秒或百毫秒粒度)、配置的内存档位(内存越高单价越高,通常 CPU 随内存绑定)。这个模型有两个反直觉:其一,内存档位影响的不只是内存——更大的档位意味着更强的 CPU,某些计算型函数升档反而更省(执行时长缩短的比例超过单价上升的比例),这是成本优化里著名的"升档省钱"现象。其二,空闲不收费但"保活"收费——预留实例的保活费是真实的,它买的是冷启动的免疫,值不值取决于首字延迟的业务价值。函数之外,BaaS 的计费各不相同(存储按量、请求按次、出口流量按带宽),出口流量是常被低估的大头——跨区与公网的流量费常常超过计算本身,架构上的"数据与计算同区"原则,一半是性能一半是账单。
把函数计费的三个维度和 BaaS 的计费行放进同一张矩阵,账单结构一眼可读:
图:Serverless 计费模型矩阵
二、四类典型浪费模式
模式一,轮询型浪费
用定时函数高频轮询一个低频变化的数据源(每分钟查一次状态),函数调用数随时间线性堆积,而百分之九十九的调用是空转。治理:改事件驱动(数据源变化时触发),轮询频率按业务时效重新核算——这是架构级的浪费,参数级的调优(降频)只是止血。
模式二,超配型浪费
内存档位随手设成最高("免得不够")、超时设成分钟级("免得被杀"),单次调用的单价虚高数倍。治理:按实测画像(执行时长的分位数、内存的实际峰值)回调档位——成本治理的第一批动作通常就在这里,见效快、风险低(灰度回调观察即可)。
模式三,链路型浪费
A 调 B 调 C 各自收费,而 B 只是转发没有加工——链路上的每一跳都是计费单位,纯转发函数是"过路费"。治理:合并无加工的中转(事件直达)、用平台的编排原语替代自建中转函数——每消除一跳,链路成本降一截、延迟也降一截。
模式四,僵尸型浪费
实验结束但定时触发器还在跑、下线的功能但函数还在被内部系统偶尔调用——僵尸负载的特点是"单日成本不高、全年累积惊人"(每天一元的僵尸,一年三百六十五元乘以僵尸个数)。治理:调用量热力普查(按函数排出调用量排行,低尾逐个确认存废),配"零调用连续三十天"的定期清理机制。
三、优化的优先级排序
成本优化的动作要按"收益确定性除以风险"排序,给一个实践中的推荐次序。第一优先,僵尸与超配清理:收益确定(省下的就是纯利)、风险近零(不影响任何活业务)。第二优先,链路合并与轮询改造:收益中等且持久、风险中等(要动架构,需回归测试)。第三优先,内存档位实验:对计算型函数收益可能显著、但要逐个实验(升档跑分位数对比),风险低但耗时。第四优先,预留与保活的重新评估:这类支出是为延迟体验买的保险,优化它要先量化冷启动的真实业务损失——算不清损失就别动保险。次序之外的一条元原则:每个优化动作都要有前后对照的数据(成本与性能双维度),没数据的优化是占卜——而积累下来的对照数据,会慢慢变成团队的"计费直觉",那是最值钱的副产物。
四、预算告警与成本文化
成本失控的发现速度决定损失量级,预算体系是保险丝。三层预算:月度总预算(超八成告警到负责人)、单服务预算(异常增长在服务粒度暴露——总量正常但结构异常的漂移靠这层)、单日异常检测(环比同比的突增,小时级发现新上的僵尸或泄漏的循环调用)。告警之外的成本文化三条:成本看板进团队周报(可见性是一切治理的前提)、新服务的预算估算进评审(上线前算账而不是账单日惊醒)、优化的对照数据归档成册(把个案变成团队知识)。文化的收尾一句话:成本治理做得好的团队,特征不是花得少,而是说得清——任何一笔显著支出都能指向一段业务价值或一个待治理项,说得清的账本才管得住。
五、成本与性能的合流点
本节的最后把成本与性能放进同一个坐标系:函数计费的"次数乘时长乘档位"里,次数是架构问题(链路与轮询)、时长是性能问题(执行效率与冷启动)、档位是配置问题(超配与实验)——三个维度恰好对应三类优化动作。所以成本治理做深的团队,最后会发现自己的优化动作和性能优化完全合流:消除冷启动既降延迟又降时长费、合并链路既降跳数又降请求数、升档实验在延迟与单价间找最优。这不是巧合——按量计费的本质就是"为资源占用计价",而性能工程的本质就是"减少资源占用",同一枚硬币的两面。把本节与第 2 章的性能内容对照着复习,你会看到全书的一条暗线:好架构的判据,从来都是资源效率这一条——Serverless 只是把它从技术指标翻译成了账单数字,让每个工程师都能读懂。
本节要点回顾
- 计费三维度:次数(架构)、时长(性能)、档位(配置)——优化动作按此对号入座。
- 四类浪费:轮询型、超配型、链路型、僵尸型——识别先于治理,热力普查是第一步。
- 优先级公式:收益确定性除以风险——僵尸清理永远排第一,保险类支出最后动。
- 三层预算:总量、分服务、单日异常——发现速度决定损失量级。
- 合流真相:成本优化与性能优化是同一件事的两面,好架构的判据是资源效率。
六、成本速查表与优化算例
| 维度 | 计费因子 | 典型浪费 | 首选治理 |
|---|---|---|---|
| 次数 | 调用数乘单价 | 高频轮询 纯转发函数 | 改事件驱动 合并链路 |
| 时长 | 执行毫秒乘档位 | 超时配长 慢依赖拖时长 | 超时写实 慢调用异步化 |
| 档位 | 内存档单价 | 无脑高配 | 按画像回调 升档实验 |
| 外围 | 出口流量 BaaS 项 | 跨区读写 公网回流 | 数据计算同区 前缀收敛 |
| 保活 | 预留实例费 | 全量预留过冬 | 按峰谷时段化预留 |
一个优化的账目示例
# 治理前:每分钟轮询一次状态(每天 1440 次起,其中 99% 空转) # schedule: rate(1 minute) → poll_status() # 治理后:状态变化时由源直接触发(每天约 50 次有效事件) # trigger: on_state_change → handle_state(new_state) # 账目对比(示意量级): # 次数费:1440 * 30天 = 43200 次 → 约 50 次/天 # 时长费:每次 300ms 全额计费 → 每次事件 300ms(不变,但次数降 99%) # 月成本降幅 ≈ 99%,同时下游读取压力同比例下降
这个算例展示了成本治理最常见的形态:最大的浪费不在单价里,在调用次数里——架构层的"轮询改事件"一举消掉两个数量级的调用,任何参数级优化(降档、缩依赖)在它面前都是零头。治理从热力普查开始、从头部函数下手,正是因为次数的浪费集中在少数几个模式上——找到它们,账单的骨架就改好了。
七、成本文化的三个仪式
收尾给三个低成本的管理仪式,把成本文化从口号变成日常:周账单五分钟——每周例会固定看一眼成本看板(总量、环比、top 三变化项),变化说不清原因的当场立查;上线前预算栏——新服务的评审表里加一栏"预期月成本与计算依据",算不出账的服务不上线;季度清零日——每季度半天,团队一起过僵尸函数与超配清单,当场处置——集中处置的仪式感比零散的随手改更能维持纪律。三个仪式每月合计不到两小时,买到的是"账本永远说得清"——第 4 小节那句收尾语的落地版本。
收尾再送一个心态:成本数据是中性的镜子——它照出的浪费不是谁的过错(通常是架构演化的自然沉淀),治理的会也不该是追责会;把成本周会开成"我们一起看镜子"的复盘文化,治理动作才有人真心执行——账本是团队的体检报告,不是成绩单,这个定位决定治理能走多远。
最后一句给数字敏感的同学:把月账单的构成做成饼图贴在团队看板上(计算、存储、流量、消息各占几成),每月更新——可视化的构成比任何口号都更能引导注意力(饼图上最大的一块自然会吸引治理的火力);成本治理的最高境界,是全团队看见饼图就知道该干嘛。
再补一条多环境成本提示:非生产环境的成本常占总账单两三成(测试流量、调试日志、遗留资源)——治理动作包括按作息自动缩(非工作时间的资源降配)、调试日志默认关、环境用完即删的标签化追踪;把"环境卫生"纳入成本周的固定检查项,两三成的浪费就有制度性的出口。
最后一句:成本数字会波动、账单会有意外,但"每一笔显著支出都说得清"的团队状态不该波动——治理的终极目标不是最低的账单,是永远透明的那本账;透明之上的优化才叫决策,不透明之下的省钱只是侥幸。
最后补一个多账单场景:跨云或多账号的团队,成本看板要做"聚合视图"——各平台的账单拉通到统一口径(维度对齐、汇率归一),否则"总成本"永远是一笔糊涂账;聚合的实现可以用各平台的账单导出接口加自建汇总,一次搭建持续受益——看得见全局的团队,才配谈全局优化。
最后一句:算例与速查表会在实践中过时(计费粒度在细化、平台在调价),但"把账单拆到能与架构对答"的方法永不过时——每次平台调价后的第一件事就是重跑一次自己的成本沙盘,让模型的分母跟得上平台的分子——账算得勤的团队,永远比账算得巧的团队活得久。