3.7 数据库迁移 Flask-Migrate
3.7 数据库迁移 Flask-Migrate
问题与直觉:表结构会"长大"
开发时 db.create_all() 很方便:建新库一次成型。但生产环境数据库已经有很多数据,此时要加一列 avatar——create_all 不会给已有表加列,你得手写 ALTER TABLE,而每次改动都手写 SQL:记录不清、回滚无门、多人协作混乱。
直觉类比:数据库结构像"软件版本",需要像 Git 一样版本化:每个结构变更是一个"提交"(迁移脚本),可以前进(upgrade)也可以回退(downgrade)。
💡 关键直觉:迁移 = 表结构的版本控制。
upgrade是"应用新版本结构",downgrade是"回到旧版本结构"——每条迁移记录里都写清楚"怎么改"和"怎么撤销"。
迁移流程:结构变更的版本化管理
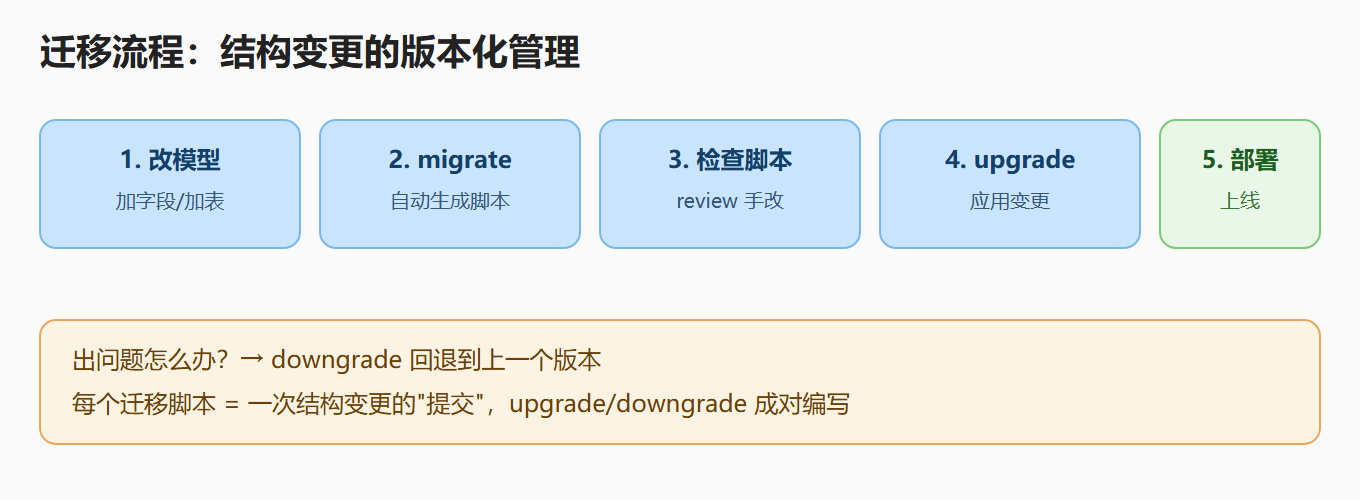
核心原理:Alembic 三步曲
2.1 安装与初始化
pip install flask-migrate
# extensions.py from flask_migrate import Migrate migrate = Migrate() # 工厂中(注意顺序:db 已 init 后) migrate.init_app(app, db)
首次使用需要配置 CLI 入口(配合 flask 命令):
# 应用的 __init__.py 或 wsgi.py 中 from flask_migrate import MigrateCommand # 新版本 flask-migrate 直接用 flask 命令: # export FLASK_APP=wsgi.py
初始化迁移目录:
export FLASK_APP=wsgi.py flask db init # 创建 migrations/ 目录
2.2 生成迁移脚本(migrate)
flask db migrate -m "add avatar column to users"
Alembic 会对比模型与数据库,自动生成迁移脚本 migrations/versions/xxxx_add_avatar_column_to_users.py:
def upgrade(): op.add_column('users', sa.Column('avatar', sa.String(200), nullable=True)) def downgrade(): op.drop_column('users', 'avatar')
关键:脚本是"草稿",必须人工检查——自动生成偶尔会漏(如列重命名会被识别为删+增)。
2.3 应用变更(upgrade)与回滚(downgrade)
flask db upgrade # 应用到最新版本 flask db downgrade # 回退到上一个版本 flask db current # 查看当前版本 flask db history # 查看版本历史
工程实践要点
3.1 上线流程标准动作
- 改
models.py(加字段/新表); flask db migrate -m "描述"生成脚本;- 检查脚本:确认 upgrade/downgrade 都正确;
- 测试库
flask db upgrade验证; - 部署时在生产库执行
flask db upgrade。
3.2 需要手写迁移的场景
| 场景 | 自动生成的问题 | 手写示例 |
|---|---|---|
| 重命名列 | 生成 drop+add(丢数据) | op.alter_column('users','old','new') |
| 添加非空列 | 已有行无值报错 | 先加可空,再 op.execute 填默认值,再改非空 |
| 数据迁移 | 结构变不够,要改数据 | 在 upgrade 里写 op.execute("UPDATE ...") |
| 改默认值 | 自动生成可能忽略 | op.alter_column(... server_default=...) |
示例:给已有 10 万行数据加非空字段
def upgrade(): # 1. 先加可空列 op.add_column('users', sa.Column('nickname', sa.String(80), nullable=True)) # 2. 数据回填 op.execute("UPDATE users SET nickname = username") # 3. 再设非空 op.alter_column('users', 'nickname', nullable=False)
3.3 团队协作
- 迁移脚本要提交进 Git(它是代码的一部分);
- 多人开发时先
flask db upgrade再写代码,避免模型与库脱节; - 冲突时手动合并
migrations/versions里的脚本(很少发生)。
3.4 生产安全注意事项
- 生产 upgrade 前备份数据库;
- 大表加列/建索引可能锁表,选择低峰期执行;
- 迁移失败后先
flask db downgrade恢复,别硬改。
常见误区与排查
| 误区 | 现象 | 正解 |
|---|---|---|
| 生产用 create_all 改表 | 表不变或报错 | 用 Flask-Migrate |
| migrate 后忘 upgrade | 模型和库不一致 | 部署链路里执行 upgrade |
| 不检查自动脚本 | 重命名变删+增、丢数据 | 每次 migrate 后 review |
| 迁移脚本不提交 Git | 换环境跑不了 | 脚本入库 |
| 回滚依赖自动生成 | downgrade 缺失 | 每个脚本成对写 upgrade/downgrade |
| 生产不备份就 upgrade | 失败无路可退 | 先备份 |
动手演练:完整走一遍
# 初始模型 class User(db.Model): id = db.Column(db.Integer, primary_key=True) username = db.Column(db.String(80), unique=True)
# 首次 flask db init flask db migrate -m "init tables" flask db upgrade
# 需求变更:加 email 与 created_at class User(db.Model): id = db.Column(db.Integer, primary_key=True) username = db.Column(db.String(80), unique=True) email = db.Column(db.String(120), unique=True, nullable=True) created_at = db.Column(db.DateTime, default=datetime.utcnow)
# 第二次变更 flask db migrate -m "add email and created_at" flask db upgrade flask db history # 想回退: flask db downgrade
至此,表结构变更变得像 Git 提交一样可追踪、可回滚——这是生产级应用与玩具项目的分水岭。
版本演进的关系可以用一张迁移状态图总结:
重点提炼
- 问题:create_all 只能建新库,改表会丢数据;手写 ALTER 无版本管理。
- 三步曲:
db init(建迁移环境)→db migrate(生成脚本)→db upgrade(应用变更)。 - 回滚:
db downgrade回到上一版本,upgrade/downgrade 成对编写。 - 检查脚本:自动生成是草稿,重命名/非空列/数据迁移需手写。
- 团队协作:迁移脚本入库,先 upgrade 再开发,冲突少见。
- 生产纪律:先备份、低峰执行、失败先回滚。
深入理解:迁移在真实项目中的运作
迁移不是"偶尔跑一下的命令",而是部署流程的一部分,理解它在团队中的运作方式。
第一,迁移与部署的时序。 发布新版本的典型顺序:备份数据库 → 执行 flask db upgrade(结构变更)→ 发布新代码 → 观察日志。先迁移后发码,保证新代码运行时表结构已就位;如果迁移失败,立即 downgrade 回滚,再修复代码。迁移脚本与代码同版本发布——这是"结构与应用版本一致"的保证。
第二,迁移脚本的评审。 迁移脚本是"数据库层面的代码",同样要 review:自动生成的脚本里,是不是有意外 drop 的列?非空列有没有回填逻辑?大表操作会不会锁表?Review 迁移脚本的清单:upgrade/downgrade 成对存在、数据迁移有幂等保护、列变更不会导致数据丢失、索引创建时机合理。把迁移脚本当成一等公民对待,它出错的代价是数据。
第三,多环境迁移的顺序管理。 团队项目里,迁移版本是全局唯一的(Alembic 用 revision id 链管理)。流程:开发环境改模型 → migrate 生成脚本 → 提交代码(含迁移脚本)→ 测试环境 upgrade 验证 → 预发布验证 → 生产 upgrade。任何环境都不要手动改数据库结构——所有变更走迁移,保证环境间结构一致。
第四,数据迁移 vs 结构迁移。 迁移不只改表结构,还能改数据:upgrade 里写 op.execute('UPDATE users SET status=1 WHERE status IS NULL') 做数据回填;用 data_migration 模式处理"结构+数据"联动变更。注意:数据迁移要幂等(重复执行结果一致),最好在事务里执行(Alembic 默认在事务中运行 upgrade)。
第五,回滚的真实代价。 downgrade 不是免费的:删掉一列容易,但数据已经没了就回不来了。所以:涉及删列/删表的迁移,upgrade 前先备份;downgrade 尽量"只回滚结构,不回滚数据"(保留数据列,改 nullable)。"能降级"不等于"能无损降级"——设计迁移时就要考虑回滚路径。
第六,从迁移走向数据库 DevOps。 学会 Flask-Migrate 后可以延伸:CI 里自动跑 migrate check(检测模型与迁移是否一致,防漏提交);上线流程里把"备份→迁移→验证"做成脚本;数据库结构变更纳入变更审批。当"改表"变成一件"有流程、有记录、可回滚"的事,你的应用才真正达到生产级的数据管理水平。