2.1 ndarray 核心概念与数组创建
2.1 ndarray 核心概念与数组创建
本节摘要:ndarray 是 NumPy 的核心数据结构,一个同质、连续内存的多维数组。本节先讲清它为什么比 Python 列表快一个量级,再系统掌握 array、zeros、ones、arange、linspace、random 等创建方法,最后用贯穿案例创建一份订单金额数组。
先说结论
阅读完本节,你应当能够:
- 解释 ndarray 的"同质"与"连续内存"两个特性及其性能含义
- 说出 shape、dtype、ndim、size 四个属性的含义
- 用 array、zeros、ones、full 创建指定结构与数值的数组
- 用 arange、linspace 生成等差与等间隔序列
- 用 random 模块生成随机数组,并设置随机种子复现结果
一、问题与直觉
Python 自带的列表很好用,什么都能装:整数、字符串、列表套列表。但处理十万个订单金额时,用列表做一次整体求和,速度慢得让人怀疑人生。原因藏在实现里:列表里存的是对象的引用,每个元素都是独立的 Python 对象,分散在内存各处,计算时要逐个"解引用"。
NumPy 换了个思路:数组里所有元素必须是同一种类型,并且连续地排在一块内存里。这就好比把散落各处的零件集中装进一个标准化货柜——计算时 CPU 可以直接成块搬运,而不必一个个找。这就是 ndarray 快的根本。
二、核心原理
2.1 ndarray 的内部结构
创建方式可以按用途归成五类,先看全貌再逐个学:
ndarray 内存布局标注图
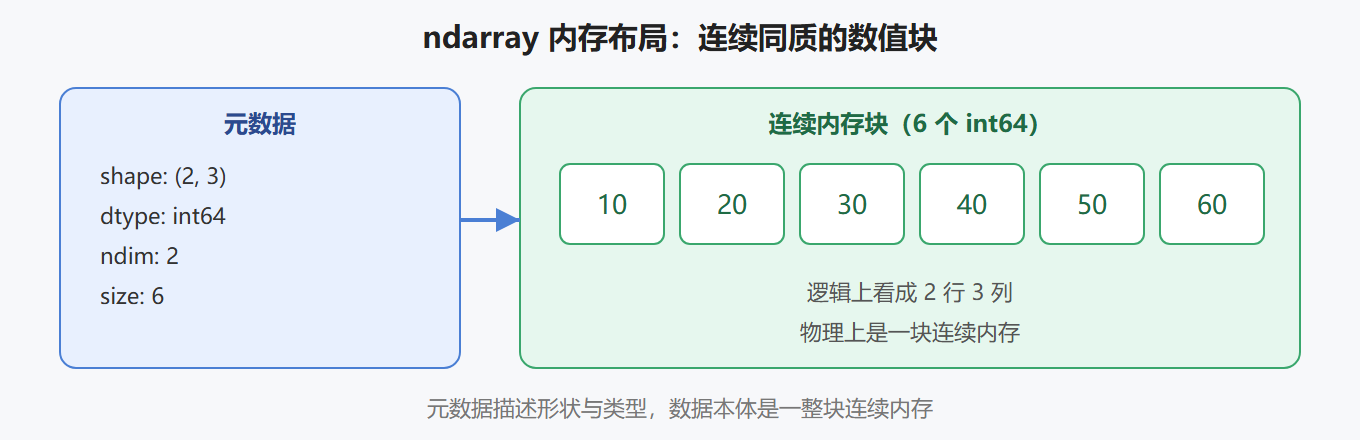
数组对象由两部分组成:元数据(shape 形状、dtype 元素类型、ndim 维数、size 元素总数)和数据缓冲区(实际数值的连续内存块)。理解 shape 和 dtype 是理解一切数组操作的前提。
- shape:各维度的大小。
(2, 3)表示 2 行 3 列,(100,)表示一维 100 个元素 - dtype:元素类型。
int64、float64、bool等,决定每个元素占多少字节 - ndim:维数,即 shape 的长度。标量 0 维、向量 1 维、矩阵 2 维
- size:元素总数,等于 shape 各维相乘
2.2 为什么必须"同质"
同质意味着每个元素占的字节数一样,CPU 可以按固定步长顺序扫描整块内存,SIMD 指令还能一次处理多个元素。如果允许混合类型,就得退回"逐个解引用"的老路。代价是:想往 float 数组里塞字符串会直接报错——这是特性不是缺陷。
三、工程实践要点
3.1 从列表创建数组
import numpy as np # 一维数组 arr1 = np.array([199.0, 89.5, 399.0]) # 二维数组(2 行 3 列) arr2 = np.array([[1, 2, 3], [4, 5, 6]]) # 指定元素类型 arr3 = np.array([1, 2, 3], dtype=np.float64)
⚠️ 常见坑:列表里混着整数和字符串时,NumPy 会"向下兼容"成字符串数组,
np.array([1, "2"])的结果是字符串数组,求和会报错。创建前先确认元素类型一致。
3.2 创建特定结构的数组
np.zeros((2, 3)) # 全 0,2 行 3 列 np.ones((3, 2)) # 全 1,3 行 2 列 np.full((2, 2), 7) # 全部填 7 np.empty((2, 2)) # 未初始化内存(快,但内容不可预期,慎用)
3.3 生成序列与随机数组
np.arange(0, 10, 2) # 等差数列: [0 2 4 6 8] np.linspace(0, 1, 5) # 等间隔 5 个数: [0 0.25 0.5 0.75 1] np.random.rand(2, 3) # [0,1) 均匀分布,2 行 3 列 np.random.randn(3, 3) # 标准正态分布 np.random.randint(1, 100, size=10) # [1,100) 随机整数
💡 关键直觉:
arange是"步长型"(指定起点、终点、步长),linspace是"个数型"(指定起点、终点、个数)。画图坐标轴常用 linspace,因为它能精确控制取多少个点。
3.4 随机种子:让结果可复现
np.random.seed(42) a = np.random.rand(3) np.random.seed(42) b = np.random.rand(3) # a 与 b 完全相同
数据分析里"随机"必须可控。设了同样的种子,随机数序列就完全一样,别人能复现你的实验结果。
3.5 创建方法的选型对照
| 需求 | 推荐方法 | 典型场景 |
|---|---|---|
| 从已有数据转数组 | np.array() |
把列表/元组转成数组 |
| 全 0 / 全 1 占位 | np.zeros() / np.ones() |
预分配结果容器 |
| 等差序列 | np.arange() |
模拟时间步、序号 |
| 等间隔采样 | np.linspace() |
画图坐标点、网格 |
| 随机采样 | np.random.* |
模拟数据、抽样 |
| 指定值填充 | np.full() |
掩码、常量数组 |
3.6 贯穿案例:创建订单金额数组
回到电商场景,把某天 10 笔订单的金额建成数组,顺便看一眼它的属性:
import numpy as np np.random.seed(2026) # 模拟 10 笔订单金额,200 到 500 元之间 amounts = np.random.randint(200, 500, size=10) print("金额:", amounts) print("形状 shape:", amounts.shape) print("类型 dtype:", amounts.dtype) print("元素总数 size:", amounts.size) print("总销售额:", amounts.sum())
输出里能看到形状 (10,)、类型 int64、总和等关键信息。数组已经建好,下一节我们学怎么从里面精确取数。
3.7 二维数组的创建细节
数据分析里二维数组(表)比一维更常见。创建时最容易错的是"行与列的先后":
# 3 行 4 列 m = np.arange(12).reshape(3, 4) # 随机 2 行 3 列 r = np.random.rand(2, 3) # 单位矩阵 eye = np.eye(3)
⚠️ 常见坑:
np.random.rand(2, 3)是 2 行 3 列,但np.random.randint(1, 10, size=(2, 3))的 size 元组也是 (行, 列)——两种写法维度顺序一致,都是"行在前、列在后",别被混用搞晕。shape 输出(2, 3)时读作"2 行 3 列"。
3.8 数据类型的选择
创建数组时,dtype 的选择直接影响内存和精度:
| 类型 | 占用 | 用途 |
|---|---|---|
| int64 | 8 字节 | 默认整数,范围大 |
| int32 / int16 | 4 / 2 字节 | 数据量大的整数,省内存 |
| float64 | 8 字节 | 默认浮点,精度高 |
| float32 | 4 字节 | 内存敏感场景,精度略降 |
| bool | 1 字节 | 掩码、条件标记 |
金额、价格这类需要精度的用 float64 最省心;大规模数据才考虑降级。创建时显式传 dtype,能避免"自动推断结果不是想要的类型"这类隐蔽问题。
3.9 数组与列表的核心差异
| 对比项 | Python 列表 | NumPy 数组 |
|---|---|---|
| 元素类型 | 可混合 | 必须同质 |
| 存储方式 | 对象引用,分散 | 连续内存块 |
| 元素级运算 | 需循环 | 直接支持 |
| 广播 | 不支持 | 原生支持 |
| 切片 | 复制 | 视图(共享数据) |
这五条差异解释了本书反复强调的"能数组就别列表"。特别是最后一条——列表切片是复制、数组切片是视图,修改行为完全不同,第 2 章后面会重点讲。
重点提炼
- 要点一:ndarray 同质且内存连续,是它比列表快一个量级的根本原因
- 要点二:shape 管形状、dtype 管类型、ndim 管维数、size 管总数,四个属性先看 shape
- 要点三:创建数组四件套——array 转、zeros/ones/full 造、arange/linspace 排、random 随
- 要点四:
arange按步长、linspace按个数,画图坐标用后者更稳 - 要点五:
np.random.seed()让随机结果可复现,实验必设 - 要点六:创建时注意元素同质,混类型会被悄悄转成字符串数组
数组建好了,下一步就是取数——下一节我们把索引、切片、花式索引和布尔索引四种取法一次讲透。