第6章 · 高级技巧与最佳实践
第 6 章 · 高级技巧与最佳实践
章节摘要:前五章解决"怎么把数据处理好",本章解决"数据变大、流程变复杂后怎么办"。内容覆盖大规模数据的内存优化、时间序列处理、可复用的数据处理管道与工程化习惯,最后用 FAQ 汇总全书高频坑。学完本章,你的数据处理能力从"能跑"升级为"能上规模、能复用、能交付"。
本节地图
阅读完本章,你应当能够:
- 用分块读取、类型优化等手段处理超大文件
- 处理时间序列:时间索引、重采样、滑动窗口
- 设计可复用、可测试的数据处理管道
- 把版本控制、文档、测试纳入日常工作流
- 快速定位并解决常见数据处理报错
核心概念速览
一句话记住本章:能处理 10 万行的代码和能处理 1 亿行的代码,差的不只是内存,而是从一开始就以"可复用、可重跑"为目标来写。
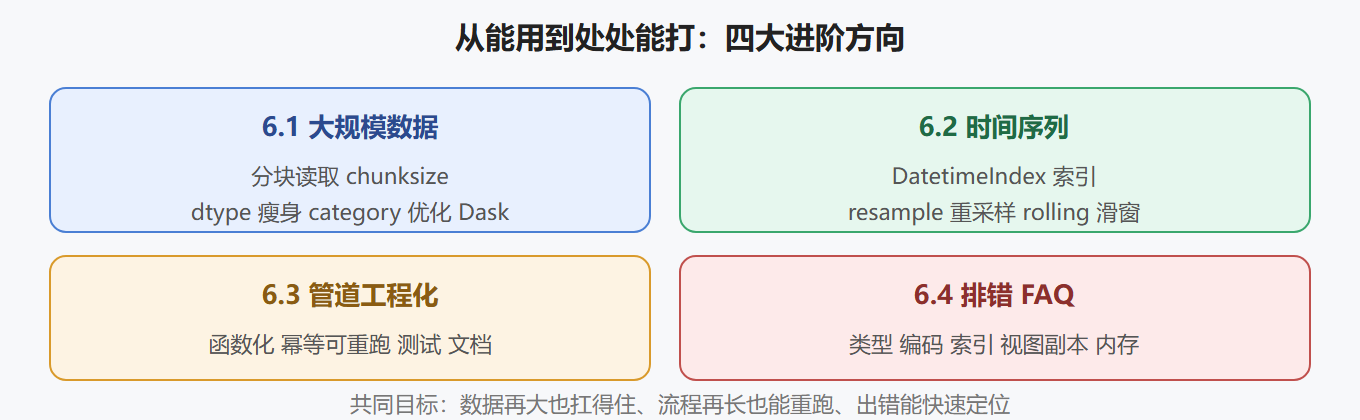
高级技巧全景图
子章节导航
6.1 大规模数据与内存优化
分块读取、数据类型瘦身、category 优化、用 Dask 处理超大数据。
6.2 时间序列数据处理
时间索引、resample 重采样、rolling 滑动窗口、周期特征提取。
6.3 数据处理管道与工程化
把清洗分析固化成管道函数,配合版本控制、单元测试与文档,形成工程化习惯。
6.4 常见坑与排错 FAQ
汇总全书高频错误与排查思路:类型、编码、索引、视图副本、内存等。
子章节之间的逻辑关系
数据变大(6.1) → 时间维度(6.2) → 流程固化(6.3) → 排错兜底(6.4) 扩容能力 新增维度 工程化交付 防坑手册
前三节从"数据、维度、流程"三个角度把能力升级,最后一节是全书排错的速查手册。
前置知识与后续延伸
- 前置:前五章全部内容——本章是它们的"生产环境版"
- 为后续延伸:管道与工程化习惯是进入机器学习建模(特征工程、训练流程)的前置;时间序列处理是预测类项目的入场券
实战建议与常见坑
本章是"从学生代码到工程代码"的过渡,练习重点从"会"转向"稳":
- 6.1 应对规模:找一份大一点的 CSV,实测分块读取与 dtype 瘦身的内存变化,让"优化有效"变成看得见的数字
- 6.2 处理时间:把订单数据按月重采样、算 7 日移动平均、比较周末与工作日,跑通完整时序流程
- 6.3 固化流程:把 4.4 的清洗函数升级为带配置、带日志、带测试的管道,这是本章最有价值的产出
- 6.4 建立习惯:把排错 FAQ 当作工具书,遇到报错先翻表再搜索
三个高频坑提前标记:高基数列别转 category(反而更占内存)、时间切片含头含尾(与普通切片不同)、管道不幂等(inplace 改输入是元凶)。前两个是技术细节,第三个是工程习惯——把"可重跑"刻进潜意识,是所有后续项目的地基。
本章验收标准:能把前面五章的任何一段分析,改造成"输入文件 → 干净数据 → 结果"的可复用管道,并且能讲清楚每步为什么这么做。
评论区
(0)
U