5.4 综合 EDA 实战:电商订单数据
5.4 综合 EDA 实战:电商订单数据
本节摘要:把前面所有技能串成一次完整实战——以电商订单数据为例,走完"造数据 → 清洗 → 概览 → 单变量 → 双变量 → 关联 → 洞察"全流程。本节是本章的验收场,也是全书前半段的综合演练,读完后你应能独立复现这套分析思路。
学习目标
阅读完本节,你应当能够:
- 独立完成一次完整的 EDA 全流程
- 在实战中正确选择清洗与绘图工具
- 从图表与统计中提炼可验证的业务洞察
- 用一段代码串起"数据到结论"的完整链路
一、问题与直觉
纸上谈兵到此为止。这一节我们手握一份模拟的电商订单数据(含订单号、日期、门店、类目、金额、客单价、折扣、订单量共 8 列),业务问题是:这个月的销售靠什么撑起来?下一步该优化什么? 带着问题走完整条链路,你会发现前面学的每个技能都有落点。
二、核心原理
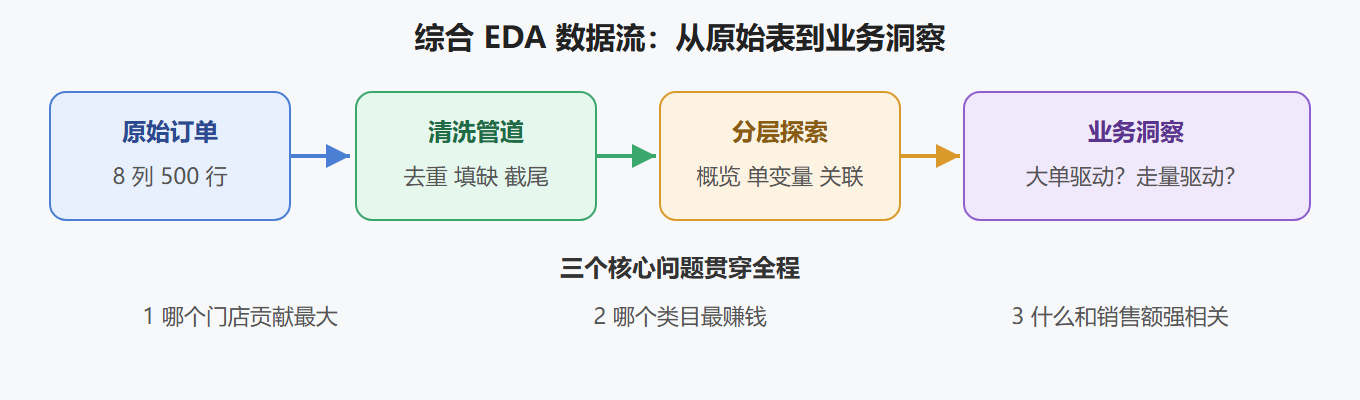
2.1 实战分析的数据流
整条实战链路分六步,每一步的产出都是下一步的输入:
💡 关键直觉:这份数据的"结构性特征"是金额右偏——少数大单贡献了不成比例的销售额。后面所有分析都在验证这个特征在不同维度下的表现。
综合 EDA 数据流图
三、工程实践要点
3.1 造数据并清洗
import pandas as pd import numpy as np np.random.seed(42) n = 500 df = pd.DataFrame({ "订单号": [f"O{i:04d}" for i in range(n)], "门店": np.random.choice(["北京", "上海", "广州", "深圳"], n), "类目": np.random.choice(["数码", "家电", "服装", "食品"], n), "金额": np.random.lognormal(5, 0.8, n).round(2), # 右偏分布 "客单价": np.random.randint(50, 500, n), "折扣": np.random.uniform(0.7, 1.0, n).round(2), "订单量": np.random.randint(1, 10, n), }) # 造几个脏数据再清洗,验证管道 df.loc[3, "金额"] = np.nan df = df.drop_duplicates(subset=["订单号"]) df["金额"] = df["金额"].fillna(df["金额"].median()) print(df.shape)
3.2 概览:先看整体
df.info() df.describe().round(2)
金额的 mean 明显大于 median(右偏),说明存在大额订单拉动均值——第一层概览已经有故事了。
3.3 单变量:看分布
import matplotlib.pyplot as plt import seaborn as sns fig, axes = plt.subplots(1, 2, figsize=(11, 4)) sns.histplot(df["金额"], kde=True, ax=axes[0]) axes[0].set_title("金额分布(右偏)") sns.boxplot(y=df["金额"], ax=axes[1]) axes[1].set_title("金额箱线图") plt.tight_layout() plt.show()
右偏分布 + 箱线图上方的离群点:少数大单撑起了相当比例的销售额——这是本份数据最重要的结构性特征。
3.4 双变量:组间对比
fig, axes = plt.subplots(1, 2, figsize=(11, 4)) sns.barplot(data=df, x="门店", y="金额", estimator="sum", ax=axes[0]) axes[0].set_title("各门店总销售额") sns.boxplot(data=df, x="类目", y="金额", ax=axes[1]) axes[1].set_title("各类目金额分布") plt.tight_layout() plt.show()
门店维度看"谁贡献大",类目维度看"谁单价高、谁波动大"。
3.5 关联:看相关性
corr = df[["金额", "客单价", "折扣", "订单量"]].corr() sns.heatmap(corr, annot=True, cmap="coolwarm", fmt=".2f") plt.title("数值特征相关矩阵") plt.show()
重点观察:金额与客单价、订单量的相关系数——哪个更接近 1,说明销售额主要由哪个因素驱动。
3.6 洞察输出
# 各门店销售额与占比 sales_by_store = df.groupby("门店")["金额"].sum().sort_values(ascending=False) print(sales_by_store) print("Top1 门店占比:", (sales_by_store.iloc[0] / sales_by_store.sum()).round(2))
至此业务问题有了答案:销售靠哪家门店、哪个类目、哪个因素驱动,都有数据支撑。把这些结论写进报告,就是一次完整的 EDA 交付。
⚠️ 常见坑:EDA 结论是"探索性"的,不是因果证明。观察到"折扣与金额负相关"不等于"折扣导致金额下降"——可能是高折扣商品本身便宜。表述时用"相关"而非"导致"。
3.7 实战检查单
| 步骤 | 产出 | 本案例结论示例 |
|---|---|---|
| 清洗 | 干净表 | 缺失 0、重复 0 |
| 概览 | 结构认知 | 金额右偏,均值高于中位数 |
| 单变量 | 分布图 | 少数大单占比高 |
| 双变量 | 对比图 | 某门店销售额领先 |
| 关联 | 热力图 | 金额与客单价相关更强 |
| 洞察 | 业务结论 | 优化重点 = 大单运营 |
3.8 延伸一:类目维度分析
业务问题"哪个类目最赚钱",拆成两步:类目总销售额 + 类目客单价。
# 类目销售额排名 cat_sales = df.groupby("类目")["金额"].sum().sort_values(ascending=False) print(cat_sales) # 类目客单价 cat_price = df.groupby("类目")["客单价"].mean().sort_values(ascending=False) print(cat_price)
销售额高但客单价低的类目(如食品)靠走量,销售额一般但客单价高的类目(如数码)靠单价——两个指标交叉看,才能判断类目的盈利模式。
3.9 延伸二:折扣与销售的关系
"打折到底有没有用"是业务最爱问的问题之一:
# 折扣分档 df["折扣档"] = pd.cut(df["折扣"], bins=[0, 0.8, 0.9, 1.0], labels=["大促", "常规", "原价"]) # 各档平均销售额与订单量 print(df.groupby("折扣档", observed=True).agg( 销售额=("金额", "sum"), 订单量=("订单量", "sum") ))
pd.cut 把连续折扣切成档位,再分组看各档表现。注意这里的结论是"相关"而非"因果"——大促档的订单量高,可能因为促销期间流量大,也可能是打折本身拉动,单靠这组数据无法区分。
3.10 实战总结模板
完成 EDA 后,用统一模板收尾,结论就能直接进报告:
数据概况:500 行 8 列,清洗后无缺失无重复 关键发现 1:金额右偏,前 20% 大单贡献约 X% 销售额 关键发现 2:北京门店销售额领先,广州客单价最高 关键发现 3:金额与客单价强相关,与折扣弱负相关 业务建议:运营重心放在大单维护与高客单门店 待验证:折扣对复购的影响需要更长周期数据
"数据概况 + 关键发现 + 业务建议 + 待验证"四段式,是数据团队内部对齐和向业务汇报的标准结构。
要点串联
- 要点一:完整 EDA = 造数据 → 清洗 → 概览 → 单变量 → 双变量 → 关联 → 洞察
- 要点二:右偏分布是金额类数据的常态,均值与中位数差异本身就有信息量
- 要点三:分组汇总(groupby + sum)配合条形图,直接回答"谁贡献最大"
- 要点四:相关矩阵的数值要结合业务解读,别把相关当因果
- 要点五:箱线图的离群点提示"大单效应",是分析要点而非待删错误
- 要点六:洞察表述用"相关"不用"导致",保持探索性分析的严谨
从数据到洞察的完整链路已经打通。最后一章把这一切固化下来——大规模数据、时间序列、处理管道与工程化,以及那些绕不开的坑。