2.3 向量化运算与广播机制
2.3 向量化运算与广播机制
本节摘要:向量化是用数组整体运算替代 Python 循环,把慢吞吞的逐元素处理变成底层 C 语言的批量计算,速度常快几十到上百倍。广播机制则让不同形状的数组也能直接运算。本节讲透"为什么快、怎么对齐、有什么坑",并给出判断能否广播的规则。
本节地图
阅读完本节,你应当能够:
- 解释向量化运算的性能来源,说出它与 for 循环的本质区别
- 熟练写出元素级运算、比较运算与聚合统计的向量化代码
- 陈述广播的维度对齐规则,判断任意两个形状能否广播
- 避开广播的经典误区,说出什么时候该主动 reshape
- 用
%timeit直观对比向量化与循环的速度差距
一、问题与直觉
同样的"给每个订单金额加 10 元运费",用 for 循环写和用数组整体加,结果一样,速度天差地别。十万个元素时,循环要执行十万次 Python 解释器指令,而 amounts + 10 只触发一次底层批量运算,Python 解释器完全不参与逐元素过程。数据量越大,差距越离谱——这正是数据科学"必须用 NumPy"的原因。
二、核心原理
2.1 向量化:把循环交给 C 语言
向量化与循环是两条完全不同的执行路径:
Python 的 for 循环每迭代一次都要走一遍解释器,慢在"解释"本身。NumPy 的向量化运算把整个数组交给底层用 C 写的核心例程,一次遍历完成所有元素的计算,还能利用 CPU 的 SIMD 指令一次处理多个元素。写向量化代码,等于告诉 NumPy"整体算",而不是"逐个算"。
2.2 广播:形状不同也能算
广播(broadcasting)是 NumPy 在运算时自动"拉伸"小数组来匹配大数组的机制。规则只有一条核心:从最后一个维度往前对齐,要么相等,要么其中一个为 1,要么缺维。
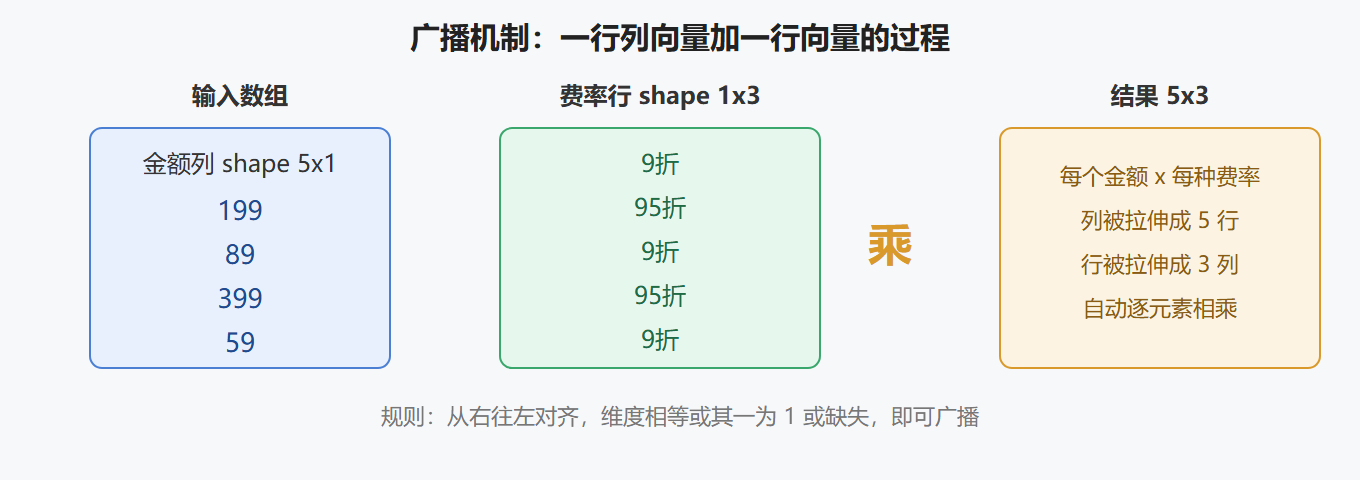
举例:形状 (5, 1) 的列向量与形状 (1, 3) 的行向量相加,结果为 (5, 3)——列被复制到 5 行,行被复制到 3 列,逐元素相加。整个过程中 NumPy 并没有真的复制数据,而是用步长技巧模拟拉伸,内存开销极小。
三、工程实践要点
3.1 元素级运算
import numpy as np amounts = np.array([199, 89, 399, 59, 1299, 45]) amounts + 10 # 每笔加 10 元运费 amounts * 0.95 # 每笔打 95 折 amounts ** 2 # 平方 np.sqrt(amounts) # 开方 np.log1p(amounts) # log(1+x),常用于金额这类右偏数据
3.2 比较与聚合
amounts > 300 # 布尔数组 (amounts > 100).sum() # 超过 100 的有几笔 amounts.mean() # 客单价 amounts.std() # 金额标准差 np.percentile(amounts, 75) # 75 分位数 amounts.argmax() # 最大金额的下标 amounts.max(), amounts.min() # 最高与最低
💡 关键直觉:
(amounts > 100).sum()是"满足条件计数"的标准写法——布尔值相加就是计数,不需要再写循环。
3.3 向量化 vs 循环的实测对比
import timeit big = np.random.rand(1_000_000) # 循环版本 def loop_sum(arr): s = 0.0 for x in arr: s += x return s print(timeit.timeit(lambda: loop_sum(big), number=5)) print(timeit.timeit(lambda: big.sum(), number=5))
在绝大多数机器上,向量化的 big.sum() 会比纯 Python 循环快几十倍以上。数据规模越大,差距越悬殊。
3.4 判断能否广播
# 以下都能广播 (5, 3) 与 (3,) # 缺维补齐 (5, 3) 与 (5, 1) # 第二维为 1 (5, 1) 与 (1, 3) # 两边都拉伸 # 以下不能广播,报错 (5, 3) 与 (4,) # 3 与 4 不相等且都不为 1
⚠️ 常见坑:
(5, 3)与(4,)相加会报错,因为从右往左对齐时 3 和 4 既不相等也没有 1。这时要看业务上想怎么对齐,主动用reshape或newaxis补维,而不是让 NumPy 猜。
3.5 广播的经典实战:归一化
把一列金额缩放到 0 到 1 之间,是机器学习前的标准操作,用广播一行搞定:
amounts = np.array([199, 89, 399, 59, 1299, 45]) min_v, max_v = amounts.min(), amounts.max() normalized = (amounts - min_v) / (max_v - min_v) # 结果在 0 到 1 之间
amounts - min_v 是标量广播,(max_v - min_v) 也是标量,整行代码没有任何显式循环。
3.6 何时别用向量化
向量化不是银弹:形状完全无法对齐、逻辑依赖前一个元素(如累进折扣)、需要逐行判断分支时,强行向量化会写出晦涩难懂的代码。此时用循环或 np.vectorize 反而更清晰。工程上先求正确,再谈性能。
3.7 条件判断的向量化:where 与 clip
数据分析里"按条件取不同值"的需求极多,向量化版本比循环干净得多:
# 满 300 减 50,不满则原价 final_price = np.where(amounts >= 300, amounts - 50, amounts) # 把金额限制在 100 到 1000 之间 clipped = np.clip(amounts, 100, 1000) # 大于 300 记为"大单",否则"普通单" tag = np.where(amounts > 300, "大单", "普通单")
💡 关键直觉:
np.where(条件, 为真值, 为假值)是"向量化 if-else"。写习惯后,几乎所有"对每行做判断"的需求都能用它一行解决,既快又不需要循环。
3.8 常用通用函数(ufunc)一览
NumPy 的数学函数大多支持数组整体运算,选几个最常用的:
| 类别 | 函数 |
|---|---|
| 幂与指数 | np.sqrt、np.power、np.exp |
| 对数 | np.log、np.log1p、np.log2 |
| 三角函数 | np.sin、np.cos、np.tan |
| 舍入 | np.round、np.floor、np.ceil |
| 符号 | np.abs、np.sign |
| 聚合 | sum、mean、std、min、max |
金额类数据常用 log1p(log 加一)压缩右偏;特征工程里 abs、sign 也经常出场。需要时回来查表即可。
3.9 广播的边界:何时该显式补维
广播自动进行,但"自动"不等于"符合业务"。看这个场景:有 3 个门店、每店 4 天销售额的 (3, 4) 矩阵,想给每行乘一个"门店系数",系数是一维 (3,) 数组。直接乘,NumPy 会把它当列(4 长度对不上 3 长度会报错或错位):
sales = np.arange(12).reshape(3, 4) # 3 店 4 天 coef = np.array([1.0, 1.2, 0.9]) # 每店系数 # 报错:无法广播 (3,4) 与 (3,) # sales * coef # 正确:补成列向量 (3,1) sales * coef.reshape(-1, 1)
reshape(-1, 1) 把一维变列,广播就能按行对齐。判断不出对齐方向时,先想清楚"每个元素该和谁乘",再决定要不要补维。
要点串联
- 要点一:向量化把循环交给 C 语言批量处理,速度可快几十倍,数据越大越明显
- 要点二:广播规则——从右往左对齐,相等或其一为 1 或缺失即可
- 要点三:
(条件).sum()是条件计数标准写法,布尔相加即计数 - 要点四:归一化
(x - min) / (max - min)是标量广播的典型应用 - 要点五:形状对不上时主动 reshape 补维,别让程序报错猜
- 要点六:依赖前值、强分支逻辑时别硬向量化,清晰优先
算得飞快之后,还需要把数组摆成想要的形状、把多段数据拼起来——下一节讲数组重塑、组合与统计实战。