2.2 索引切片与高效取值
2.2 索引切片与高效取值
本节摘要:会建数组还不够,关键是从数组里精确、高效地取数。本节系统讲透基本索引、切片、花式索引、布尔索引四种取法,并重点辨析"视图与副本"这一最容易踩的坑——搞懂它,你才能放心地对数据做任何修改操作。
核心问题
阅读完本节,你应当能够:
- 用基本索引与负索引取到任意位置的元素
- 用切片取出子数组,理解步长参数的用法
- 用花式索引按索引列表取任意行或列
- 用布尔索引按条件过滤数据
- 区分视图与副本,说清什么时候修改会"传染"到原数组
一、问题与直觉
数据到手后的第一件事几乎都是"取数":想看看前 3 个订单金额、想筛出金额超过 300 的订单、想单独取某一列……如果每次取数都要写循环判断,代码又长又慢。NumPy 提供了四种取法,各有用武之地,但其中"视图 vs 副本"的陷阱,让无数新手在不知情时改坏了原始数据。
二、核心原理
2.1 四种索引方式对比
取值之前先想清楚"要单个、要一段、要任意、还是按条件",再选工具:
四种索引方式对比图
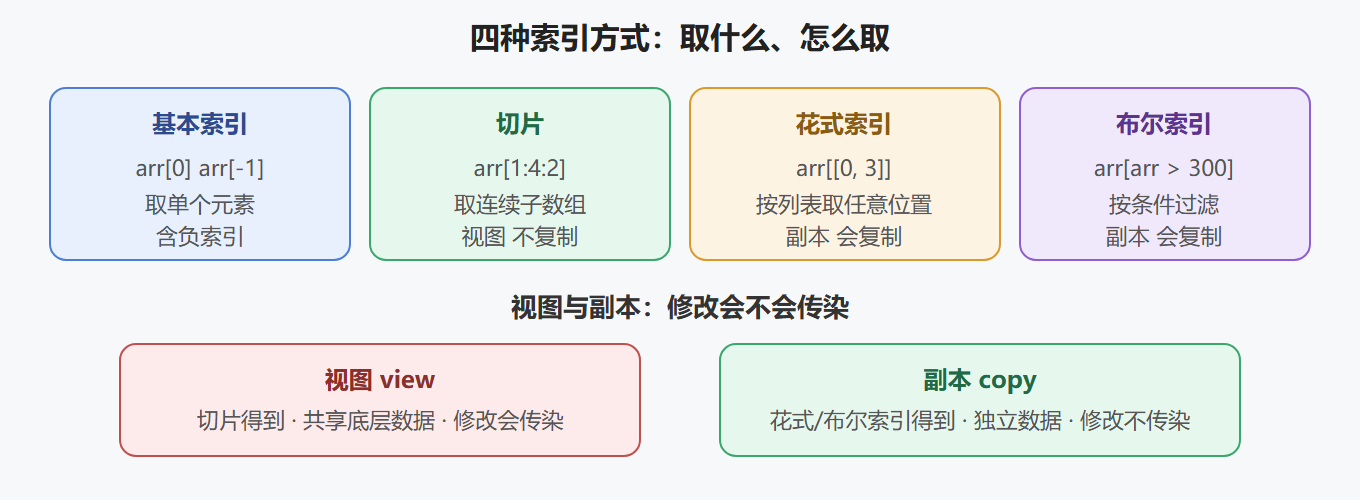
四种取法的本质区别在于返回值是视图(view,共享底层数据)还是副本(copy,独立数据):
- 切片返回视图:
arr[1:4]得到的子数组与原数组共享内存,改子数组会改原数组 - 花式索引、布尔索引返回副本:取出来的数据独立,随便改不伤原数组
- 基本索引返回标量或降维后的视图
⚠️ 常见坑:切片是视图这个特性最坑人。想"先复制一份慢慢改"时,如果直接
sub = arr[1:4]然后修改 sub,原始数据 arr 也被改了,排查半天找不到原因。要复制就显式调用.copy()。
三、工程实践要点
3.1 基本索引与负索引
import numpy as np amounts = np.array([199, 89, 399, 59, 1299, 45]) amounts[0] # 第一个元素 199 amounts[-1] # 最后一个元素 45 amounts[-2] # 倒数第二个 1299
二维数组用逗号分隔维度:matrix[0, 1] 表示第 0 行第 1 列。
3.2 切片:起止与步长
amounts[1:4] # 下标 1 到 3,即 [89 399 59] amounts[:3] # 前 3 个 amounts[::2] # 隔一个取一个 amounts[::-1] # 反转数组
💡 关键直觉:切片语法是"含头不含尾",
arr[1:4]取不到下标 4。这个约定和 Python 列表一致,写循环切片时尤其容易差一,记住"左闭右开"四个字。
3.3 花式索引:按列表取任意位置
amounts[[0, 2, 4]] # 取第 0、2、4 个元素 idx = [3, 1, 5] amounts[idx] # 按索引列表顺序取 # 二维:同时指定行列 matrix = np.arange(12).reshape(3, 4) matrix[[0, 2], [1, 3]] # 取 (0,1) 和 (2,3) 两个元素
3.4 布尔索引:条件过滤
# 筛出超过 300 元的订单 high = amounts[amounts > 300] # 筛出 100 到 500 之间 mid = amounts[(amounts >= 100) & (amounts <= 500)]
布尔索引内部先产生一个布尔掩码数组,再取出为 True 的位置。组合条件时注意:用 &(与)、|(或)而不是 Python 的 and、or,并且每个条件都要加括号。
⚠️ 常见坑:写
amounts[amounts > 300 and amounts < 500]会报错。NumPy 数组的布尔组合必须用&、|、~,且各条件用括号包起来,否则优先级混乱。
3.5 视图与副本的确认
sub = amounts[1:4] # 视图 sub[0] = 999 print(amounts) # 原数组也被改了! safe = amounts[1:4].copy() # 副本 safe[0] = 888 print(amounts) # 原数组不受影响
判断返回值是视图还是副本,可以比较 np.shares_memory(a, b),或者直接看修改是否传染。
3.6 选型速查
| 取数需求 | 用哪种 | 是否复制 |
|---|---|---|
| 取单个元素 | 基本索引 | 否 |
| 取一段连续区域 | 切片 | 否(视图) |
| 取任意几个位置 | 花式索引 | 是 |
| 按条件过滤 | 布尔索引 | 是 |
| 想安全地复制一份再改 | 任意取法后 .copy() |
是 |
3.7 二维数组的索引实战
二维数组的索引是"行、列"逗号分隔,配合前面四种方式组合出无穷取法:
m = np.arange(12).reshape(3, 4) m[1, 2] # 第 1 行第 2 列:6 m[1] # 第 1 行整行 m[:, 2] # 第 2 列整列(冒号代表全部行) m[0:2, 1:3] # 前 2 行、第 1 到 2 列 m[m > 5] # 所有大于 5 的元素(展平成一维) m[[0, 2], :] # 第 0 和 2 行
💡 关键直觉:
m[:, 2]里的冒号是"这一维全要"的意思。分析表格数据时"取某列"是最频繁的操作,[:, 列号]这个写法必须记牢。布尔索引的结果是一维数组,因为筛选出来的行天然不平整,NumPy 统一展平。
3.8 修改数据的正确姿势
索引不只是"取",也用于"改":
amounts[0] = 999 # 改单个元素 amounts[1:3] = [100, 200] # 改一段 amounts[amounts < 100] = 0 # 把所有低于 100 的置 0 # 二维:整列赋值 m[:, 1] = 0
布尔索引赋值是"批量条件更新"的标准写法,比循环判断高效得多。但切记:先搞清楚目标是视图还是副本,改视图会波及原数组,改副本则不会。不确定时,用 np.shares_memory(a, b) 验证一下最稳妥。
3.9 索引性能与习惯
- 逐元素访问
arr[i]是 Python 层操作,慢;整段切片和布尔索引是底层批量操作,快 - 循环里反复索引同一个数组,先把要用的部分切片出来再算
- 大规模过滤优先布尔索引,别写成"循环 + if"——那是把 NumPy 当列表用
本章回顾
- 要点一:四种取法——基本、切片、花式、布尔,按"取单个/取一段/取任意/按条件"选择
- 要点二:切片是视图,修改会传染原数组;花式索引和布尔索引是副本
- 要点三:要独立副本就显式
.copy(),别赌运气 - 要点四:切片左闭右开,
arr[1:4]含 1 不含 4 - 要点五:布尔条件组合用
&、|且各条件加括号,不能用and/or - 要点六:
arr[::-1]反转数组,arr[::2]隔一取一,步长为负时倒序
取数会了,接下来是本教程最值钱的一节——向量化运算与广播机制,学完你写的代码会快得连自己都惊讶。