6.3 数据处理管道与工程化
6.3 数据处理管道与工程化
本节摘要:分析代码从"能跑"到"能交付",差的是工程化:把散落的步骤封装成管道函数、用幂等保证可重跑、用测试守住正确性、用文档记录决策。本节给出数据管道设计的完整方法论与落地模板,让你的数据处理流程真正可以被团队使用。
先说结论
阅读完本节,你应当能够:
- 把数据处理步骤封装成模块化的管道函数
- 说明管道"幂等可重跑"的含义与实现方法
- 为关键处理函数编写简单单元测试
- 建立文档与版本控制习惯
- 设计一个"输入文件 → 干净数据 → 分析结果"的完整管道
一、问题与直觉
很多数据项目死在一个共同点上:分析完了,但过程无法复现。三个月后数据更新,得重新看一遍代码才能想起来当时为什么填中位数而不是均值;同事接手,对着一个几百行的 Notebook 无从下手。工程化的本质不是"写得多高级",而是让流程可复用、结果可复现、错误可定位——这对个人和团队都是生产力。
二、核心原理
2.1 管道的本质:拆解与串联
管道设计围绕三个问题展开:拆成几段、每段做什么、段间怎么衔接:
⚠️ 常见坑:管道最常见的失败是"重跑结果不一致"。inplace 修改入参、读全局变量、随机数没设种子是三大元凶——写管道时默认走"纯函数"风格,输入输出都显式传递。
数据处理管道把"原始数据 → 结果"拆成若干职责单一的阶段,每个阶段一个函数,按顺序串联。好处有三:单阶段可单独测试、可复用、出错范围小。这与 4.4 的清洗管道一脉相承,本节把它扩展为包含分析的全流程。
2.2 管道架构图
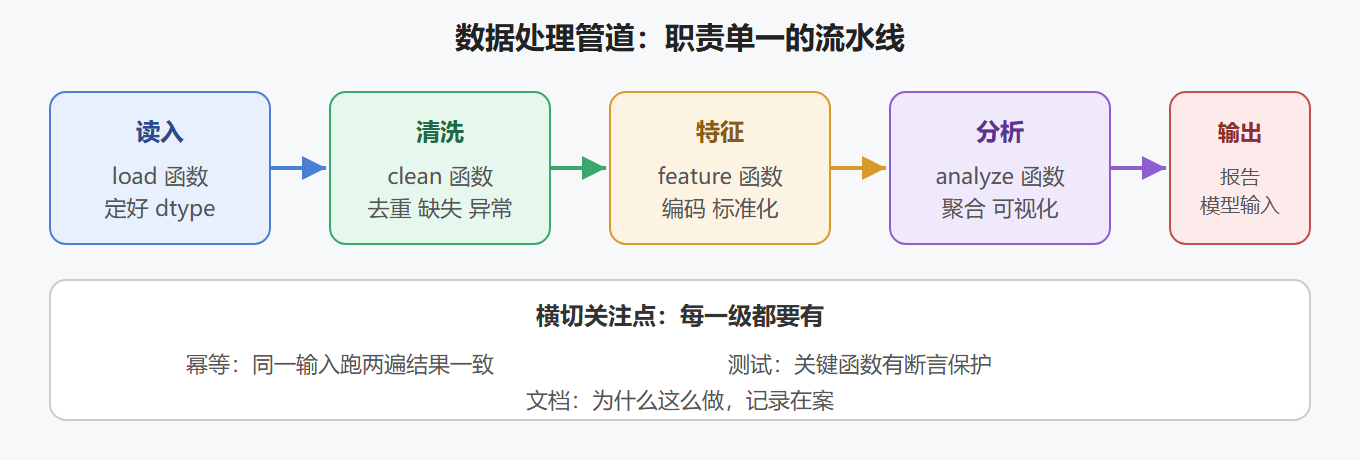
三、工程实践要点
3.1 管道函数模板
def load_data(path): """读入原始数据,指定列类型。""" return pd.read_csv(path, dtype={"门店": "category"}, parse_dates=["日期"]) def clean_orders(df): """清洗:去重 → 缺失 → 异常截尾,返回干净表。""" df = df.drop_duplicates(subset=["订单号"]) df["金额"] = pd.to_numeric(df["金额"], errors="coerce") df["金额"] = df["金额"].fillna(df["金额"].median()) q3 = df["金额"].quantile(0.75) iqr = q3 - df["金额"].quantile(0.25) df["金额"] = df["金额"].clip(upper=q3 + 1.5 * iqr) return df def analyze(df): """分析:按门店汇总并返回排名。""" return df.groupby("门店")["金额"].sum().sort_values(ascending=False) # 主流程:一链到底 df = clean_orders(load_data("orders.csv")) result = analyze(df)
每个函数只做一件事,参数只有"输入 DataFrame → 输出 DataFrame",这就是可复用管道的骨架。
💡 关键直觉:管道函数统一"DataFrame 进、DataFrame 出"的接口,主流程就是一行行函数调用——读起来像说明书,测试起来单个函数独立验证。
3.2 幂等:同一输入跑两遍结果一致
df1 = clean_orders(raw) df2 = clean_orders(raw) assert df1.equals(df2), "管道不幂等"
管道不幂等的常见元凶:用 inplace=True 改入参、依赖全局状态、用了不设种子的随机数。保持"纯函数"风格(不改输入、不读全局)天然幂等。
3.3 单元测试
def test_clean_orders(): raw = pd.DataFrame({ "订单号": ["A001", "A001", "A002"], "金额": [199, 199, None], }) out = clean_orders(raw) assert len(out) == 2 # 去重生效 assert out["金额"].isnull().sum() == 0 # 缺失填满 print("clean_orders 测试通过") test_clean_orders()
关键处理函数配一段断言测试,改动代码时跑一遍就知道有没有改坏。这是"可交付"与"能跑"的分水岭。
3.4 文档与版本控制
- 文档:在管道函数 docstring 里写清"输入是什么、做了什么、为什么这么做"(尤其填充策略)
- 版本控制:用 git 管理代码与数据处理脚本,数据变更、代码变更都可追溯
- 数据字典:记录每列的含义、类型、允许取值范围,团队共享
3.5 工程化习惯速查
| 习惯 | 作用 | 落地方式 |
|---|---|---|
| 函数化 | 可复用、可测试 | 职责单一函数 |
| 幂等 | 可重跑 | 不改输入、不读全局 |
| 单元测试 | 守住正确性 | 关键函数断言 |
| 文档 | 决策可追溯 | docstring + 数据字典 |
| 版本控制 | 变更可回滚 | git 管理 |
| 常量集中 | 参数可调 | 配置集中定义 |
3.6 管道的参数化与配置
管道函数里的魔法数字(阈值、窗口、填充值)应提成参数或配置:
class OrderConfig: """订单清洗与分析的集中配置。""" AMOUNT_QUANTILE = 0.75 # 异常截尾分位 IQR_FACTOR = 1.5 # IQR 倍数 FILL_METHOD = "median" # 缺失填充方式 def clean_orders(df, cfg=OrderConfig()): """清洗管道,参数由配置类统一控制。""" q3 = df["金额"].quantile(cfg.AMOUNT_QUANTILE) iqr = q3 - df["金额"].quantile(1 - cfg.AMOUNT_QUANTILE) df["金额"] = df["金额"].clip(upper=q3 + cfg.IQR_FACTOR * iqr) return df
💡 关键直觉:把"阈值、窗口、填充策略"从代码里抽出来,改动参数不用改逻辑。配置集中后,同一管道换个阈值就能跑不同口径的分析——这也是"一处修改、全局生效"的工程化红利。
3.7 管道的日志与监控
管道跑在别人看不见的地方时,日志就是它的眼睛:
import logging logging.basicConfig(level=logging.INFO) def clean_orders(df): logging.info(f"清洗前: {df.shape[0]} 行") df = df.drop_duplicates(subset=["订单号"]) logging.info(f"去重后: {df.shape[0]} 行, 删 {len(df)} ...") return df
关键节点打日志,数据异常时能快速定位"从哪一步开始不对"。生产环境里,日志 + 质量闸门(4.1 的 assert)是管道可靠性的双保险。
3.8 从个人脚本到团队管道
个人脚本变成团队管道,通常补三样东西:清晰的输入输出契约(接口文档)、可复现的环境(environment.yml)、自动化测试(跑一遍管道验证结果)。这三样齐了,同事就能放心调用你的管道,而不必每次追问"这个参数是什么意思"。
核心回顾
- 要点一:管道 = 职责单一的函数按顺序串联,接口统一"DataFrame 进、DataFrame 出"
- 要点二:幂等是管道可重跑的前提,纯函数风格天然幂等
- 要点三:关键函数配断言测试,改动即验证
- 要点四:docstring 写"为什么"而非只写"是什么",填充策略必须留痕
- 要点五:git 管代码、数据字典管字段,变更都可追溯
- 要点六:主流程一行一函数,读起来就是说明书
工程化的流程建好了,最后一节是全书排错手册——那些最常踩的坑,一次性汇总。