6.4 常见坑与排错 FAQ
6.4 常见坑与排错 FAQ
本节摘要:把全书出现过的坑集中成一张排错地图,覆盖类型、编码、索引、视图副本、内存、缺失六大类,每个问题给出"症状 → 原因 → 解法"三步式答案,并附通用排查思路。遇到报错先翻本节,多数问题五分钟内定位。
核心问题
阅读完本节,你应当能够:
- 按"症状 → 原因 → 解法"定位常见报错
- 说出类型、编码、索引、视图副本四类高频坑的解法
- 用通用的"报错逐行读 + 数据分块验证"思路排查新问题
- 独立解决 80% 的数据处理日常报错
一、问题与直觉
数据处理的报错信息往往很长,但 80% 的坑翻来覆去就那么几类。与其每次从零查起,不如把全书踩过的坑汇总成册:看到症状,直接对号入座。本节就是这本册子——每个坑都按"现象 → 为什么 → 怎么解"三步写,最后一节给出通用排查方法论。
二、核心原理
2.1 排错的第一性原理
一套通用的排错流程,从报错到解决:
报错信息里最后一行才是真正的问题所在,前面的堆栈只是"在哪里爆的"。定位问题三步走:
- 读最后一行报错,认关键字(ValueError、TypeError、KeyError……)
- 看报错出现在哪个操作(读文件?筛选?运算?)
- 回到数据本身检查(类型、缺失、索引是否符合操作前提)
💡 关键直觉:大多数报错的根源不是代码语法,而是数据形态与操作假设不符——列不存在、类型不对、有缺失。先查数据,再改代码。
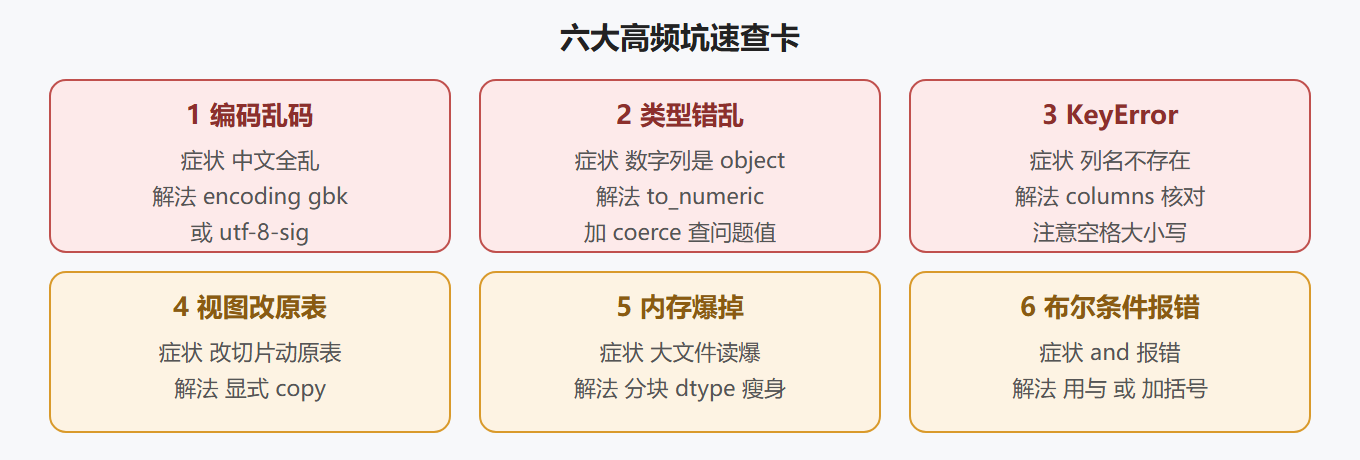
2.2 高频坑速查卡
三、工程实践要点
3.1 FAQ 一:中文乱码
现象:读 CSV 中文全是乱码。
原因:文件是 GBK 编码,read_csv 默认按 utf-8 解析。
解法:
df = pd.read_csv("orders.csv", encoding="gbk") # 或兼容带 BOM 的:encoding="utf-8-sig"
3.2 FAQ 二:数字列是字符串
现象:金额列 dtype 是 object,求和报错。
原因:列里混了带逗号的文本如 "1,299"。
解法:
df["金额"] = pd.to_numeric(df["金额"].str.replace(",", ""), errors="coerce") # coerce 让无法转换的变 NaN,正好暴露问题值
3.3 FAQ 三:KeyError 列不存在
现象:df["门店"] 报 KeyError。
原因:列名对不上——有空格、大小写不同、或拼写差异。
解法:
print(df.columns.tolist()) # 先看真实列名 df = df.rename(columns={" 门店": "门店"}) # 清空格
3.4 FAQ 四:改了切片原表也变
现象:sub = df[0:3] 改 sub,df 也跟着变。
原因:切片是视图,共享底层数据。
解法:需要独立副本就显式复制:
sub = df[0:3].copy()
3.5 FAQ 五:大文件读爆内存
现象:read_csv 大文件直接卡死或报内存错误。
原因:默认类型过宽 + 全量载入。
解法:分块读 + 定类型:
total = 0 for chunk in pd.read_csv("big.csv", chunksize=100_000, dtype={"门店": "category"}): total += chunk["金额"].sum()
3.6 FAQ 六:布尔筛选报 ValueError
现象:df[(df["金额"] > 300) and (df["金额"] < 500)] 报错。
原因:数组的 and 语义不明确,必须用位运算符。
解法:
df[(df["金额"] > 300) & (df["金额"] < 500)]
3.7 通用排查流程
| 步骤 | 做什么 | 工具 |
|---|---|---|
| 1 读报错 | 看最后一行关键字 | 无 |
| 2 看数据 | shape、dtypes、head、isnull | df 属性 |
| 3 隔离验证 | 用一小块数据复现 | df.head(100) |
| 4 逐段二分 | 注释一半代码找问题区间 | 注释 |
| 5 搜索确认 | 带着准确报错搜方案 | 文档/社区 |
⚠️ 常见坑:复制报错去搜时,别贴整段堆栈,只贴最后一行的错误类型和消息——信息更聚焦,命中率更高。
3.8 更多高频报错
| 报错 | 常见原因 | 一句话解法 |
|---|---|---|
| ValueError: 长度不匹配 | 赋值列与行数不一致 | 核对 len(新值) 与 df.shape[0] |
| TypeError: 不支持运算 | 类型不对(字符串+数字) | 先 to_numeric 再算 |
| NameError: 未定义 | 变量名拼错或未执行定义格 | 检查定义单元格是否运行 |
| FutureWarning | 老 API 即将移除 | 按提示换新写法 |
| 内存错误 | 数据太大 | 分块 + dtype 瘦身 |
| SettingWithCopyWarning | 视图上链式赋值 | 用 .loc[条件, 列] |
3.9 排错的心态与习惯
排错是数据分析日常的一部分,几个习惯能显著减少痛苦:
- 错误信息读完整:很多报错自带"如何修复"的提示,先看提示再搜
- 小步验证:写完一段跑一段,别攒一长串代码再跑——出错范围越小越好定位
- 保留可复现的复现集:出错时用
df.head(20)或最小样例复现,比在大表上调试快得多 - 记录踩过的坑:把自己踩过的坑记在项目笔记里,下次同类报错直接翻笔记
💡 关键直觉:报错不是失败,是数据在告诉你"它的真实形态和你想的不一样"。绝大多数报错的第一反应应该是检查数据,而不是改代码——
print(df.dtypes)和print(df.head())往往比看半天堆栈更快。
本节速览
- 要点一:报错读最后一行,认关键字再定位操作,80% 的根因是数据形态不符
- 要点二:乱码查 encoding,GBK 与 utf-8-sig 二选一
- 要点三:数字列是字符串用 to_numeric 加 coerce,问题值现形
- 要点四:KeyError 先看真实列名,空格大小写是高频元凶
- 要点五:视图副本坑用显式 copy 终结
- 要点六:大文件分块加 dtype,内存问题双管齐下
- 要点七:布尔条件用与或加括号,这是 Pandas 语法硬规则
- 要点八:通用排查五步——读报错、看数据、隔离、二分、搜证
全书到这里收尾。数据处理从环境到工程化的完整能力已经齐了,翻回导读页,对照章节地图查漏补缺,然后动手跑一遍 5.4 的实战案例吧。附录还有一份常用 API 速查,随时回来翻。