1.1 AI系统的脆弱性根源
1.1 AI系统的脆弱性根源
本节摘要:对抗样本现象——人眼看不出的微小扰动让模型彻底误判——之所以存在,根源在于深度学习的几个本质特性。高维空间里,即使每个像素只动一点点,累积起来的变化足以跨越决策边界;模型为追求训练效率做出的线性假设,使得它对输入的微小变化过度敏感;训练分布和真实分布的差距,让模型在没见过的输入上表现不可预测。本节从这几个角度解释脆弱性为什么"内生"于深度学习,以及为什么"测试集准确率高"不等于"模型真的鲁棒"。
本节目标
阅读完本节,你应当能够:
- 解释高维空间为什么让微小扰动产生大影响
- 说清模型的线性假设如何导致局部敏感
- 理解训练分布与真实分布的差距带来的脆弱性
- 区分"测试集准确率"和"对抗鲁棒性"的差别
- 说明为什么没有"绝对安全"的模型
一、问题与直觉
2013 年,Szegedy 等人发现了一个让人不安的现象:给一张被正确分类为"熊猫"的图片,加上一层人眼完全看不出区别的噪声,模型不仅认错了,还以 99% 的高置信度把它认成了"长臂猿"。这张加了噪声的图片叫对抗样本(adversarial example)。
这个发现之所以震动学界,是因为它打破了"模型准确率高就是好"的信念。那张熊猫图片,模型在测试集上分对了,但这不代表它"理解"了熊猫长什么样——它可能只是学到了某些脆弱的特征组合,一旦这些特征被轻微扰动,整个判断就崩了。
更让人不安的是,这种脆弱性不是某个模型的 bug,而是深度学习的通病。几乎所有主流模型(CNN、Transformer、甚至大语言模型)都存在对抗样本。这说明根源不在于某个架构的实现缺陷,而在于深度学习的某些本质特性。本节就拆解这几个根源。
二、核心原理
2.1 高维空间与扰动的累积效应
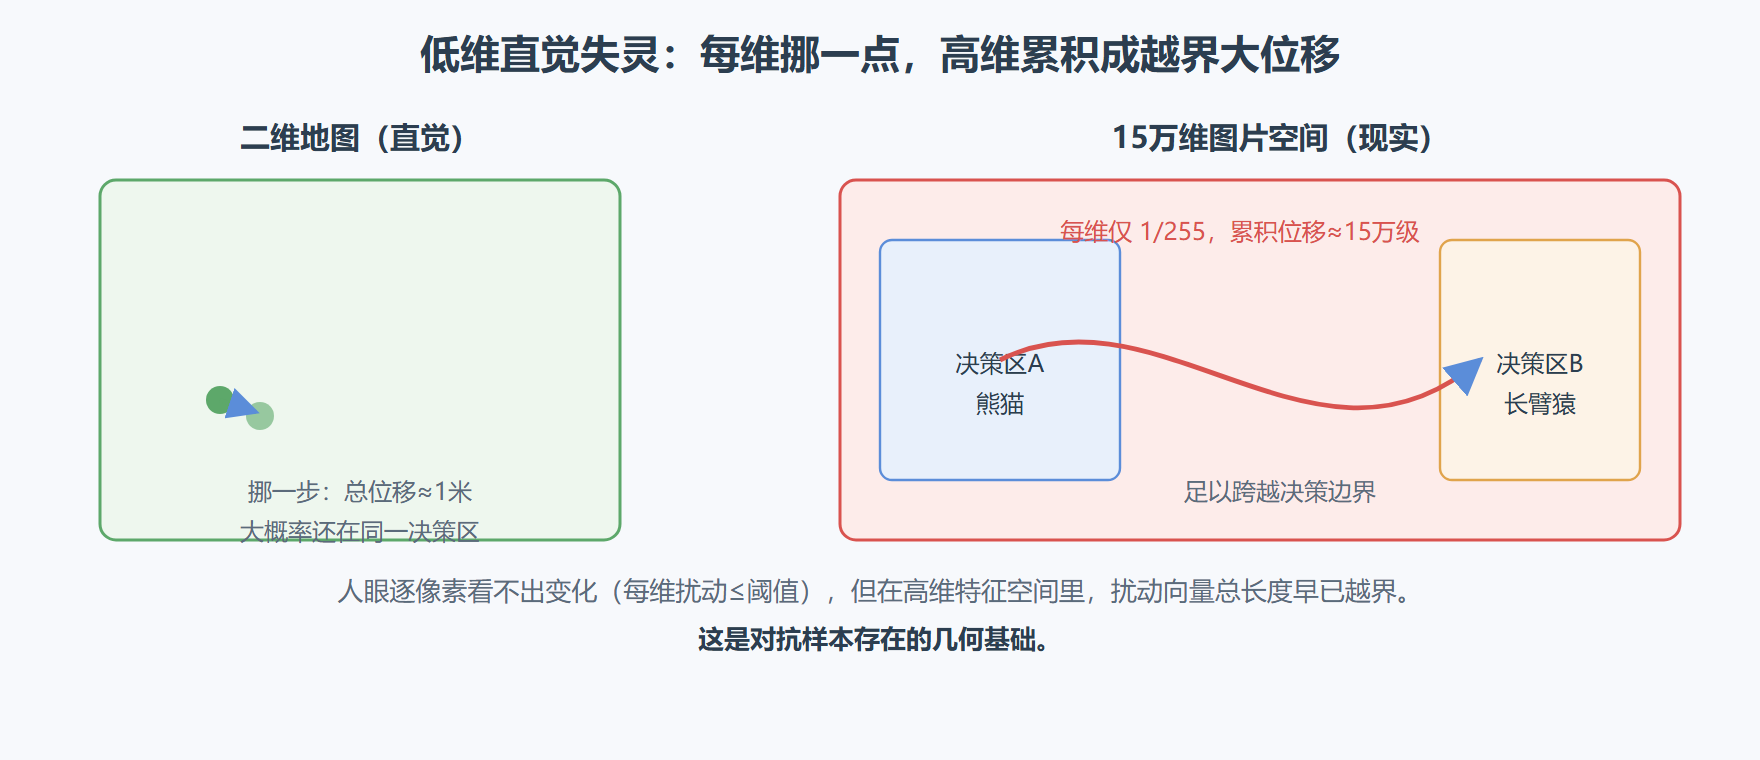
直觉上"加一点点噪声"应该影响不大。但在高维空间里,这个直觉失效了。一张 224×224 的图片有 15 万多个像素,每个像素即使只变化 1/255(肉眼几乎不可见),15 万个像素的变化累积起来,在特征空间里就是一次巨大的位移。
打个比方:你在二维地图上挪一步(比如 1 米),大概率还在同一个城市。但如果你在一个 15 万维的"超空间"里,每个维度都挪 1 米,总位移是 15 万米的量级——足以让你从北京跳到纽约。深度学习的输入空间正是这种高维超空间,所以"每维扰动一点点"累积成的总位移,足以把样本从模型的一个决策区推到另一个。
这就是对抗样本存在的几何基础:高维空间里,"人眼不可见的扰动"和"特征空间里的大位移"可以同时成立。
图 1-2:低维直觉失灵——每维只挪一点,高维累积成越界大位移
💡 换个角度理解:可以把对抗扰动想成"很多根几乎察觉不到的细线,一起拉"。每根细线拉力很小,但成千上万根同时拉,合力足以把样本拽过决策边界。线性假设之所以致命,正是因为它把这个"合力放大"的机制内建在了模型里。
2.2 线性假设与局部敏感
Goodfellow 提出的"线性假设"给出了更具体的解释。现代神经网络为了训练高效,大量使用线性或近似线性的激活函数(ReLU 等)。在线性模型里,输出对输入的响应是近似线性的——输入变化一点点,输出也按比例变化一点点。但问题在于,当输入维度很高时,这个"按比例变化"会被放大。
形式化地,一个线性分类器的输出是权重和输入的点积。如果扰动方向和权重方向对齐,即使扰动的每个分量很小,点积(高维求和)也可以很大,导致输出剧烈变化。Goodfellow 据此提出了 FGSM 攻击(下一章详讲)——就是沿着梯度方向(和权重对齐的方向)加扰动,用最小的扰动产生最大的输出变化。
线性假设的意义在于:它解释了为什么对抗样本是深度学习的"内生"特性,而非偶然。只要模型有线性成分(几乎所有现代模型都有),这种局部敏感就存在。
2.3 分布外泛化与不可预测性
模型在训练时只见过训练分布里的样本。当输入偏离训练分布(out-of-distribution,OOD),模型的行为是不可预测的——它可能给出高置信度的错误答案,因为输入落在了它没学过的特征区域。
对抗样本本质上是精心构造的分布外样本。攻击者通过优化,找到那些"刚好越过决策边界、但人眼看来还在原类"的输入。模型在这些输入上的行为,是它在训练时没被约束过的。
更深层的问题是:标准的训练目标(最小化训练误差)只关心"在训练分布上分对",不关心"决策边界长什么样、在边界附近的输入上行为如何"。这就留下了巨大的可利用空间——决策边界附近,模型可以非常脆弱,而标准训练完全不约束这部分。
2.4 测试集准确率不等于鲁棒性
这是实践中最重要的认知。一个模型在测试集上 99% 准确率,只说明它在"和训练分布同分布的自然样本"上表现好。它对对抗样本的鲁棒性可能极低——攻击者用 FGSM 几步就能把准确率打到 0%。
准确率和鲁棒性是两个近乎独立的维度。提升鲁棒性(比如用对抗训练)往往要以牺牲一些自然准确率为代价——这就是"鲁棒-精度权衡"(第 3 章详讲)。理解这一点,就不会盲目相信"我的模型准确率 99% 所以很安全"。
| 维度 | 衡量什么 | 怎么测 |
|---|---|---|
| 自然准确率 | 在自然样本上的表现 | 测试集准确率 |
| 对抗鲁棒性 | 在对抗样本下的表现 | 用攻击算法压测后的准确率 |
| 分布外鲁棒性 | 在偏离训练分布的样本上的表现 | OOD 测试集 |
💡 关键直觉:评估一个模型的安全性,绝不能只看自然准确率。一定要用对抗攻击压测它——"我的模型在 PGD 攻击下还能保持多少准确率"才是鲁棒性的真实度量。一个自然准确率 99% 但对抗准确率 0% 的模型,在生产环境里是极度危险的,因为攻击者一定能找到它的漏洞。
三、工程实践要点
3.1 脆弱性在不同模态的表现
对抗样本不仅存在于图像,几乎所有模态都有:
图像:最经典。像素级扰动,人眼不可见,但让分类器误判。
文本:改同义词、加不可见字符、改语法结构,让情感分析或文本分类出错。比图像难(文本离散不可微),但一样存在。
语音:在音频里嵌入人耳听不到的超声波频段信号,让语音识别系统执行隐藏指令("打开门")。这类攻击尤其危险,因为它能秘密激活智能音箱。
三维点云:自动驾驶的激光雷达识别,可以通过改动少量点让模型把一辆车识别成别的东西。
不同模态的脆弱性根源类似(高维、线性、分布外),但攻击和防御的具体技术因模态而异。
3.2 为什么没有绝对安全的模型
理论上,提升鲁棒性没有上限——但实践中,几个因素决定了"绝对安全"不可达:
鲁棒-精度权衡:越鲁棒的模型,自然精度往往越低。无限追求鲁棒会让模型在正常样本上表现差,这是不可接受的。
自适应攻击者:任何防御都能被了解该防御的攻击者绕过。你发布了防御方法,攻击者研究它、设计针对性的攻击。这是攻防博弈的本质——防御抬高门槛,但不能让攻击归零。
计算不对称:攻击者只需要找到一个薄弱点,防御者要守住所有点。这是结构性的不对称,决定了防御永远比攻击难。
所以 AI 安全的目标不是"绝对不被攻破",而是"把攻击成本抬高到攻击者不划算的程度"。这和密码学的思路一致——不追求理论不可破,追求"计算上难破"。
⚠️ 常见坑:宣称"100% 防御某攻击"的方法,十有八九是没经过自适应攻击检验。很多防御论文在标准攻击下表现好,一旦攻击者了解防御机制并做针对性调整,防御就崩了。评估防御一定要用自适应攻击——假设攻击者完全了解你的防御,看它还撑不撑得住。
3.3 怎么评估自己模型的脆弱性
不一定要成为安全专家,但每个 ML 工程师都该会基本的脆弱性评估:
# 概念性:用 FGSM 快速评估模型脆弱性 import torch import torch.nn.functional as F def fgsm_attack(model, x, y, epsilon): x.requires_grad = True output = model(x) loss = F.cross_entropy(output, y) loss.backward() # 沿梯度方向加扰动 让损失增大 即让模型出错 perturbed = x + epsilon * x.grad.sign() return perturbed.detach() # 评估:在测试集上 跑自然准确率和对抗准确率 def evaluate_robustness(model, test_loader, epsilon=0.05): natural_correct = 0 adv_correct = 0 total = 0 for x, y in test_loader: # 自然准确率 natural_correct += (model(x).argmax(1) == y).sum().item() # 对抗准确率 x_adv = fgsm_attack(model, x, y, epsilon) adv_correct += (model(x_adv).argmax(1) == y).sum().item() total += y.size(0) print(f"自然准确率: {natural_correct/total:.2%}") print(f"FGSM对抗准确率: {adv_correct/total:.2%}") # 如果自然高、对抗极低 说明模型脆弱
跑一下,如果你的模型自然准确率 95% 但 FGSM 对抗准确率只有 5%,说明它极度脆弱,生产部署前要想办法加固(至少做对抗训练)。
一节小结
- 高维空间让微小扰动累积成大位移:15 万维的图片空间里,每维扰动一点累积成足以跨越决策边界的大位移。
- 线性假设导致局部敏感:现代模型的线性成分使得输出对输入微小变化过度敏感,这是对抗样本的内生根源。
- 分布外样本行为不可预测:模型只约束了训练分布上的行为,决策边界附近留有巨大可利用空间。
- 准确率不等于鲁棒性:自然准确率 99% 的模型对抗准确率可能 0%,两者近乎独立,鲁棒提升往往牺牲精度。
- 评估模型要看对抗准确率:用攻击算法压测,才是鲁棒性的真实度量。
- 没有绝对安全的模型:鲁棒-精度权衡、自适应攻击、攻防不对称三因素决定只能抬高门槛而非归零。
- 宣称 100% 防御多半没经自适应检验:评估防御要假设攻击者完全了解防御机制。
- 每个 ML 工程师都该会基本脆弱性评估:跑个 FGSM 看对抗准确率,是最低限度的安全体检。
下一节建立系统描述威胁的框架——威胁模型从知识、能力、目标三维度刻画攻击者,攻防分类把各类攻击归到清晰的类别。