5.1 鲁棒性评估与对抗测试
5.1 鲁棒性评估与对抗测试
本节摘要:模型在干净测试集上 99% 的准确率,可能被一句"在对抗样本上掉到 20%"彻底打回原形。鲁棒性评估(Robustness Evaluation)就是专门回答"模型在恶意输入下到底还有多可靠"这件事。它不是一个单一指标,而是一套需要明确攻击强度、扰动预算、评估指标与基准库的度量体系。本节讲清楚这套体系怎么搭、怎么读、以及最常见的评估误区,帮助你不被厂商的"鲁棒性宣传"忽悠,也能给自己的模型做一次诚实的体检。
阅读收获
阅读完本节,你应当能够:
- 说清为什么干净准确率不能代表鲁棒性
- 解释扰动预算、攻击强度在鲁棒性评估中的作用
- 区分鲁棒准确率、攻击成功率等常用指标的含义
- 描述一次标准对抗测试的基本流程
- 识别"评估作弊"的几种常见手法(弱攻击、信息泄露等)
一、问题与直觉:为什么"测试集很准"会骗人
很多团队评估模型时只看一个数字:干净测试集上的准确率。这个数字在对抗机器学习里几乎没有参考价值,因为它假设测试集是"干净且与训练同分布"的。真实世界不是这样——攻击者会专门构造让模型出错的最坏输入。所以一个在 ImageNet 上 90% 准确率的模型,可能在对抗样本上连 10% 都不到。
鲁棒性评估的本质,是把"最坏情况"而不是"平均情况"作为衡量标准。你要问的不是"模型在随机测试集上多准",而是"攻击者花最大力气攻击时,模型还能扛住多少"。这就像评价一座城墙,不能只看它在风和日丽时多漂亮,而要看它被投石机连续轰击后还剩下多少完整。
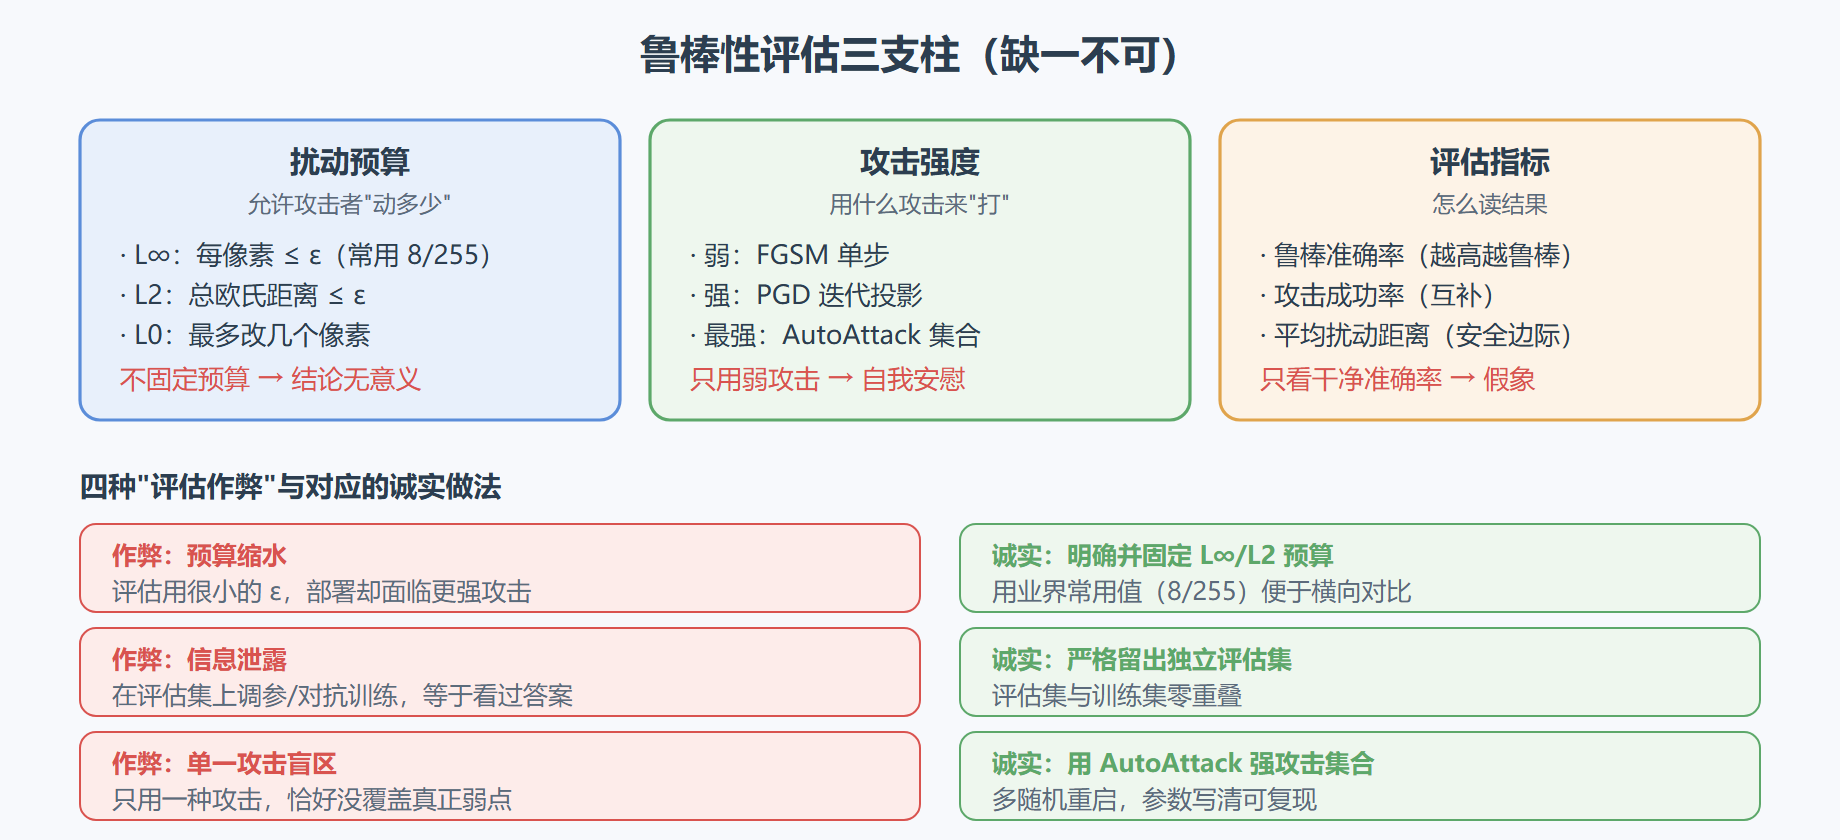
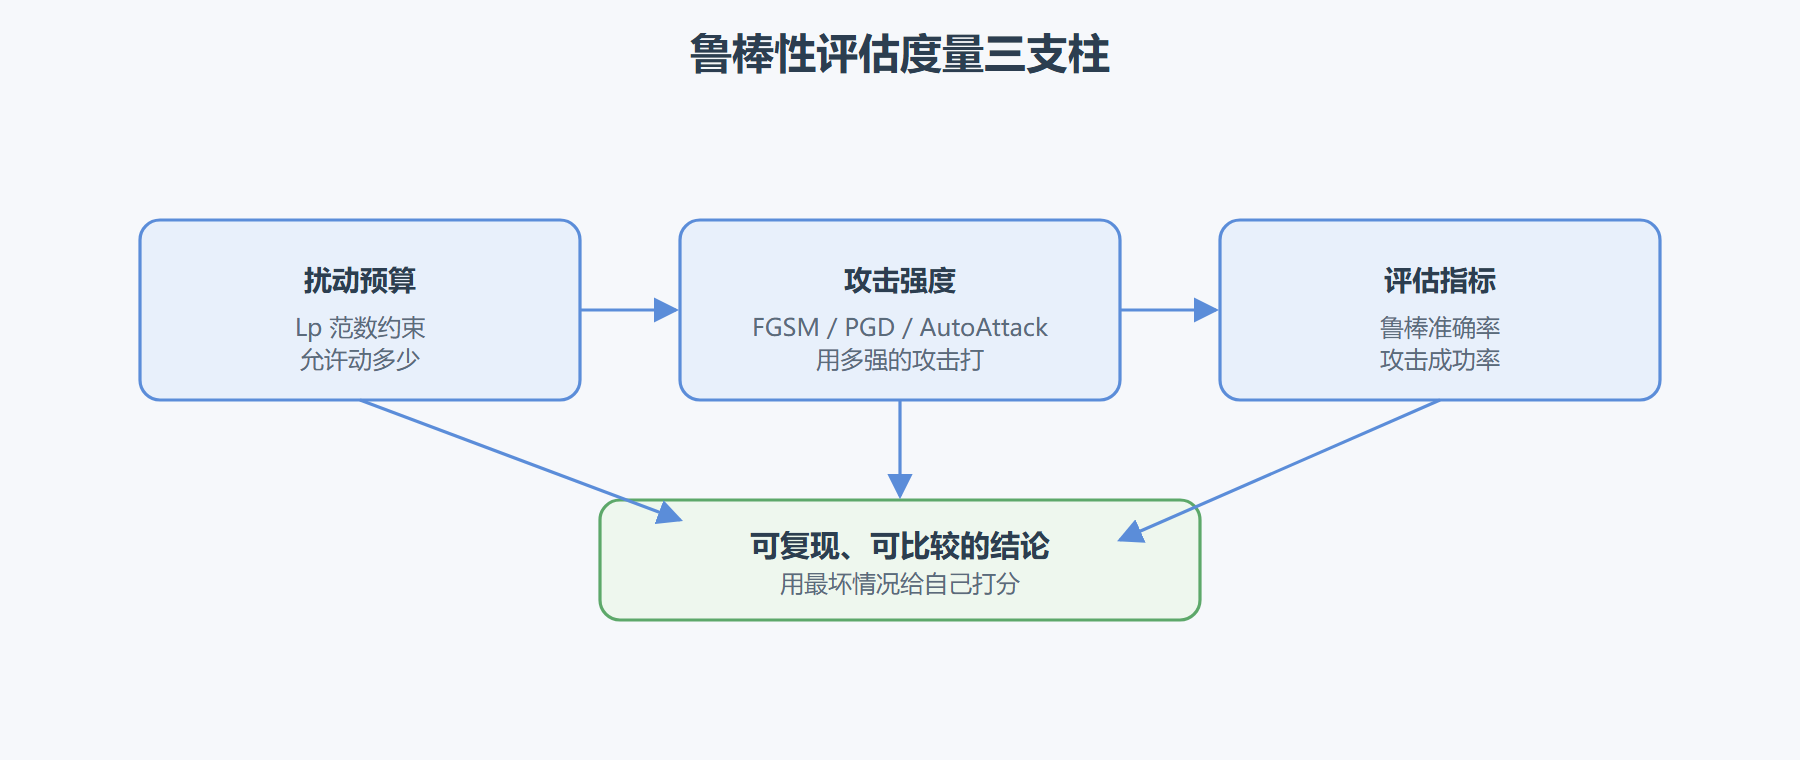
因此,鲁棒性评估必须显式地定义攻击者有多强(攻击强度)、允许扰动多大(扰动预算)、用什么指标衡量(评估指标)。这三个要素缺一不可,否则评估结果就不可复现、不可比较。
二、核心原理:度量体系的三个支柱
扰动预算:允许攻击者"动多少"
扰动预算(Perturbation Budget)定义了对抗样本离干净样本最多能有多远,通常用 Lp 范数约束。最常见的设置是 L∞ 范数,比如"每个像素最多改动 8/255";也有用 L2 范数(总欧氏距离)或 L0 范数(最多改几个像素)的。预算越大,攻击越强,但样本也可能变得人眼可见;预算越小,攻击越隐蔽,但成功率也越低。评估时必须明确预算,否则"鲁棒"的结论没有意义。
攻击强度:用什么攻击来"打"模型
攻击强度取决于你用什么攻击算法。用弱的 FGSM 单步攻击测出来的鲁棒性,一定比用强的 PGD 或 AutoAttack 测出来的高。所以评估鲁棒性必须用足够强的攻击。AutoAttack 是目前公认的标准强攻击集合,它把多个攻击算法组合起来,避免单一攻击的盲区。评估报告里如果只提"对抗训练后准确率提升",却不说明用了什么攻击,基本等于没说。
AutoAttack 为什么能成为公认基准,值得展开说一下它的构成,因为理解它的组成能帮你判断什么时候可以简化评估、什么时候必须用全套。AutoAttack 由四个组件拼成:一个是 Auto-PGD(APGD),它自适应调节步长,比固定步长的 PGD 更强,分别有针对交叉熵损失和针对差分损失(DLR)两个版本;一个是 AutoAttack 自带的 CW 变体(APGD-T),专门优化 targeted 攻击;一个是标准的 FAB 攻击,用来找最小扰动;最后一个是 Square Attack,一种基于分数的黑盒攻击,专门用来抓那些"梯度被掩蔽"的假防御。这四个组件串行跑,任何一个攻破就算模型被打穿。它的设计哲学是"覆盖不同的优化思路"——一阶梯度、优化求解、黑盒查询各一个,这样无论你的防御是靠梯度掩蔽、靠随机化、还是靠别的花招,总有一个组件能识破。代价是慢:在 ImageNet 量级的数据上跑全套 AutoAttack 可能要几天。所以实践中常见的折中是:开发阶段用 PGD 快速迭代,最终验证才上 AutoAttack 全套。
理解了 AutoAttack 的构成,你也就明白为什么"只用 FGSM 评估"会被社区当成不可接受的。FGSM 是单步攻击,它的搜索能力极弱,几乎所有稍微像样的防御都能挡住它——但这不代表防御真的强,只代表攻击太弱。用 FGSM 测出来的"鲁棒率",本质上测的是"模型在最优方向上走一步会不会出错",而真实攻击者会迭代地、自适应地搜索,能力远超单步。所以 FGSM 鲁棒率几乎是没有任何安全含义的数字,只能用来快速冒烟测试。
评估指标:怎么读结果
最常用的指标是鲁棒准确率(Robust Accuracy):在给定扰动预算下,模型对对抗样本的正确分类率。与之相对的是攻击成功率(Attack Success Rate):攻击者成功让模型出错的样本比例。两者互补,鲁棒准确率越高、攻击成功率越低,模型越鲁棒。此外还有平均扰动距离(Mean Perturbation Distance,模型被攻破所需的最小扰动),它衡量模型的"安全边际"有多厚。
三、工程实践要点:如何做一次诚实的评估
做鲁棒性评估最容易犯的错,是"用弱攻击证明自己强"。工程上要避免几种典型作弊。第一是攻击预算缩水:评估时用很小的扰动预算,实际部署却面临更强的攻击。第二是信息泄露:在评估集上做过对抗训练或调参,等于提前"看过答案",测试结果自然虚高。第三是单一攻击盲区:只用一种攻击算法,恰好没覆盖到模型真正的弱点。
规范的评估流程应该是:固定扰动预算 → 用强攻击集合(如 AutoAttack)在留出的评估集上生成对抗样本 → 计算鲁棒准确率与攻击成功率 → 与基线模型对比。评估集要严格独立于训练集,攻击参数要写清楚,结果要可复现。
展开说一下这个流程里几个容易做错的环节。第一是评估集的独立性。对抗训练的模型很容易出现"在训练攻击分布上过拟合"——它在训练时见过的攻击类型上表现很好,但换个稍微不同的攻击就崩。所以评估集不仅要和训练集不重叠,评估用的攻击配置(步长、迭代次数、随机重启次数)最好也和训练时用的不完全一样,否则等于又"看过答案"。一个更严格的做法是留出一部分数据从头到尾不参与任何训练或调参,专门用于最终评估。
第二是基线对比的必要性。孤立地报一个"鲁棒率 60%"意义有限——60% 是高是低,取决于基线模型在同样条件下的表现。如果你的标准训练模型在同预算下鲁棒率是 0%,那 60% 是巨大进步;如果同领域的 SOTA 已经到 65%,那 60% 就不算突出。所以规范的评估报告都会同时报"标准训练基线 + 自己的模型 + 已知 SOTA"三个数字,让读者有参照系。
第三是随机重启和最坏情况。PGD 这类攻击对起点敏感,从不同的随机起点出发会找到不同强度的对抗样本。只跑一次 PGD 会低估攻击的真实威力。标准做法是每个样本跑多次随机重启(常见 5 到 20 次),取让模型出错的那次作为结果。这在计算上是几倍的代价,但对结论的可信度提升很大——很多"鲁棒"的假象就是单次攻击没打中要害造成的。
| 评估要素 | 常见错误 | 正确做法 |
|---|---|---|
| 扰动预算 | 预算缩水、不明确 | 明确 L∞/L2 预算并固定 |
| 攻击强度 | 只用弱攻击 FGSM | 用 AutoAttack 等强攻击集合 |
| 数据集 | 评估集与训练集重叠 | 严格留出独立评估集 |
| 指标 | 只看干净准确率 | 同时报告鲁棒准确率与攻击成功率 |
图 5-1:鲁棒性评估三支柱与"评估作弊"对照
⚠️ 常见坑:把"对抗训练后的干净准确率下降"当成坏事而放弃。实际上对抗训练通常以少量干净准确率换取大幅鲁棒性提升,这是正常的权衡,关键看"换得值不值"。
💡 关键直觉:鲁棒性评估是"用最坏情况给自己打分"。你越诚实、攻击越强,得到的分数越可信,也越能在真实攻击到来前发现问题。
图 5-2:鲁棒性评估度量三支柱
常见问题
鲁棒准确率多少才算够
没有绝对标准,取决于部署场景。安全关键的场景(自动驾驶、医疗诊断、金融风控)对鲁棒准确率的要求远高于普通的图像分类或推荐场景。更重要的是,鲁棒准确率必须和扰动预算、攻击强度一起看:同一个 90%,用弱攻击测出来和用 AutoAttack 测出来含义完全不同。脱离这些前提的单一数字,既不能跨模型比较,也不能作为安全结论。
为什么必须用 AutoAttack 而不是只用 FGSM
因为单一攻击有盲区。FGSM 是最简单的单步攻击,用它测出来的鲁棒性会严重虚高,很多模型在 FGSM 下显得很鲁棒,换一个更强的攻击就被打穿。AutoAttack 把多种强攻击组合起来,覆盖更广的攻击空间,更接近真实攻击者的水平,因此它给出的鲁棒准确率是一个更可信的"下界"。评估报告里如果只提 FGSM 下的结果,基本等于没测。
评估结果能跨论文直接比较吗
不能直接比较。扰动预算、攻击强度、数据集划分、评估协议这些要素只要有一个不同,结果就不具备可比性。比较两个模型的鲁棒性之前,必须先确认这些设置一致,否则容易得出误导性结论。这也是为什么规范的评估报告要写清楚所有参数,保证可复现。
要点串联
- 要点一:干净准确率代表平均情况,鲁棒性评估必须衡量最坏情况,两者不可混用。
- 要点二:鲁棒性评估的三支柱是扰动预算、攻击强度、评估指标,缺一不可。
- 要点三:AutoAttack 是当前公认的强攻击集合,能避免单一攻击的评估盲区。
- 要点四:鲁棒准确率与攻击成功率互补,衡量模型在对抗输入下的可靠程度。
- 要点五:诚实评估要独立数据集、明确预算、强攻击、可复现,避免"用弱攻击证明自己强"。
下一节我们看红队实践与治理框架,把鲁棒性评估的结果放进一个更大的安全治理闭环里。