3.2 检测与净化的被动防御
3.2 检测与净化的被动防御
本节摘要:对抗训练靠"把攻击样本喂给模型"来增强鲁棒性,但它在部署后仍然被动——来一个陌生攻击,模型还是可能翻车。检测与净化(Detection and Purification)是另一类防御思路:不试图让模型对所有扰动都免疫,而是在输入进入模型之前先做一道安检,把可疑样本挡下来,或者把样本里的对抗扰动"洗掉"再喂给模型。本节拆解这两类被动防御的机理、代表方法与工程代价,并说明为什么"检测"和"净化"单独用都不可靠,通常要跟对抗训练组合。
本节导航
阅读完本节,你应当能够:
- 说清被动防御与对抗训练在防御位置上的本质区别
- 区分检测式防御的三种主要信号来源(样本、模型内部、外部语义)
- 描述特征压缩、随机化、输入重建等净化方法的原理与局限
- 判断在什么场景下该用检测,什么场景下该用净化
- 解释"检测器本身也会被攻击"这一自适应攻击问题
一、问题与直觉:为什么需要"不动模型"的防御
对抗训练有一个隐含前提:你愿意重新训练模型,并且手里有足够多的攻击样本来"对练"。但在很多真实场景里,这两个前提都不成立。模型可能是第三方提供的,只有推理接口,没法重训;或者线上服务已经稳定运行,重训一次要花几天、还要重新做回归验证,代价太大。
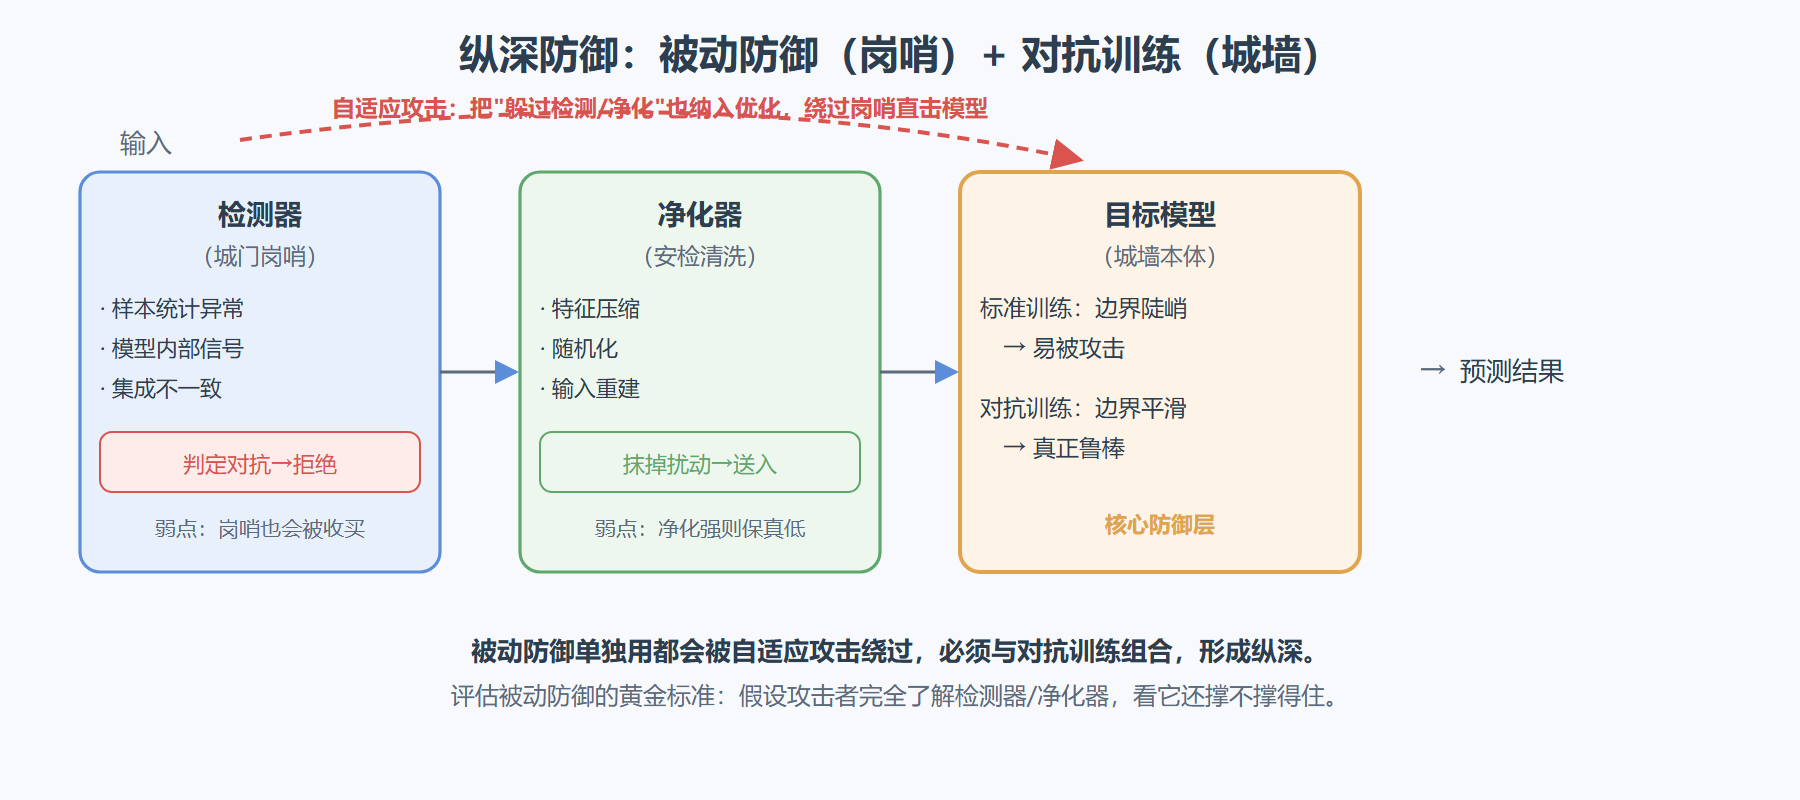
于是就有了一个更务实的思路:模型不动,在模型前面加一层防护。这层防护负责判断"这个输入是不是带着恶意扰动来的",或者"能不能把扰动先抹掉"。打个比方,对抗训练是给城堡加固墙体,检测与净化则是在城门口设岗哨、盘查行人的包裹——两者守的位置不同,成本也不同。城门口设岗的好处是快、不打扰城堡内部,坏处是岗哨自己也可能被收买(检测器被绕过)。
这类防御统称"被动防御"(Passive Defense),核心是把风险拦截在模型决策之前。它不改变模型的决策边界,只改变"到达模型的输入分布"。
二、核心原理:检测与净化的两条技术路线
检测式防御:找出"不对劲"的样本
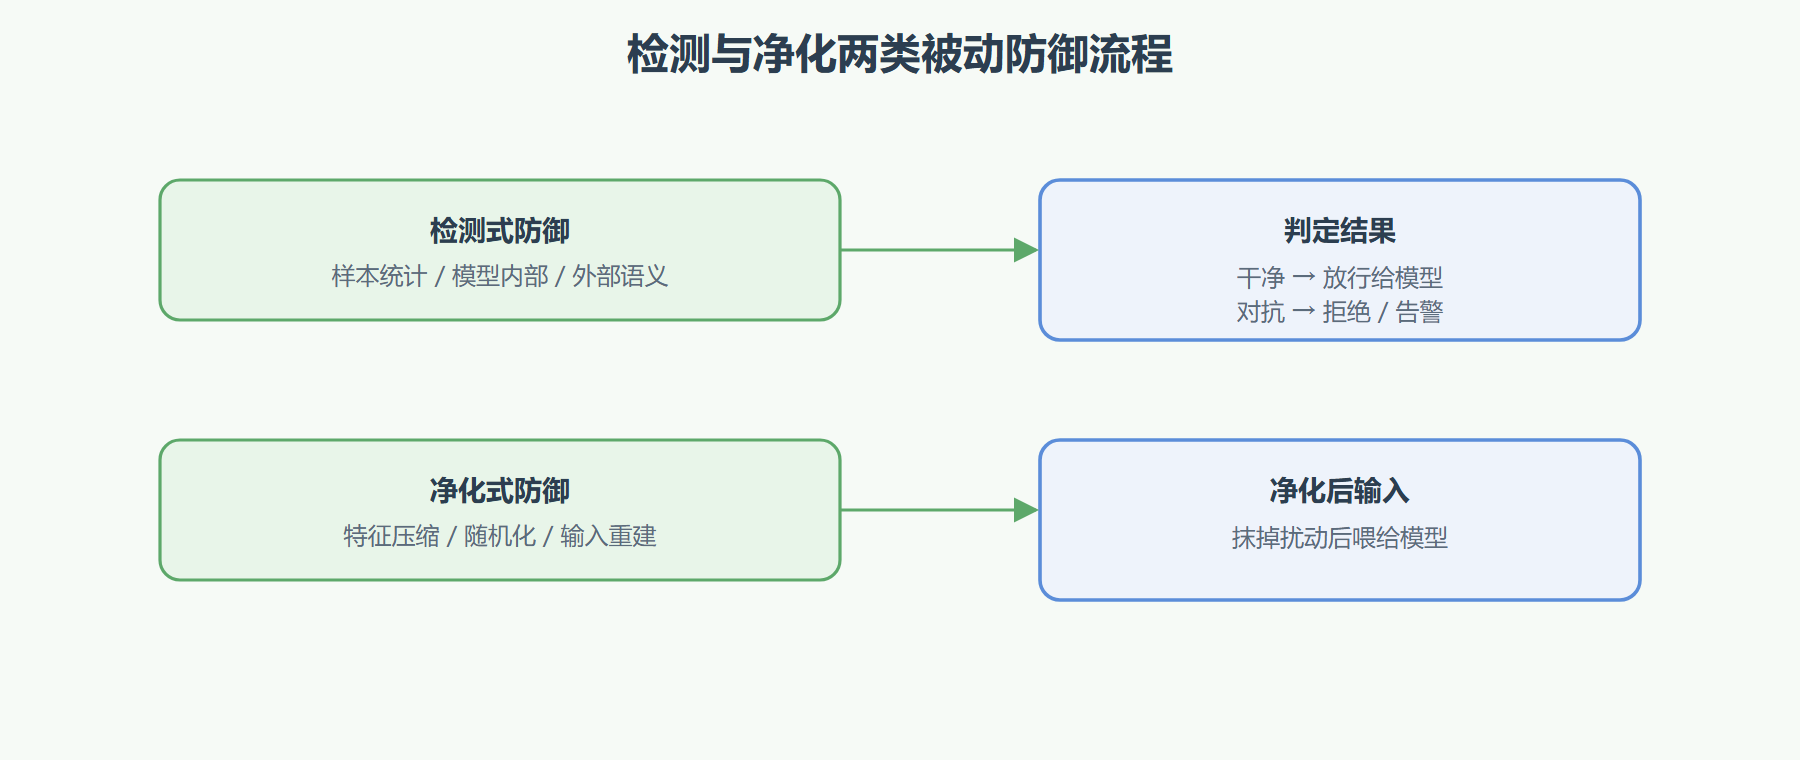
检测式防御的本质是训练一个二分类器,或者用一个统计量,来判断输入样本是干净的还是对抗的。它的信号来源大致有三类。
第一类是样本本身的统计异常。对抗样本虽然人眼看不出区别,但在像素空间的统计分布上往往有痕迹。比如对抗扰动会带来异常的高频成分、异常的局部相关性,或者落在干净样本流形之外。基于这个想法,有人用核密度估计、局部内在维度(Local Intrinsic Dimensionality, LID)来度量样本偏离流形的程度。LID 的思路很直观:干净样本在流形上,局部维度低;对抗样本被推离流形,局部维度会异常升高。
第二类是模型内部信号的异常。对抗样本进入模型后,中间层的激活模式、logits 分布、softmax 的置信度往往和干净样本不同。一个经典观察是:对抗样本的 softmax 输出往往"过度自信"或"异常犹豫"。所以可以在模型内部加一个检测头,或者用中间层特征训练一个单独的检测器。
第三类是外部语义的一致性。比如用多个模型投票(集成不一致性检测),或者用图像语义分割与分类结果交叉验证。这类方法利用"对抗扰动难以同时欺骗多个独立视角"的特性。
净化式防御:把扰动"洗掉"
净化式防御的假设是:对抗扰动是附加在干净样本上的"噪声",只要能把噪声去掉,样本就恢复干净了。代表方法有几类。
特征压缩(Feature Squeezing)是最简单的一种:把输入的色彩位深从 8bit 降到更少,或者对图像做中值滤波、平滑。它的依据是,对抗扰动往往依赖高精度的像素差异,降低精度会让扰动失效。但代价是同时也会损失一部分干净样本的信息,导致正常准确率下降。
随机化(Randomization)是另一种思路:在输入进入模型前做随机变换,比如随机缩放、随机裁剪、随机加噪。因为攻击者在生成对抗样本时假设的是一个固定的输入路径,一旦路径被随机化,攻击的"瞄准"就会落空。但随机化的问题是,攻击者如果知道防御策略,可以做"期望攻击"(Expectation over Transformation, EOT),对随机化后的分布求期望来生成更稳的对抗样本。
输入重建(Input Reconstruction)则更激进:用自编码器、去噪器或者生成模型把输入"重建"成干净版本。比如训练一个去噪自编码器,输入对抗样本,输出干净样本,再把输出喂给分类器。理论上如果重建足够好,扰动会被抹掉;但实践中重建过程本身也会引入误差,而且攻击者可以针对重建器做端到端的攻击。
重建类方法有一个工程上很容易低估的坑:重建器和分类器之间的"接口"会变成新的攻击面。很多人把去噪器当作一个独立的预处理模块部署好,就以为万事大吉——但攻击者只要知道这个去噪器的存在,就可以把"去噪器加分类器"当成一个整体的可微管道,对这个组合算梯度,生成专门绕过去噪的对抗样本。这就是为什么强调"自适应攻击"——评估净化防御时,必须假设攻击者知道整条流水线,而不是只盯着分类器。一个只在"攻击者不知道有去噪器"时有效的净化方案,上线后基本会被打穿。
还有一类近年比较活跃的净化思路是基于生成模型的净化:用一个在干净样本上训练好的生成模型(比如扩散模型或 GAN),把输入投影回生成模型学到的"干净流形"上。直觉是:对抗样本偏离了干净数据流形,把它"拉回"流形就等于去掉了扰动。这类方法在经验上效果不错,但生成模型本身的计算开销很大(扩散模型要做几十步去噪),而且生成模型对分布外的输入不一定鲁棒,攻击者也可能构造出能欺骗生成模型投影的样本。它更适合离线净化或对延迟不敏感的场景,线上实时推理用起来还很吃力。
三、工程实践要点:检测与净化的取舍
检测式防御最大的优点是侵入性小,但它有一个致命问题:检测器本身也是模型,也会被攻击。攻击者一旦知道有检测器,就可以把"躲过检测器"也纳入优化目标,生成既能骗过目标模型、又能骗过检测器的样本。这在文献里叫"自适应攻击"(Adaptive Attack),是评估被动防御时必须考虑的最强对手。很多论文里的检测方法在自适应攻击下成功率大幅下降。
具体来说,自适应攻击有几种构造方式。最直接的是"端到端反向传播":把检测器和分类器串成一条可微的管道,对整条管道算梯度生成对抗样本,这样生成的样本天生就能同时骗过两个模型。如果检测器里有不可微的操作(比如硬阈值、离散化),攻击者可以用直通估计(straight-through estimator)或梯度近似绕过。还有一种更隐蔽的"后处理攻击":攻击者不去正面骗检测器,而是让对抗扰动落在检测器认为"正常"的那部分统计区间内——比如让对抗样本的高频成分刻意压低,躲过基于高频异常的检测。这些手段说明,检测器的"判别边界"和分类器的"决策边界"一样,都是可以被优化攻击精准定位并绕过的。
这也引出一条评估被动防御的铁律:任何检测或净化方法,在发表论文或上线前,都必须报告它在自适应攻击下的表现。如果一份评估只说"我们的检测器在标准对抗样本上召回率 95%",却没说攻击者已知检测器时的表现,这个数字几乎没有参考价值。业界目前普遍接受的规范是:研究者自己实现针对自己方法的自适应攻击,并公开攻击代码,让社区验证。这条规范虽然提高了发表门槛,但它有效遏制了"刷榜式防御"的泛滥。
净化式防御则面临一个两难:净化越强,扰动去得越干净,但干净样本的保真度越低。你不可能既把对抗扰动完全抹掉,又不损失任何有用信息——这本质上是一个信息损失问题。工程上要在"鲁棒性提升"和"正常准确率下降"之间找平衡点。
| 防御方法 | 优点 | 代价 | 适用场景 |
|---|---|---|---|
| 特征压缩 | 实现简单、开销小 | 正常准确率下降 | 对精度要求不极端的图像分类 |
| 随机化 | 无需重训、易部署 | 可被 EOT 期望攻击绕过 | 在线推理接口的快速加固 |
| 输入重建 | 扰动去除较彻底 | 重建误差、计算开销大 | 对输入质量要求高的场景 |
| 集成不一致检测 | 不依赖单一信号 | 需要多模型、延迟高 | 高安全等级的风控系统 |
图 3-3:纵深防御分层透视——检测/净化是入口岗哨,对抗训练是城墙
⚠️ 常见坑:只用"干净样本准确率"来评估检测器,会严重高估它的能力。对抗样本检测必须用自适应攻击重新评估,否则上线后容易被专门构造的样本打穿。
💡 关键直觉:被动防御和对抗训练不是二选一,而是"纵深防御"的两层。对抗训练让模型本身变硬,检测与净化在入口再拦一道,两者叠加的鲁棒性通常好于单用其一。
图 3-2:检测与净化两类被动防御流程
一节小结
- 要点一:检测与净化不改变模型,只在输入进入模型前做拦截或清洗,代价小、部署快,但本身也可被攻击。
- 要点二:检测式防御的三类信号是样本统计异常、模型内部信号异常、外部语义不一致,各有适用边界。
- 要点三:净化式防御的代表方法包括特征压缩、随机化、输入重建,本质是"去噪",会带来正常准确率损失。
- 要点四:自适应攻击是评估被动防御的黄金标准,检测器必须能在"攻击者知道检测器存在"的前提下仍然有效。
- 要点五:工程上通常把检测/净化与对抗训练组合使用,形成纵深防御,而不是指望单一方法一劳永逸。
下一节我们将进入训练阶段的安全问题——数据投毒、后门攻击与模型窃取,看看攻击者如何从"推理阶段"前移到"训练阶段"埋雷。