第4章 · 训练阶段安全与前沿
第 4 章 · 训练阶段安全与前沿
章节摘要:前面几章默认攻击发生在"推理阶段"——模型已经训练好了,攻击者只是在输入上做手脚。但更隐蔽、更致命的攻击其实发生在"训练阶段":攻击者可能污染你的训练数据(数据投毒),在模型里植入只有特定触发器才能激活的后门(后门攻击),或者通过反复查询把你的模型参数"偷"走(模型窃取)。这一章把训练阶段的安全威胁与前沿方向讲清楚,重点落在数据投毒、模型窃取、后门攻击与联邦学习安全四个问题上,帮助你在训练流水线里就把风险识别出来。
你能学到什么
阅读完本章,你应当能够:
- 区分推理阶段攻击与训练阶段攻击在攻击面上有什么不同
- 描述数据投毒的几种典型方式(标签翻转、干净标签投毒、后门注入)与防御思路
- 说清模型窃取攻击的目标、查询方式与防护手段
- 解释后门攻击的触发器机制,以及为什么它比普通投毒更难被发现
- 识别联邦学习这种分布式训练场景下的独特安全风险
核心概念速览
训练阶段的安全问题比推理阶段更难防,因为"脏东西"是混在数据里、长在模型里的,等上线才发现时,往往已经变成模型的固有行为。
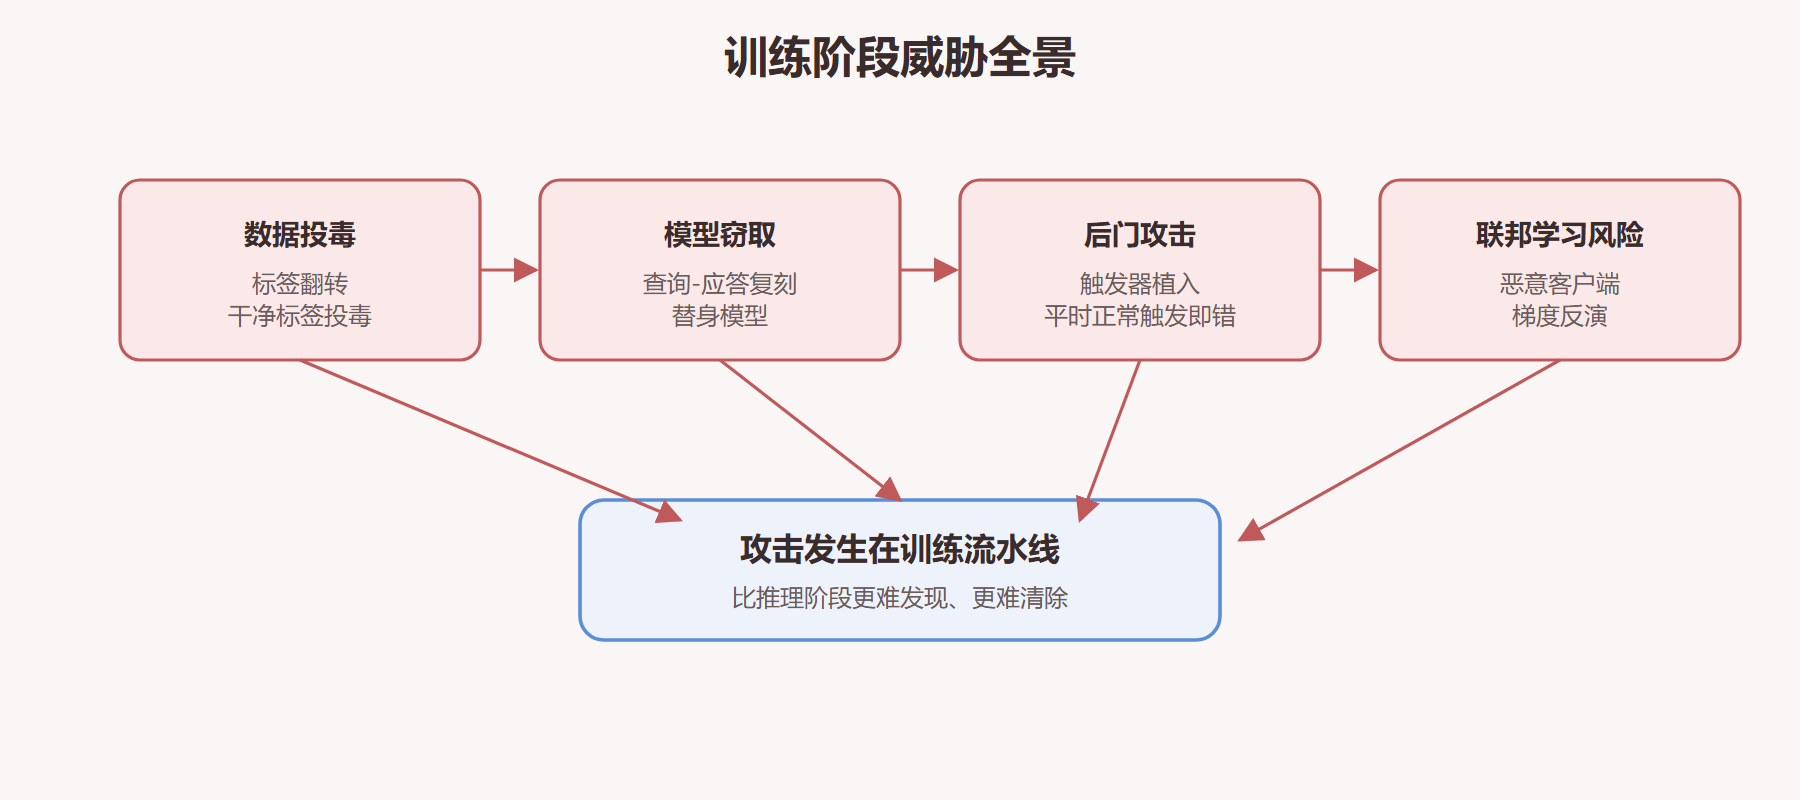
图 4-1:训练阶段威胁全景
子章节导航
4.1 数据投毒与模型窃取
讲攻击者如何污染训练数据让模型学到错误关联,以及如何通过黑盒查询逐步逼近甚至复制一个商业模型的参数。两种攻击一个污染"输入",一个窃取"输出",都是训练阶段最现实的威胁。
4.2 后门攻击与联邦学习安全
讲后门攻击如何把恶意行为藏进模型,只有特定触发器出现时才激活;再讲联邦学习这种"数据不出本地"的分布式训练范式,如何在梯度交换与客户端协作中引入新的投毒与隐私风险。这一节揭示的是"藏在模型里"和"藏在协作流程里"的更隐蔽威胁。
子章节之间的逻辑关系
4.1 先讲"训练数据被污染"和"模型被偷"两个外部威胁,4.2 再讲"模型被埋后门"和"联邦协作被破坏"两个更深层的问题。前者是单点攻击,后者是隐藏攻击与分布式攻击。从"看得见的污染和窃取"到"看不见的后门和协作风险",威胁的隐蔽程度逐节上升,对应地,检测和防御的难度也逐节上升。
4.1 数据投毒/模型窃取 ──► 4.2 后门攻击/联邦学习安全 (污染数据、偷模型) (埋后门、破坏协作)
贯穿本章的核心判断
训练阶段的安全和推理阶段有个根本不同:推理阶段的攻击发生在模型上线后,你能持续监控;训练阶段的攻击发生在模型成型前,一旦"脏东西"混进训练,就会长成模型的固有行为,上线后极难察觉。这个差异决定了训练阶段安全必须以"预防为主",几条判断贯穿全章。
数据来源可信度决定了威胁等级。 公开数据集、用户上传数据、第三方标注——这些来源都可能被投毒。自有封闭数据集风险低,但也挡不住内部人员动手脚。读这章时要带着自己训练流水线的数据来源清单,逐一评估每条来源的可信度和被污染的可能性。
后门的可怕在于"平时正常"。 后门模型在没有触发器时表现得和正常模型一模一样,常规评估完全发现不了。只有特定触发器出现才激活恶意行为。这意味着不能用标准测试集筛后门,必须有专门的触发器检测和异常行为分析。
联邦学习的去中心化是双刃剑。 数据不出本地保护了隐私,但也让服务端无法直接审计每个客户端的数据质量。一个恶意客户端可以在本地数据里植入后门,通过梯度更新把后门"传染"给全局模型。分布式训练在提升隐私的同时,打开了新的攻击面。
贯穿本章的核心判断(续)
读完上面三条判断,你可能已经感受到训练阶段安全的一个总基调:它不是靠某个炫酷的防御算法一招制敌,而是靠把"可信"二字嵌进训练流水线的每个环节。下面再补一条贯穿性的判断,它决定了你在这章里该把注意力放在哪。
检测难度决定威胁严重性。 推理阶段的对抗样本虽然可怕,但只要监控到位,一次攻击失败后模型行为就回归正常,影响是瞬时的。训练阶段的攻击不一样:投毒、后门一旦成功,恶意行为就固化在权重里,模型每次推理都会带着这个"病灶",而常规的准确率指标根本测不出来。这意味着训练阶段的安全必须靠"事前预防 + 专项检测"双管齐下,而无法靠线上监控兜底。读这章时,建议带着自己训练流水线的数据流图,逐一标注每个环节"如果被动手脚,要多久才能发现"——这个练习会让你对训练阶段威胁的隐蔽性有切身体会。
读这一章容易踩的坑
坑一:把训练阶段安全和推理阶段安全混为一谈。 不少团队以为"我模型在 PGD 下扛得住,训练阶段也安全了"。这是两个层面的问题。对抗训练提升的是推理阶段的鲁棒性,它假设训练数据和流程是干净的;而训练阶段安全回答的是"训练数据和流程本身会不会被污染"。一个对抗训练做得再好的模型,如果训练数据里被植入了后门,照样会在触发器出现时翻车。两个层面要分开防,别指望一个方案覆盖所有威胁。
坑二:高估"数据不出本地"的安全性。 联邦学习打着"数据不出本地"的旗号,很容易让人误以为它天然安全。但数据不出本地只挡住了直接泄露,梯度反演能从梯度反推数据特征,恶意客户端能从更新通道注入后门——这些都是集中式训练没有的新攻击面。读到联邦学习那节时,别被"隐私友好"的标签麻痹,要带着"哪些安全假设在分布式场景下失效了"的视角去读。
坑三:以为后门检测有银弹。 目前没有任何单一方法能可靠地检测所有后门。触发器逆向、神经元裁剪、激活分析各有各的盲区,组合使用也未必覆盖所有触发器形态(比如频域后门、动态触发器)。把后门检测理解成"概率性降低风险"而非"彻底消除",才会做出务实的防御决策。
前置知识与后续延伸
- 前置知识:需要理解基本的监督学习训练流程(损失函数、梯度下降、数据集划分),以及第 1 章讲过的威胁模型分类(尤其是投毒攻击与逃避攻击的区别)。
- 后续延伸:第 5 章讲怎么评估一个模型到底有多鲁棒、以及如何用红队和治理框架把安全问题纳入工程流程。本章的训练阶段威胁,很多都需要靠红队的主动探测才能在上线前发现,所以第 4 章和第 5 章的治理闭环是配套的。