1.1 具身智能的本质与离身范式
1.1 具身智能的本质与离身范式
本节摘要:具身智能常被误解成“给 AI 装个身体”,这个理解太浅。本节讲它的准确定义——智能从智能体与环境的持续交互中涌现,而不是预先存在于纯计算里。我们对比离身智能(纯符号计算,如传统大模型)取得的成就和遇到的根本局限,说清为什么大模型再强,也直接做不了拧螺丝这种物理任务。核心是理解:具身不是有没有身体,而是智能是否在感知行动闭环里产生。
本节目标
阅读完本节,你应当能够:
- 用一段话讲清具身智能的准确定义,不依赖“有身体”这种浅层理解
- 说清离身智能范式的成就和它的根本局限
- 解释为什么大模型直接控制机器人效果差
- 区分“有身体的 AI”和“具身智能”
- 理解现实鸿沟为什么是具身智能的核心挑战
一、问题与直觉
大语言模型能写文章、写代码、做推理,表现越来越像人。于是很多人觉得,把大模型接到机器人上,机器人就该会干活了——给它个机械臂,让它用大模型来控制,不就能拧螺丝、端水杯了吗?
真试了就会发现完全不是这么回事。大模型输出的“把杯子拿起来”,对人是一句清楚的指令,但对机械臂,它不知道“杯子”在三维空间的哪个位置、用什么力度抓不会捏碎、抓起来后怎么避免撞到旁边的障碍。大模型擅长的是符号层面的语言和推理,但它对物理世界的感知和行动几乎一无所知。
这个落差揭示了具身智能的核心问题。传统 AI(包括大模型)是“离身”的——它把智能当成纯粹的符号计算,跟物理世界隔离。这种范式在语言、图像等数字领域成就辉煌,但一到要跟物理世界交互(感知环境、执行动作、应对物理约束),就露馅了。具身智能研究的就是怎么补上这块——让智能体通过身体与环境交互,在交互中产生能应对物理世界的智能。
二、核心原理
2.1 离身智能:成就与局限
先把离身智能讲清楚,才知道具身智能要补什么。
离身智能(Disembodied Intelligence)的核心假设是:智能是一种可脱离物理载体的抽象计算能力。这个假设催生了辉煌的成果——图灵机能计算一切可计算的、专家系统用规则推理解决特定问题、深度学习从数据里学模式、大模型掌握语言和常识推理。这些成就都建立在“智能等于计算”的范式上。
这个范式在数字领域(语言、图像、下棋、写代码)几乎所向披靡,因为这些任务的输入输出都是符号,不涉及物理世界。但它的局限在面对物理任务时彻底暴露。物理世界有三个让离身范式头疼的特征。
不确定性:物理世界充满噪声和扰动。同一只杯子,光照变了看起来不一样、放的角度变了反光不一样、有点灰尘传感器读数就不准。离身 AI 依赖清晰确定的输入,物理世界给不了。
物理约束:物理世界有重力、摩擦、惯性、碰撞。动作不是想做什么就能做,得在物理定律允许的范围内。大模型说“把杯子拿起来”,但拿起来需要精确的力控、避障、平衡,这些物理细节它没概念。
实时交互:物理世界是实时变化的。机器人动的时候,环境在变(人走过来、东西倒了),它得即时感知和调整,不能慢慢算。离身 AI 习惯离线慢慢推理,实时性是另一套要求。
| 维度 | 离身智能(数字领域) | 具身智能(物理领域) |
|---|---|---|
| 输入 | 清晰符号(文本、图像) | 噪声传感器(视觉、触觉) |
| 约束 | 逻辑规则 | 物理定律(重力、摩擦) |
| 交互 | 离线、可慢 | 实时、即时 |
| 错误代价 | 输出不对重试 | 物理后果(碰坏、摔碎) |
2.2 具身智能:智能从交互涌现
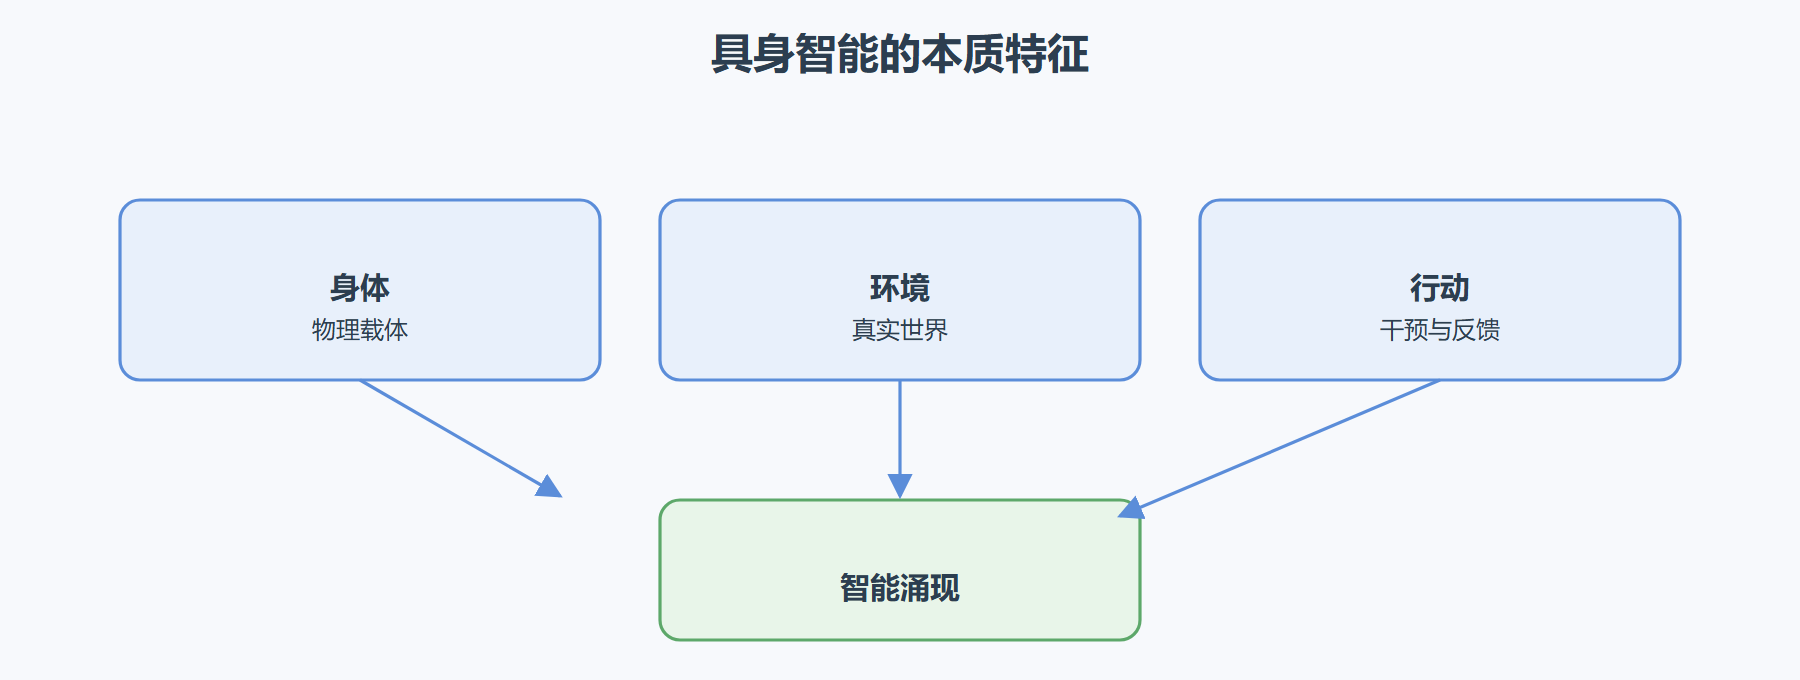
具身智能(Embodied AI)的核心主张:智能不是预先存在于纯计算里,而是从智能体与环境的持续交互中涌现。
这个主张最直观的体现是婴儿学抓东西。婴儿不是先在脑子里建好“杯子”的完整三维模型,再指挥手去抓;而是通过无数次伸展、触碰、滑脱、再调整,在指尖压力、手腕扭矩、视线追踪的实时反馈里,“杯子”才真正获得形状、重量、易碎性这些意义。这个过程里,智能(对杯子的理解、抓取的能力)不是事先算好的,而是在手和杯子的反复交互中长出来的。
所以具身智能的关键不在“有没有身体”——一个能看能说但不能动的聊天机器人,哪怕有个虚拟形象,也不是具身智能。关键在“智能是否在感知-行动的闭环里产生和体现”。有身体但智能是预先编程死规则的(传统工业机器人),也不是真正的具身智能;真正的具身智能,是能通过感知和行动的持续闭环,在与环境的交互中展现出适应性和学习能力的。
2.3 现实鸿沟:具身智能的核心挑战
具身智能有个绕不开的核心挑战:现实鸿沟(Reality Gap)。
你在仿真环境里训出一个抓取策略,仿真里成功率 99%。把它放到真实机器人上,成功率可能掉到 50% 甚至更低。为什么?因为仿真环境永远没法完美复刻真实世界——仿真的物理引擎是近似的(摩擦系数、接触力学都是简化模型),仿真的传感器是理想的(没有真实摄像头的噪声和曝光问题),仿真的物体是干净的(没有真实物体的纹理和磨损)。策略在仿真里学到的是“仿真世界的规律”,换到真实世界就水土不服。
现实鸿沟是具身智能区别于纯软件 AI 的根本难点。纯软件 AI 训练和部署在同一个数字环境,没有鸿沟;具身智能训练常在仿真(安全、快、便宜),部署在现实,中间隔着这道沟。怎么跨越这道沟(Sim2Real),是第 5 章的重点,也是具身智能能不能实用的关键。
三、工程实践要点
3.1 别指望大模型直接当机器人大脑
现在有个流行做法:把大模型当机器人的“大脑”,用它来做任务理解和规划,然后输出动作指令。这个思路有道理(大模型确实擅长理解任务),但不能直接用——大模型对物理世界缺乏感知,输出的指令要么太空泛(“拿起杯子”)要么不符合物理可行性。
务实的做法是分层:大模型做高层任务理解和规划(“把桌子收拾一下”分解成“收杯子、收书、擦桌子”),低层的感知和动作执行由专门的具身模块负责(视觉定位杯子位置、力控抓取)。这样各司其职,大模型的语言理解能力和具身模块的物理执行能力结合。
3.2 仿真是必需品,但要清醒认识其局限
仿真环境对具身智能是必需品——在真机上训练又慢又贵又危险(机器人试错可能撞坏东西)。仿真让训练快几千倍、成本极低、零风险。但必须清醒:仿真不是现实,仿真训出来的策略要能迁移到现实才行。所以仿真训练一定要配 Sim2Real 的迁移策略(域随机化、系统辨识等,第 5 章讲),别指望仿真训完直接上真机。
⚠️ 常见坑:在仿真里把任务做到近乎完美,直接部署到真机发现完全不行,然后困惑“为什么这么好的策略不 work”。原因就是现实鸿沟。从项目一开始就要把 Sim2Real 纳入考量,而不是训完才发现迁移不了。
3.3 从简单任务和受控环境起步
具身智能项目别一上来就挑战“让机器人做家务”这种开放任务。从简单的、受控的任务起步:固定台面上的抓取、结构化环境里的导航。把感知、规划、控制的闭环在这些简单任务上跑通,再逐步增加环境复杂度和任务难度。跳级挑战开放任务,几乎必然失败。
💡 关键直觉:具身智能的核心不是算力多强、模型多大,而是感知-行动闭环能不能在物理世界里稳定转起来。一个闭环转得稳的简单系统,比一个模型巨大但闭环断裂的复杂系统有用得多。做具身智能,先把闭环跑通,再谈智能水平。
图 1-2:具身智能的本质特征
一节小结
- 离身智能:智能视为脱离物理的纯计算,在数字领域成就辉煌,但在物理任务上露馅。
- 三大局限:物理世界的不确定性、物理约束、实时交互,让离身范式处理不好物理任务。
- 具身智能定义:智能从智能体与环境的持续交互中涌现,不是预存于纯计算。
- 关键不是有没有身体:而是智能是否在感知-行动闭环里产生,死规则控制的机器人不算具身。
- 现实鸿沟:仿真训练的策略迁到现实成功率骤降,是具身智能核心挑战。
- 分层架构:大模型做高层规划,具身模块做底层执行,别指望大模型直接控制。
- 仿真必需但要配 Sim2Real:从项目开始就纳入迁移考量,别训完才发现迁移不了。
下一节我们深入讲贯穿全书的核心机制——感知-行动闭环,看智能怎么在这个循环里涌现。