6.3 持续剖析:常驻线上的广域监控
6.3 持续剖析:常驻线上的广域监控
持续剖析(Continuous Profiling)指在生产环境以极低开销(约 1%)常年运行的采样剖析:所有实例持续低频采样,数据集中汇聚,事后任意时间窗、任意服务、任意标签地查询火焰图。它把剖析从"出事才采"变成"永远在采",是性能证据学的一次范式升级。
为什么"出事才采"总是来不及
传统剖析的困境:性能事故的窗口是分钟级的,等告警触发再登机器开 perf,黄花菜凉了;就算赶上了,机器随后被缩容或替换,案卷随之蒸发。更隐蔽的损失是对照组缺失——没有历史基线,你无法回答"这个热点是今天新出现的还是一直如此"。
持续剖析的反直觉之处在于:为不发生的案件也持续取证。1% 的常驻开销买来的是:
- 事故时刻的剖析数据已经在库里,回看即可;
- 任意版本对比:v1.8 与 v1.9 的火焰图差分,回归当场现形;
- 慢请求与热点的时间对齐:第 6.2 节的链路定位到服务后,直接切到该时刻该服务的剖析。
架构:低频采样 + 集中汇聚
组成四件套:
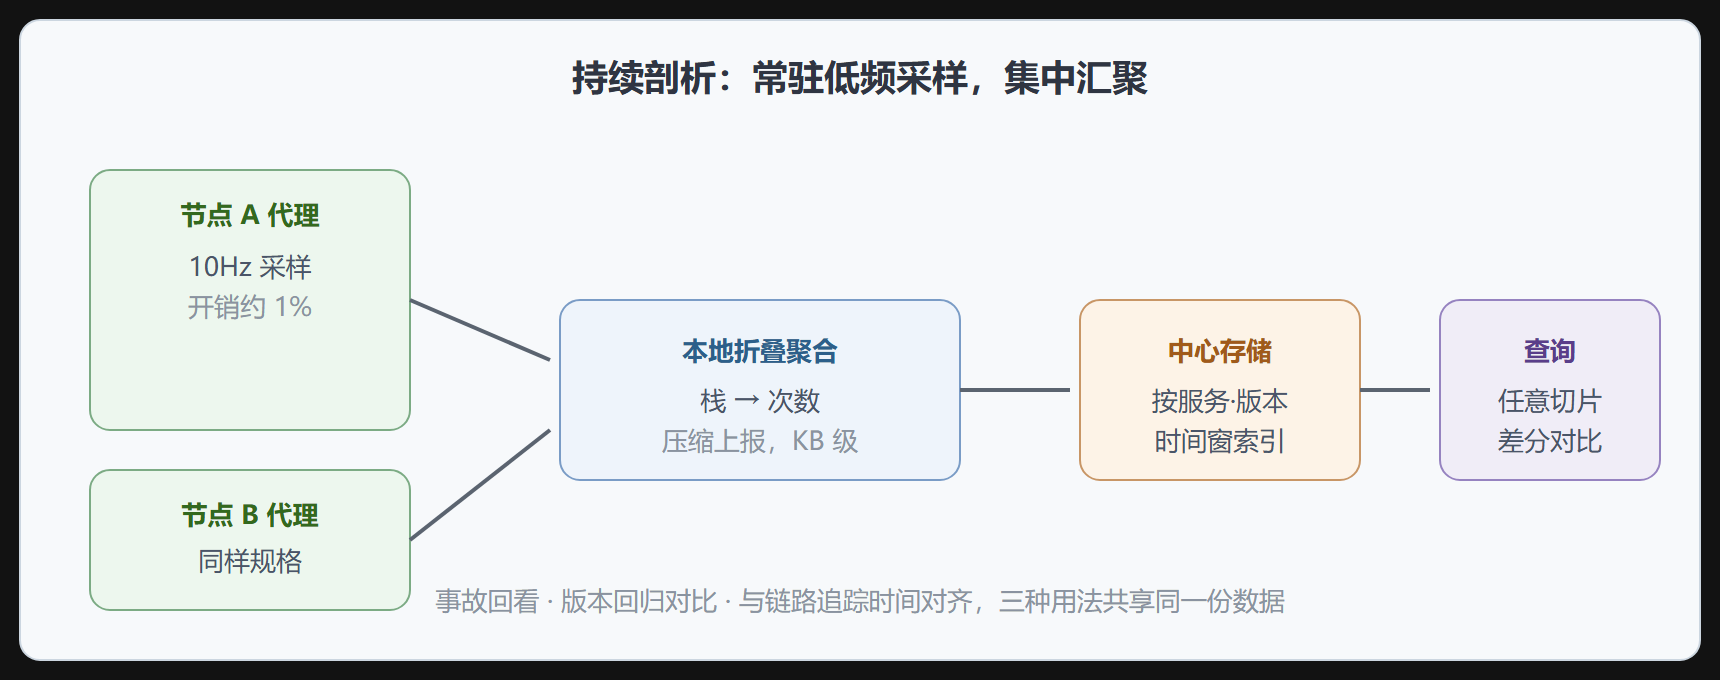
- 采集代理:每节点一个,eBPF 或语言运行时接口采样(如 Go pprof、Java async-profiler),频率通常 10Hz 级别;
- 本地聚合:采样栈折叠成"栈 → 次数",压缩后上报,网络代价极小;
- 中心存储:按服务/版本/时间窗/标签索引,存的是聚合后的栈数据而非原始样本;
- 查询界面:任意维度切片出火焰图与差分图。
持续剖析数据流
开销预算与精度取舍
持续剖析的成本账要算清楚:
- CPU:采样与栈回折约 0.5–1.5%,对多数服务可接受;预算紧张时按服务分级(核心服务 10Hz,边缘服务 1Hz);
- 内存:代理进程通常几十 MB,容器环境记得算进 sidecar 或 DaemonSet 的配额;
- 精度:低频采样对"占比 2% 以上"的热点仍然可靠(第 2 章的统计学结论),分钟级窗口聚合后样本量充足。
一个实践细节:标签设计决定查询能力。给每份剖析数据打上服务名、版本、地域、实例规格标签,事后才能做"金丝雀版本 vs 基线版本"这种高价值对比。标签缺失的持续剖析只是一堆数据,不是证据库。
实战用法三例
回看定罪:某服务周二 14:00 CPU 毛刺 5 分钟。打开持续剖析,切到该时间窗火焰图:新增一座 regex_compile 山——某次发布引入了循环内正则编译。没有常驻数据,这种瞬逝案件只能靠猜。
版本差分:发布后 P99 涨 15%。两版本火焰图做差分:红色新增集中在序列化库的某函数,定位到依赖升级带来的行为变化。从"感觉是这次发布"到"就是这个函数",两份图搞定。
容量外推:某热点函数占比连续三个月每月涨 1.5 个百分点,线性外推四个月后 CPU 预算穿底。提前排期优化,而不是等事故来敲门。
💡 关键直觉:持续剖析把火焰图从"抓拍"变成"监控录像"。抓拍要运气,录像随时回看——对低概率、瞬逝的性能案件,这是取证能力的代差。
本节要点回顾
- 核心价值是"永远在采":事故时刻的数据已在库里,且天然带历史基线;
- 架构 = 节点代理低频采样 + 本地折叠 + 中心索引,网络与存储代价都被聚合压到很小;
- 开销约 1%,按服务分级调采样率控制预算;
- 标签决定查询能力:服务/版本/地域标签是差分对比的前提;
- 三大用法:事故回看、版本差分、趋势外推,共享一份数据。
延伸:常驻剖析的资源预算编制
持续剖析的第一问题不是"用什么工具"而是"预算给多少"。业界经验值:采样型剖析常驻开销 1% 以内可全员开启,预算超了就降采样频率而不是关功能。编制方法:
# 单实例: 99Hz 采样, 30s 一段, 自动上传 perf record -F 99 -g -o /tmp/prof.data -- sleep 30 # 上传后本地不留大文件; 配额测算: # 每段未压缩 ~2-8MB, 压缩后 ~10-25%, 千实例集群每日: # 1000 * 2880段 * 0.4MB(压缩均值) ≈ 1.1TB/天 -> 需要保留策略(如热7天)
预算编制要覆盖三块:目标机 CPU 与磁盘写放大、网络出流量、后端存储与查询成本。三块里任何一块没有数字,"常驻"都会在第一次存储告警后被整体关掉——而关掉之后的下一次事故,就没有历史画像可对照了。
延伸:画像与指标的联动查询
持续剖析的价值在关联:延迟指标异常时,能立刻拉出同一时间窗的剖析对比。落地要点是统一维度——实例、时间窗、流量标签三个键在指标系统和画像存储里必须同构,查询时先从指标异常段定位实例,再按实例+时间窗取画像,diff 出"这一小时比上周多出来的栈"。把这条查询路径做成值班一键脚本,画像库才不是摆设;多数团队缺的不是采集,而是从告警到画像的两跳没有打通,数据躺在对象存储里无人问津。
./prof-diff.sh --svc payment --instance i-abc \ --baseline 7d-ago --window 2026-08-24T02:00/03:00 > diff.txt
关于数据的合规与安全也提一句:持续剖析捕获的是调用栈与符号名,可能包含请求参数片段或密钥调用路径,上传前要在采集端做脱敏(符号白名单、参数不采样),存储侧按敏感数据分级管理保留周期。多数团队在第一次安全审计时才补这一课,成本远高于建设时就设计好。把脱敏策略写进采集 agent 的默认配置而不是靠事后过滤,是持续剖析能在合规环境下长期存活的前提。
再补一个实操细节:符号是画像可读性的命门。采集端抓到的栈是地址,还原成函数名需要二进制的符号表与运行时偏移,因此发布系统要把"带符号的构建产物 + build-id 映射"作为一等公民归档,保留期与画像数据一致。缺了这一环,历史画像就是一堆无法解读的地址串,预算花得再多也换不回证据。同理,解释型语言要额外采运行时符号(JVM 的 map 文件、Go 内建符号、Python 的帧映射),agent 选型时把"符号完备性"列为一票否决项。
最后谈冷启动时段的覆盖:持续剖析按时间窗聚合,天然偏向稳态,而冷启动(JVM 预热、JIT 未编译、缓存未填充)恰恰只在启动后头几分钟发生,聚合后被平均抹平。对启动敏感的服务,要为冷启动窗口单独配置高密度采集:启动后三分钟内采样频率翻倍、独立打标,画像按"第 N 分钟"而非墙钟时间对齐对比。把冷启动画像纳入发布检查,能在大流量上线前发现"每次发版头两分钟 P99 尖刺"的老问题,而不是靠扩大实例数把它稀释掉——那是用容量预算掩盖观测盲区的典型做法。