3.4 strace 与 ltrace:系统调用的现场审讯
3.4 strace 与 ltrace:系统调用的现场审讯
strace 基于 ptrace 机制记录进程的每一次系统调用及其参数、返回值;ltrace 记录动态库函数调用。它们是"审讯式"工具:不回答性能差在哪,只回答进程此刻到底在跟内核要什么。用对场景极其高效,用错场景会制造冤案。
strace 的正确用法
最经典的用途:程序卡住了,看不出它在干嘛。贴上去审讯:
strace -p <pid>
输出立刻暴露等待点:
read(7, ← 卡在这里:在等文件描述符 7 上的数据
一行卡住的 read,配合 ls -l /proc/<pid>/fd/7 查明 fd 7 是哪个 socket,卡在等谁的数据就清楚了。这类"卡在哪"的问题,strace 三秒出答案,比任何采样都快。
再看一个启动失败的审讯:
strace -f -e trace=file ./myapp
-e trace=file 只看文件相关调用,-f 跟随子进程。输出里通常是长串 openat 尝试:
openat(AT_FDCWD, "/etc/myapp.conf", O_RDONLY) = -1 ENOENT (No such file or directory) openat(AT_FDCWD, "./myapp.conf", O_RDONLY) = 3
配置文件到底从哪些路径找、最后用了哪个、哪个权限被拒(EACCES),一目了然。"找不到文件/权限不对/连不上某个地址"这类问题,strace 是最快的审讯手段。
统计模式:开销可控的用法
裸 strace 逐事件打印很重,加 -c 只做汇总统计,负担小得多:
strace -c -p <pid> -f
% time seconds usecs/call calls errors syscall ------ ----------- ----------- --------- --------- ---------------- 42.10 0.812034 162 5012 futex 28.30 0.546112 811 673 91 recvfrom 15.02 0.289761 14 20700 clock_gettime 6.55 0.126310 88 1432 epoll_wait
这份表格已经有了诊断价值:futex 占四成时间——锁竞争;clock_gettime 调了 2 万次——有人在循环里反复取时间戳,该缓存没缓存。
ltrace:库函数层面的审讯
ltrace 看 dynamica 库调用,粒度比 strace 细一层:
ltrace -p <pid> -e 'malloc+free'
能看到 malloc/free 的调用序列与大小分布,快速判断"有没有疯狂的重复分配"。但要注意:ltrace 依赖 PLT 钩子,对静态链接或深度优化的调用可能漏记,证据等级比 strace 的系统调用层低一档。
冤案制造机:用 strace 测性能
必须再次强调第 1 章的警告,因为它每天都在真实发生。一个对比实验的量级感:
同一 IO 密集程序,三次运行: 不挂任何工具 → 2.1s strace 默认全跟 → 26.8s(慢 12 倍) strace -c 汇总 → 4.5s(慢 2 倍)
原因在机制:ptrace 模式下每个系统调用要把进程停下来、切换到 tracer、记录、再切换回来,一次调用的代价被放大几十倍。用它测得的"哪个调用慢",大概率测的是 strace 自己的开销。
strace 的能力边界与替代品
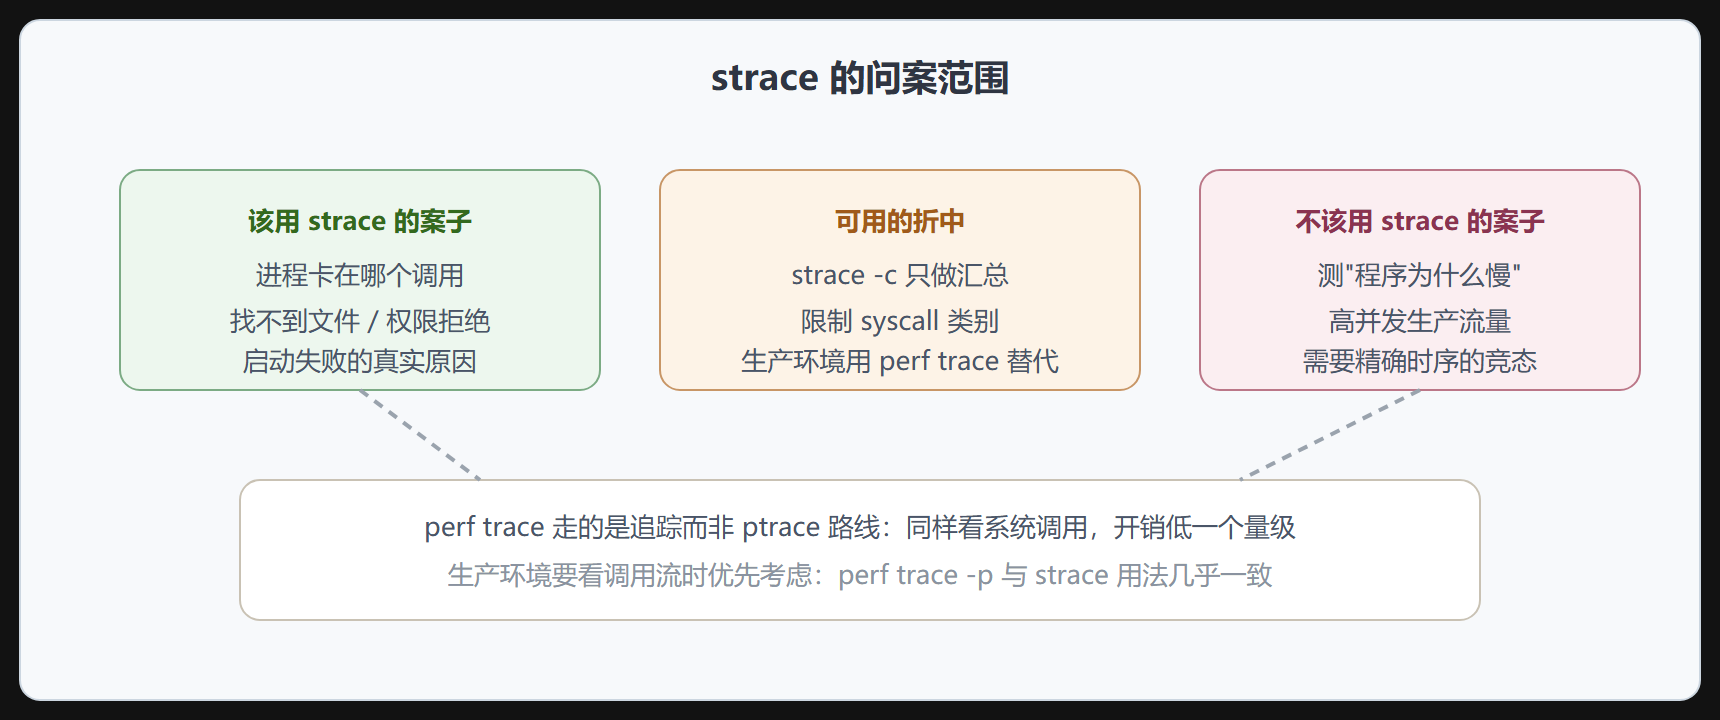
💡 关键直觉:strace 的输出是"口供",不是"测速仪"。口供告诉你它在等什么、找什么;测速请用 perf 一族的仪器。
本节要点回顾
- strace 回答"卡在哪、找不到什么、权限为何被拒",这类案子它是最快路径;
-c汇总模式开销小一个量级,还自带"哪个 syscall 占时最多"的诊断价值;- 全跟模式可让 IO 密集程序慢一个数量级,测性能用它必出冤案;
- ltrace 看库函数层,粒度更细但证据等级低于系统调用层;
- 生产环境看调用流用 perf trace,机制不同,同为审讯、扰动更低。
延伸:strace 的开销实验与替代方案
strace 每个系统调用要停两次进程,吞吐打三折是常态,先量化再上生产:
# 用 -c 只拿计数汇总,比全程跟踪便宜一个量级 strace -c -f -p $PID & sleep 20; kill %1 # 输出按耗时排序的 syscall 表,先看哪类调用最频繁/最慢 # 更低开销的替代:只统计不逐条打印 strace -c -e trace=network,futex -p $PID # 需要逐条证据且不能接受开销时,改用 eBPF 旁路 bpftrace -e 'tracepoint:raw_syscalls:sys_enter { @[comm] = count(); }'
-c 模式没有逐条打印的格式化开销,多数"这个进程到底在做什么"的问题用它就够了;逐条 -e 跟踪留给需要参数与时序的场景,且尽量收窄 -e trace= 的事件集。
延伸:从 syscall 表到结论的推理链
拿到 -c 汇总后按三条规则推理:futex 调用量与上下文切换同高,指向锁竞争;read/write 单次很小但次数巨大(如 8 字节 × 每秒十万),指向 Nagle 或未缓冲 IO;stat/openat 数量与页面缓存命中率相关,大量 stat 常意味着配置热加载轮询。每条规则都能用第二个工具交叉验证——futex 高就用 perf lock,小写多就用 ss -i 看 nodelay。单工具结论永远是假设,双工具吻合才算证据,这是现场审讯一节留给所有后续章节的纪律。
顺带说明 ltrace 的现代处境:glibc 2.34 之后符号可见性收紧,ltrace 对动态库调用的默认拦截大量失效,实际工作中它已退居二线,库函数层面的审计更多改由 ASan/性能剖析或显式的 LD_PRELOAD 包装器完成。但 ltrace 的方法论没有过时——"在库边界截获并记录调用序列"这一手法,在追第三方闭源库行为时仍是少数可行手段之一,配合 -e 收窄事件集与 -S 同时看系统调用,可以拼出"库函数→系统调用"的两层证据链。使用时接受它比 strace 更大的开销,只对小流量进程或短窗口开启。
另外提醒 strace 的两个高频误用:一是对多线程服务不加 -f,只跟到主线程,得出"进程很安静"的错误结论;二是对 JVM/Go 等自带运行时的进程逐条跟踪,海量 runtime 系统调用淹没真正的业务调用,应先 -c 拿分布再按事件类型收窄。审讯工具的结论质量,取决于你对它盲区的了解程度。