3.3 ftrace 与 bpftrace:动态追踪双枪
3.3 ftrace 与 bpftrace:动态追踪双枪
ftrace 是内核内置的追踪框架(tracefs 文件接口),bpftrace 是 eBPF 的高级语言前端。前者零依赖、稳定可靠,适合系统级事件流分析;后者把第 2 章的 eBPF 能力封装成一行式探针语言,是"高级法证工具"的日常形态。
ftrace:内核自带的侦探线
ftrace 不需要安装任何东西,内核挂载 tracefs 后即可用。最直接的用法是追踪调度事件:
cd /sys/kernel/tracing # 老系统在 /sys/kernel/debug/tracing # 看有哪些可用追踪点 cat available_events | grep sched # 开启调度器事件,抓 1 秒 echo 1 > events/sched/sched_wakeup/enable echo 1 > tracing_on sleep 1 echo 0 > tracing_on head -20 trace
输出是一份带纳秒时间戳的事件流水:
<idle>-0 [003] d..1. 8412.104223: sched_wakeup: comm=worker pid=3121 prio=120 target_cpu=003 <idle>-0 [003] d..2. 8412.104891: sched_switch: prev_comm=swapper prev_pid=0 next_comm=worker next_pid=3121 worker-3121 [003] .... 8412.107660: sched_switch: prev_comm=worker prev_pid=3121 next_comm=swapper next_pid=0
这份流水可以直接回答"进程 X 在 CPU 上只跑了 2.8 毫秒就让出去了,是被抢占还是主动阻塞"。函数级追踪也可以开启:
# 追踪内核函数调用(带过滤器,否则事件爆炸) echo 'vfs_read' > set_ftrace_filter echo function > current_tracer
ftrace 还有两个高价值特性:
- function_graph:画出函数调用层级与每个函数的耗时,看内核子系统内部时序绝佳;
- 触发器:给特定追踪点挂条件动作,比如"调度延迟超过 100ms 时打印栈":
echo 'sched_wakeup:latency_format' > trace_options echo 'hist:keys=comm:lat=common_timestamp.usecs' > events/sched/sched_wakeup/trigger
⚠️ 常见坑:全局开 function tracer 会显著拖慢系统。永远先设
set_ftrace_filter(只追踪指定函数)或set_event_pid(只追踪指定进程),把事件流约束在侦查范围内。
bpftrace:一行命令挂 eBPF 探针
bpftrace 的语法是"探针 / 过滤 { 动作 }",四类探针覆盖内核与用户态:
kprobe:vfs_read 内核函数入口 kretprobe:vfs_read 内核函数返回 tracepoint:syscalls:sys_enter_read 静态系统调用点 uprobe:/路径/二进制:函数名 用户态函数入口(路径换成实际二进制位置)
几个实战级一行命令。统计哪个进程在做磁盘写:
bpftrace -e 'tracepoint:block:block_rq_issue { @[comm] = count(); }'
@[dd]: 8412 @[postgres]: 1204 @[kworker]: 310
追踪新进程诞生(谁在 fork):
bpftrace -e 'tracepoint:sched:sched_process_fork { printf("%s -> %s\n", comm, args->parent_comm); }'
测量应用函数耗时分布(用户态探针):
bpftrace -e 'uprobe:/srv/app/bin/orders:process_order { @t[tid] = nsecs; } uretprobe:/srv/app/bin/orders:process_order /@t[tid]/ { @ms = hist((nsecs - @t[tid]) / 1000000); delete(@t[tid]); }'
每个命令的共同点:过滤和聚合都在内核态完成,回传的只是计数或直方图——这正是第 2 章 eBPF 数据流的落地。
双枪怎么选
| 场景 | 选择 | 理由 |
|---|---|---|
| 看系统事件流水/时序 | ftrace | 零依赖,事件格式标准 |
| 快速聚合统计(谁、多少次、什么分布) | bpftrace | 一行搞定,内核态聚合 |
| 复杂逻辑(跨事件关联、状态机) | BCC(写 C) | bpftrace 表达不了的复杂度 |
| 不能装软件的最小系统 | ftrace | tracefs 一直都在 |
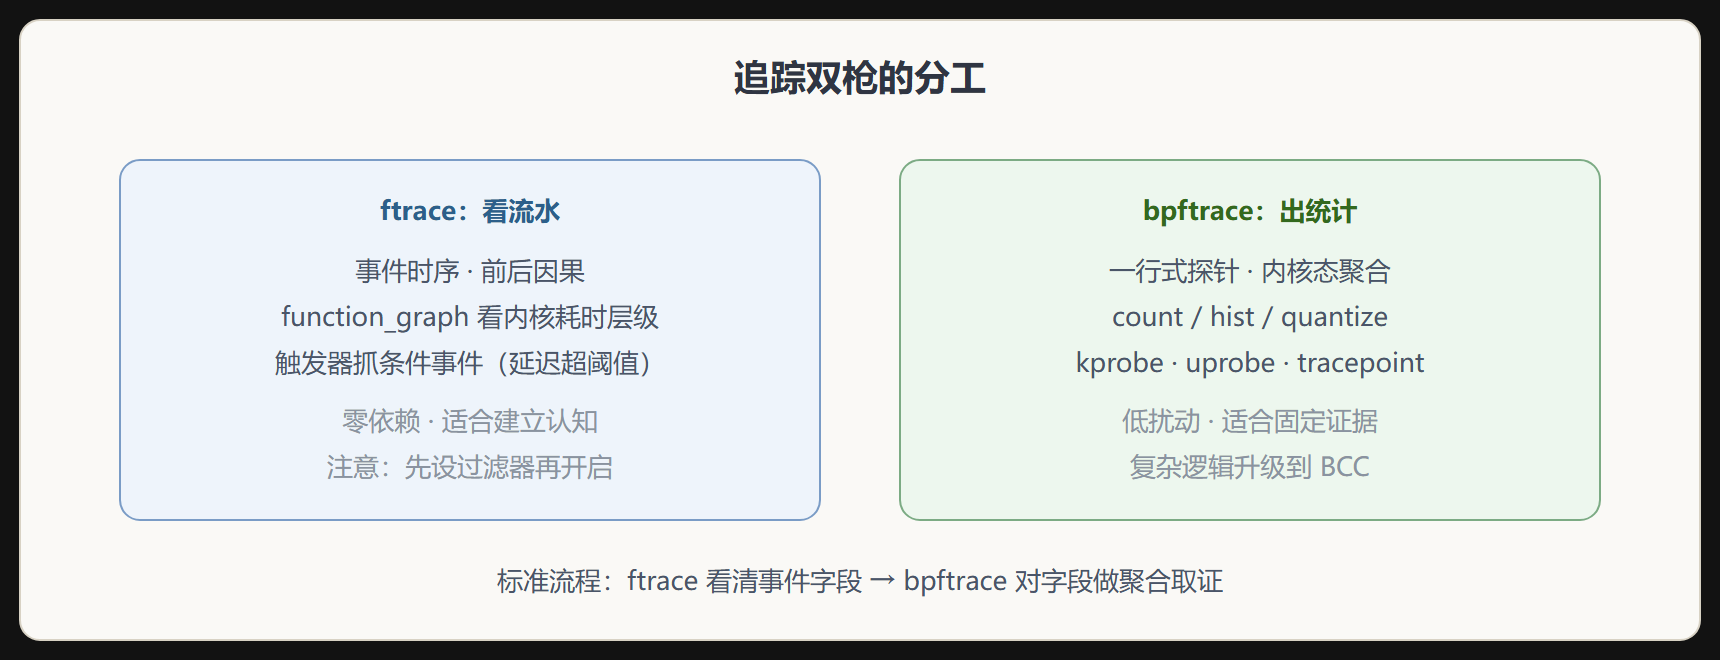
我的习惯:拿不准先开 ftrace 看事件"长什么样",确认事件字段后再用 bpftrace 写聚合。事件流水提供认知,聚合统计提供证据。
ftrace 与 bpftrace 的分工
本节要点回顾
- ftrace 零依赖,事件流水与 function_graph 是建立系统认知的第一手材料;
- 开启 function tracer 前必设过滤器(函数名或 pid),否则事件爆炸拖垮系统;
- bpftrace 语法 = 探针 / 过滤 { 动作 },count 与 hist 覆盖八成取证需求;
- 流水用 ftrace、统计用 bpftrace,认知与证据两步走;
- 复杂工具写 BCC,bpftrace 是轻武器不是重炮。
延伸:用 function_graph 测内核路径耗时
ftrace 的 function_graph 跟踪器给每个内核函数打上耗时,是回答"这次 write 系统调用慢在哪一段"的直接证据:
cd /sys/kernel/tracing echo function_graph > current_tracer echo funcgraph-proc > trace_options echo 'funcgraph_proc' > set_ftrace_pid # 只跟目标进程, 减少噪声 echo 1 > tracing_on; sleep 3; echo 0 > tracing_on head -40 trace # 关注带 '+'(>10us) 与 '!'(>50us) 标记的叶子函数, 即内核侧热点
输出形如 3.567 us | mutex_unlock(),逐级缩进还原整条调用链。定位到具体函数后再换 bpftrace 对该函数做直方图统计,两步完成从"路径"到"分布"的证据升级。
延伸:kprobe 与 tracepoint 的选型原则
同一事件往往 kprobe 和 tracepoint 都能挂,选型原则:优先 tracepoint,其参数结构由内核 ABI 保证,跨版本升级脚本不易碎;kprobe 用于 tracepoint 未覆盖的内部函数,但要接受小版本升级后偏移失效的风险,探针脚本里显式声明"依赖内核版本"并加自检。用 bpftrace -l 'tracepoint:ext4:*' 与 bpftrace -l 'kprobe:ext4_*' 对比可用事件面,把"能挂在哪"变成一份可审查的清单,而不是写脚本时的即兴选择。