2.2 建模与仿真引擎选型
2.2 建模与仿真引擎选型
本节摘要:模型层是数字孪生的大脑,选什么模型直接决定孪生体能不能信。本节把模型分成三类——机理模型、数据驱动模型、混合模型——讲清各自的原理、适用场景和代价,然后对比主流仿真引擎的特点。核心结论是:没有万能模型,物理过程清楚的用机理模型,数据丰富的用数据驱动,最稳的是两者结合的混合模型。
学习目标
阅读完本节,你应当能够:
- 区分机理模型、数据驱动模型、混合模型的建模思路和适用条件
- 说清“保真度”和“计算效率”这对矛盾,以及怎么平衡
- 复述主流仿真引擎(有限元类、系统仿真类、实时仿真类)的特点和适用场景
- 根据一个孪生场景的物理复杂度和数据条件,选出合适的建模路线
- 解释为什么混合模型(机理+数据)是工程上最稳的选择
一、问题与直觉
做孪生项目时,团队里常会吵一架:一拨人说“我们有几十年领域知识,机理方程都写得出,当然建机理模型”;另一拨人说“现在数据那么多,直接上深度学习,让模型自己学”。两边都有道理,但都只对了一半。
纯机理模型的好处是可解释、能外推(没见过的工况也能算),但它有个致命前提——你得把物理过程完全搞清楚。现实是,很多关键过程(材料疲劳、复杂流场、生物代谢)的机理本身就是灰箱甚至黑箱,你写不出准确的方程。硬建机理模型,算出来的结果跟实际差得远,谁也不敢用。
纯数据驱动模型反过来,不需要懂机理,只要有足够多的数据就能学出规律。但它也有致命短板——没法外推。训练数据里没覆盖的工况,它就瞎猜。一个只在常温下训出来的模型,拿到高温工况下预测,可能错得离谱。而且数据驱动模型是黑箱,工程师不知道它为什么这么预测,关键场景下不敢用。
所以真实项目里,两个极端都很少单独用,主流是混合模型——机理管能管的部分,数据驱动补机理管不了的部分。这个判断不是和稀泥,是有深刻道理的。我们把它讲清楚。
二、核心原理
2.1 三类模型的本质差别
理解三类模型,关键是看它们“知识从哪来”。
机理模型的知识来自物理定律。它用微分方程、守恒律这些第一性原理描述系统行为。比如一个弹簧振子,用胡克定律加牛顿第二定律就能写出运动方程,给定初始条件就能算出它未来的运动。机理模型的可信度高、可解释强、能外推,但前提是物理过程清楚、参数可辨识。
数据驱动模型的知识来自历史数据。它不关心物理定律,只用统计或机器学习方法,从大量样本里学到输入到输出的映射。比如一个神经网络,给它几千组“工况参数→故障状态”的样本,它就能学会从工况预测故障。数据驱动模型不需要懂机理,能处理复杂非线性,但不可解释、不能外推、依赖数据质量。
混合模型把两者结合。常见做法有两种:一是用机理模型做骨架,用数据驱动修正它的参数或残差;二是用数据驱动学机理模型算不准的那部分。比如涡轮发动机的机理模型能算出大部分性能,但在某些极端工况下有系统偏差,用数据驱动模型去学这个偏差并修正,整体精度就上去了。
| 模型类型 | 知识来源 | 优点 | 短板 | 适用条件 |
|---|---|---|---|---|
| 机理模型 | 物理定律 | 可解释、可外推、可信度高 | 建模难、算得慢、需机理清楚 | 物理过程已知、参数可辨识 |
| 数据驱动 | 历史数据 | 建模快、能处理复杂非线性 | 不可解释、不能外推、依赖数据 | 数据丰富、工况覆盖全 |
| 混合模型 | 机理+数据 | 兼具两者优点、精度最稳 | 实现复杂、需要两类专长 | 关键场景、对精度要求高 |
2.2 保真度与计算效率的矛盾
不管选哪类模型,都要面对一对核心矛盾:保真度(仿真结果跟现实的吻合程度)和计算效率(算一次要多久)。这俩几乎是此消彼长的。
机理模型里,方程越细、网格越密、考虑的物理效应越多,保真度越高,但计算量呈指数增长。一个零件的应力仿真,粗网格几分钟算完,细网格可能要几小时甚至几天。数据驱动模型里,网络越深、特征越多,拟合能力越强,但推理慢、训练贵。
数字孪生对计算效率的要求特别苛刻,因为它要实时跑。物理实体在动,孪生体得跟着动,不能等你算半天。这就逼着你做取舍:用高保真但慢的模型离线做深度分析,用低保真但快的模型在线做实时响应。这种“快慢结合”的分级策略是工程上的常见解法。
2.3 主流仿真引擎分类
选仿真引擎,先搞清楚它属于哪一类。按仿真对象和实时性,主流引擎大致分三类。
有限元类(FEA/FEM):做连续介质力学仿真的,算应力、应变、流场、热场。特点是保真度高但算得慢,适合离线深度分析,不适合实时在线。常用于零件设计验证、结构强度校核。这类引擎在数字孪生里通常承担“离线精算”的角色。
系统仿真类:做多物理场、多组件系统级仿真的,把一个个子模型(机械、电气、液压、控制)连起来跑整体行为。特点是比有限元快、能做较长时间尺度的动态仿真。适合模拟整个设备或产线的运行。这类引擎在孪生里承担“系统动态”的角色。
实时仿真类:专门为实时场景设计的,能保证在固定时间步长内算完一步,跟物理实体同步运行。常用于硬件在环测试(HIL)和在线孪生。特点是快,但精度通常比前两类低。这类引擎在孪生里承担“在线孪生体”的角色。
| 引擎类型 | 保真度 | 速度 | 典型用途 | 在孪生中的角色 |
|---|---|---|---|---|
| 有限元类 | 高 | 慢 | 应力、流场、热场分析 | 离线精算 |
| 系统仿真类 | 中 | 中 | 多物理场系统动态 | 系统动态仿真 |
| 实时仿真类 | 中低 | 快 | 硬件在环、在线同步 | 在线孪生体 |
具体选哪个引擎,还要看领域。航空航天、汽车有成熟的专用引擎(很多是厂商自己的);工业制造用通用平台(如基于模型化的开放标准);城市、能源这类新兴领域,则常用云端仿真服务。选型时除了功能,还要看生态——模型库丰不丰富、能不能跟你的数据平台集成、二次开发难不难。
三、工程实践要点
3.1 选型决策树
面对一个具体场景,怎么选模型和引擎?可以顺着这么几个问题走。
第一,物理过程清不清楚?清楚、能写出方程的,优先机理模型;不清楚或太复杂的,考虑数据驱动。第二,数据够不够?数据丰富、工况覆盖全的,数据驱动有优势;数据稀疏的,只能靠机理外推。第三,实时性要求高不高?要求在线实时响应的,必须用快模型,保真度做妥协;可以离线算的,上高保真模型。第四,对可解释性的要求?关键安全场景,模型必须可解释,优先机理或混合;非关键场景,数据驱动可以接受。
这四个问题答完,模型类型基本就定了。大多数关键场景的答案是:用混合模型,机理做骨架、数据做修正,既保可信度又提精度。
3.2 模型校准与验证
模型建出来不能用,得校准和验证。校准是用实测数据调模型参数,让模型输出跟现实吻合;验证是用没参与校准的数据检验模型准不准。这两步缺一不可。
⚠️ 常见坑:只在一种工况下校准模型,就以为模型准了。换到另一种工况,预测全错。原因是模型过拟合到了校准工况,没有泛化能力。校准必须覆盖多种典型工况,验证必须用模型没见过的工况数据,这样才知道模型能不能外推。
3.3 混合模型为什么最稳
回到前面说的“混合模型最稳”,这里讲透为什么。
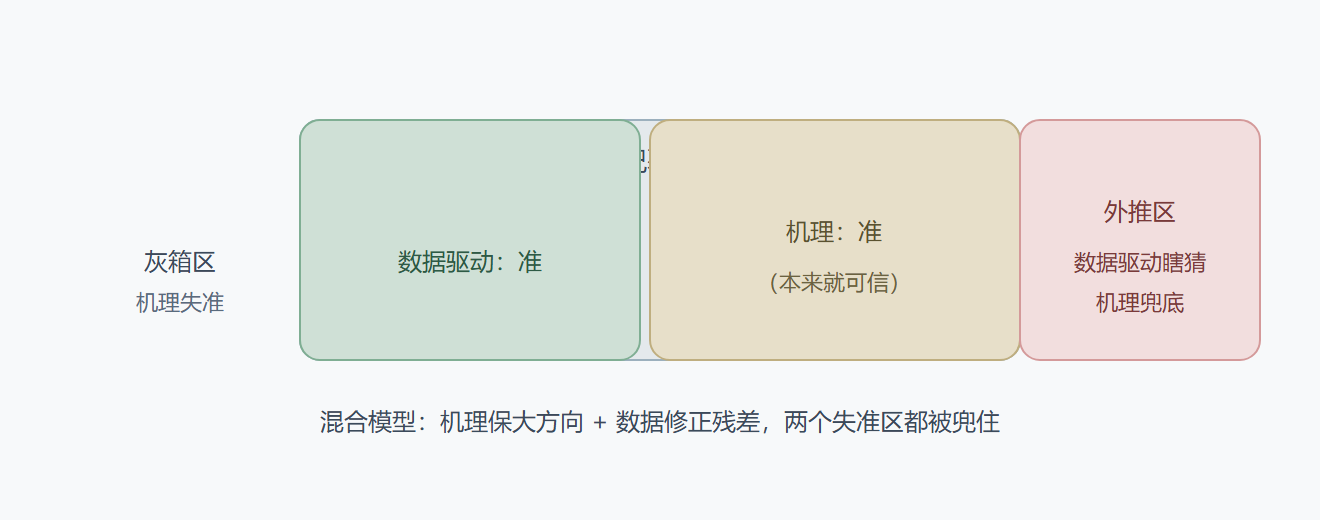
纯机理模型在灰箱区域(机理不完全清楚的部分)会失准,纯数据驱动模型在外推区域(训练数据没覆盖的工况)会失准。混合模型把两者的弱点互补:机理负责“大趋势”,保证外推时大方向不错;数据驱动负责“修正残差”,补机理算不准的那部分。这样即便到了训练数据边缘,机理还能兜底;即便机理有偏差,数据驱动能修正。这就是工程上它最稳的原因。
💡 关键直觉:做关键场景的孪生,别赌单一模型。机理模型是你的“安全网”,保证不会出大错;数据驱动是你的“精度增益”,把准度往上提。两者搭配,既敢用又用得准。
收获清单
- 三类模型:机理(知识来自物理定律)、数据驱动(知识来自数据)、混合(两者结合),知识来源决定各自优劣。
- 保真度矛盾:保真度和计算效率此消彼长,实时孪生逼迫快慢模型分级使用。
- 引擎三类:有限元(高保真慢,离线精算)、系统仿真(中保真中速,系统动态)、实时仿真(快,在线同步)。
- 选型决策:看物理清楚度、数据丰富度、实时性要求、可解释要求四个维度。
- 校准验证:必须多工况校准、留出工况验证,否则模型没有泛化能力。
- 混合最稳:机理兜外推,数据补精度,两者弱点互补,是关键场景的首选。
下一节我们往下走一层,看数据是怎么从设备采上来、怎么存进时序数据库的——这是整个架构的血液系统。
补一段选型谈判的实战经验。引擎选型很少是纯技术决策,供应商生态的锁定效应比数据库和中间件更深——模型文件格式私有、求解器参数不开放、二次开发要专门认证,意味着选了某家引擎,未来五年的升级和维护都绑在它身上。三个防御性做法:合同里写明模型导出的格式义务(至少能导出中性格式,如模型交换标准);关键求解环节保留一条自研或开源的替代路径做压力测试;让团队里至少一个人深入掌握引擎的二次开发接口,而不是只会用图形界面。另外,采购谈判的一个杠杆是"实时孪生场景"这个新需求——传统仿真厂商都在抢这个增量市场,以在线项目为由要测试环境和折扣,往往比按离线仿真采购好谈得多。
图:机理与数据驱动模型的能力边界对比
高频问答两则
问:先建机理还是先跑数据驱动?答:预算和工期紧张时先跑数据驱动拿初步结果验证业务价值,同期立项机理建模——数据模型的三个月 demo 换来的管理层信心,恰好为机理模型的一年周期争取了空间,两条腿交替是多数成功项目的节奏。问:模型精度到多少可用?答:没有通用数字,要跟决策粒度对齐——如果决策是"要不要停机检修",预测误差控制在决策阈值的半个标准差内就够;盲目追求小数点后两位的精度,是把预算花在不会改变任何决策的地方。