2.3 数据采集与时序数据平台
2.3 数据采集与时序数据平台
本节摘要:数据是数字孪生的血液,没有高质量的数据管道,再好的模型也是无米之炊。本节讲采集层的关键技术——工业协议、边缘计算、时序数据库,以及怎么搭一套能支撑高频写入、历史查询、实时订阅的时序数据平台。核心是理解时序数据的三个特征(高频、海量、时间戳为王)以及它们对存储和查询的特殊要求。
学习目标
阅读完本节,你应当能够:
- 说清工业现场常见的数据采集协议及其适用场景
- 解释边缘计算在采集层的作用,以及它和云端的分工
- 区分时序数据库和关系型数据库的设计差别
- 为一个孪生场景设计基本的时序数据采集与存储管道
- 评估主流时序数据库的适用场景
一、问题与直觉
做过物联网项目的人都知道,把数据从设备采到服务器,听起来简单,做起来全是坑。设备型号五花八门,通信协议一个厂家一个样;信号采上来到处是噪声和缺失;数据量一大,写入和查询都成问题。一个工厂几百台设备,每台几十个测点,每秒采一次,一天下来就是几亿条数据,存哪儿、怎么查、怎么不丢,每个都是工程难题。
数字孪生对数据的要求比普通物联网更苛刻。普通监控丢几条数据无所谓,孪生体要跑模型预测,数据一旦有时序错乱或大面积缺失,模型结果就不可信。所以孪生项目的数据管道,必须在采集、传输、存储三个环节都做到高质量。
这一节我们就把这条管道讲清楚。从设备端的协议,到边缘的预处理,再到云端的时序存储,看数据是怎么一步步变成模型能用的东西的。
二、核心原理
2.1 采集协议:工业现场的巴别塔
工业现场的数据采集协议,是个名副其实的巴别塔——几十种协议并存,新老交替。老设备用 Modbus、OPC DA 这些传统协议,新设备用 OPC UA、MQTT,还有些厂商用自己的私有协议。采集层的第一件事,就是把这些异构协议统一成一种内部格式。
| 协议 | 特点 | 典型场景 |
|---|---|---|
| Modbus | 简单、老牌、串行为主 | 老旧 PLC、传感器 |
| OPC UA | 工业标准、带信息模型 | 新型工业设备、跨厂商互联 |
| MQTT | 轻量、发布订阅、适合广域网 | 物联网设备、云端通信 |
| HTTP/REST | 通用、易集成 | 边缘到云端、第三方系统 |
实际项目里,网关通常要同时支持多种协议,把来自不同设备的数据统一成 MQTT 或 OPC UA 这种标准格式往上传。这一步叫协议转换,是采集层最琐碎但也最绕不开的工作。协议没打通,后面的数据管道都是空中楼阁。
2.2 边缘计算:在源头做预处理
数据采上来直接全传云端,会带来两个问题:一是网络带宽吃不消,几百台设备的高频数据全传,专线都扛不住;二是延迟高,云端处理完再返回,实时性要求高的场景等不起。
边缘计算就是解这两个问题的。它在离设备近的地方(网关、边缘服务器)先做一些预处理,只把有价值的数据或初步结果传到云端。常见的边缘处理有这么几类:
滤波降噪:原始信号里有大量噪声,边缘先做滤波(滑动平均、卡尔曼滤波),把干净的数据传上去。数据压缩:高频数据里有很多冗余,边缘做降采样或变化点检测,只在数据变化时才上报。异常初筛:边缘跑简单的阈值判断,发现异常立即本地报警,不等云端。协议转换:前面说的,把异构协议转成统一格式。
边缘和云端不是二选一,而是分工。边缘做实时、轻量、本地的处理;云端做批量、复杂、全局的分析。这个分工在第 5 章讲实时性权衡时还会展开。
2.3 时序数据库:为时间序列而生
数据存到云端,用什么存?关系型数据库(MySQL、PostgreSQL)能存,但不合适。时序数据有三个鲜明特征,逼着要用专门的时序数据库(TSDB)。
高频写入:时序数据是持续不断地写入的,每秒成千上万条,关系型数据库的行锁和索引会成瓶颈。时序数据库针对追加写入做了优化,写入吞吐量高一个数量级。
海量数据:时序数据只增不减,时间一长数据量爆炸。时序数据库用列式存储、数据压缩(很多相邻数据点差异小,压缩率极高)、自动过期(老数据自动降采样或删除)来应对。
时间戳为主的查询:时序数据的查询几乎都带时间范围(“查最近一小时的振动数据”),时序数据库按时间索引,这类查询极快。关系型数据库没有专门的时间索引优化。
| 特性 | 关系型数据库 | 时序数据库 |
|---|---|---|
| 写入吞吐 | 中(受行锁、索引影响) | 高(追加写优化) |
| 数据压缩 | 一般 | 高(列存+增量编码) |
| 时间范围查询 | 中 | 极快(时间索引) |
| 数据生命周期 | 需手动管理 | 自动降采样与过期 |
| 复杂关联查询 | 强 | 弱 |
选时序数据库,除了看这几个特性,还要看生态。能不能跟你的消息队列、流处理框架、可视化工具无缝集成,往往比单纯的性能数字更重要。
2.4 一个基础的时序数据管道
把上面三块拼起来,一个基础的孪生数据管道长这样:设备通过各类协议把数据送到边缘网关,网关做协议转换和预处理后,用 MQTT 把数据发到云端的消息队列;流处理框架从队列消费数据,做实时计算和异常检测,结果写进时序数据库;时序数据库同时支持模型层的历史查询和其他系统的实时订阅。
这条管道里,消息队列是个关键的缓冲。设备数据是持续涌入的,如果下游(流处理、数据库)偶尔抖动,队列能缓冲一下,避免数据丢失。没有这个缓冲,下游一卡,数据就丢,孪生体的数据完整性就崩了。
三、工程实践要点
3.1 数据质量比数据量重要
做数据管道,新手容易陷入“采得越多越好”的误区,恨不得把每个测点都高频采。但数据量上去了,质量没跟上,模型反而被脏数据带歪。
数据质量有几个维度要盯:完整性(该有的数据点有没有丢)、准确性(数值对不对、传感器有没有漂移)、一致性(同一时刻不同测点的时间戳对不对齐)、时效性(数据从产生到可用延迟多大)。这四个维度任何一个出问题,模型可信度都受影响。
⚠️ 常见坑:拼命堆数据量,却忽略了时间戳对齐。不同测点采样的时刻不完全一致,直接拿来做多变量分析,相当于拿错时刻的数据凑在一起,结果当然不对。时间戳对齐(重采样到统一时间网格)是时序数据预处理里最基本也最容易被忽略的一步。
3.2 数据降采样与生命周期管理
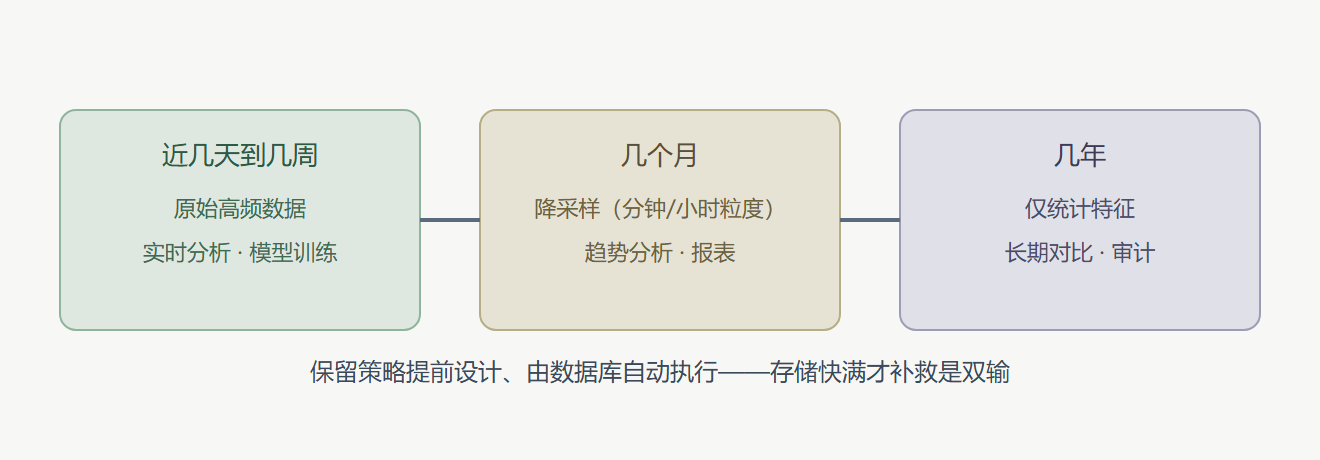
时序数据只增不减,全量保留成本扛不住,也没必要。实际做法是分级保留:近期数据(最近几天到几周)保留原始高频数据,供实时分析和模型训练;中期数据(几个月)降采样到较低频率,供趋势分析;远期数据(几年)只保留统计特征(均值、峰值),供长期对比。
这个降采样策略要提前设计好,让时序数据库自动执行。临到存储快满了才想办法,要么丢数据要么花大钱扩容,都很被动。
💡 关键直觉:存数据要想清楚“将来用它干嘛”。只为了“以备不时之需”而全量囤数据,是最贵的偷懒。明确每类数据的消费场景,按消费需求定保留策略,既省钱又好用。
3.3 流批一体:实时和离线的统一
孪生的数据处理既有实时需求(在线异常检测、实时预测),又有离线需求(模型训练、历史回放)。传统做法是搭两套管道,一套实时一套离线,结果两边数据口径不一致,算出来的结果对不上。
现在主流是流批一体——同一套处理逻辑,既能跑在实时流上,也能跑在历史批上。这样保证实时和离线的结果一致,也省了维护两套代码的成本。选流处理框架时,优先考虑支持流批一体的。
要点沉淀
- 协议巴别塔:工业现场几十种协议并存,采集层的第一件事是协议转换,统一成 MQTT 或 OPC UA。
- 边缘计算:在源头做滤波、压缩、异常初筛,减轻带宽和延迟压力,和云端分工而非替代。
- 时序数据库:为高频写入、海量存储、时间戳查询而生,关系型数据库不适合存时序数据。
- 数据管道:设备→边缘网关→消息队列→流处理→时序数据库,消息队列是关键缓冲。
- 数据质量:完整性、准确性、一致性、时效性四个维度,比数据量更重要,时间戳对齐最易被忽略。
- 生命周期:分级保留(原始→降采样→统计特征),按消费需求定策略,别全量囤。
下一章我们将进入模型层之上的智能能力,看在数据和模型都就绪后,孪生体能做哪些诊断、预测和优化。
补一组时序数据库选型的对比要点,把本节的"为什么用专用时序库"落到具体维度。对比关系型数据库,时序库的三个结构性优势:写入吞吐(针对追加写优化,单机每秒百万点级,关系型到十万级就开始痛苦)、按时间范围的查询下推(老数据的压缩比可达十倍以上,存储成本差出一个量级)、内置的连续查询和保留策略(降采样交给数据库自动做,不用自己写定时任务)。时序库彼此之间的差异主要看四点:标签基数支持(一个工厂几十万设备标签,有的库高基数下性能崩塌)、乱序数据容忍(工业现场时钟漂移和数据补传很常见,有的库处理乱序代价高)、生态连接器(和你消息队列、流计算框架的现成集成)、以及社区版与商业版的功能边界。选型时拿真实的标签规模和乱序比例做一轮注入测试,比看任何评测报告都准——高基数和乱序恰恰是评测集最常回避的两项。
图:时序数据分级保留的生命周期
收尾问答
问:历史数据已经散在各 MES 和 Excel 里,怎么办?答:先做一次数据考古(摸清每类数据的字段、频率、质量),再定迁移优先级——优先迁模型训练最需要的核心测点,其余的按需补迁;追求一次性全量治理往往一年后还在治理。问:边缘和云端各存什么?答:边缘存最近几天的高频原始数据(断网时本地可用),云端存全量降采样加关键测点原始数据;两侧数据经同一套管道汇流,避免口径分裂。