4.1 手撕算法高频题精讲
4.1 手撕算法高频题精讲
本节摘要:手撕算法是技术面试的第一道滤网,考察的不是智力而是可靠性。本节先说清评分维度——正确性只是及格线,沟通、边界处理和复杂度分析同样计分;再逐族精讲二分查找、双指针与滑动窗口、链表与栈队列、动态规划四大高频题族,每族给一个模板、一类变形识别法和一道经典题的完整口述示范;最后给出"边写边讲"的训练方法。
学习目标
阅读完本节,你应当能够:
- 复述手撕环节的五个评分维度,并对照自查
- 手写二分查找及其四种边界变形,不再纠结左右边界
- 识别双指针和滑动窗口的适用信号,套模板秒解中等题
- 说清动规的三要素定义,并完整推导一道经典 DP
- 练成"边写边讲"的习惯,消灭考场冷场
手撕环节到底在评什么
很多候选人以为手撕环节只有一个维度:做没做出来。实际上多数公司的面试官会从五个维度打分:解题思路是否清晰(你能否在动笔前用两分钟说清暴力解法和优化方向)、代码是否正确(含边界条件)、沟通是否持续(沉默写代码是大忌)、复杂度分析是否准确(时间和空间都要主动给)、代码风格是否可读(变量名、缩进、必要注释)。这意味着一个把题做出来但全程沉默、变量名全是单字母的候选人,可能输给一个没完全做出来但把思路讲得清清楚楚的候选人。
理解了评分维度,备考策略也随之改变:刷题时永远动口——每道题强迫自己先口述思路再动手,写完后主动说复杂度。这个习惯比多刷两百道题更值钱。
二分查找族:把边界焊死
二分是"人人会写、人人写错"的典型:死循环、差一位、漏目标。根治方法是统一模板,永远用左闭右闭区间,循环条件写小于等于,更新时左右边界都越过中点。
def binary_search(arr, target): lo, hi = 0, len(arr) - 1 while lo <= hi: mid = (lo + hi) // 2 if arr[mid] == target: return mid if arr[mid] < target: lo = mid + 1 else: hi = mid - 1 return -1
四种变形各有信号:找左边界(第一个大于等于目标的位置)在收缩时相等也往左压;找右边界对称处理;旋转数组先判断哪半边有序再决定去留;答案单调性二分(如"最小的满足条件的值")把答案空间当成数组二分。面试口述时先声明"我用左闭右闭模板",这句话本身就在展示工程素养。
双指针与滑动窗口:识别信号
这一族的信号词是"有序数组""原地操作""子串/子数组"。双指针的模板是对撞(两端向中间)或快慢(同向不同速),滑动窗口是快慢指针加哈希计数的组合。以"最长无重复字符子串"为例,口述示范:右指针扩张,哈希记录字符频次,出现重复时左指针收缩直到窗口合法,全程维护窗口长度最大值,时间复杂度是每个字符最多被两个指针各访问一次,线性。
def length_of_longest_substring(s): seen = {} left = best = 0 for right, ch in enumerate(s): if ch in seen and seen[ch] >= left: left = seen[ch] + 1 seen[ch] = right best = max(best, right - left + 1) return best
注意这道题的细节:判断重复时必须确认旧位置在当前窗口内(大于等于左指针),否则会把已经移出窗口的字符误判为重复。这类"边界条件讲不讲得清"正是面试官的观察点。
动态规划:三要素定生死
动规题的失分几乎都败在状态定义。三要素:状态定义(用一句话说清 dp 数组每个格子的含义)、转移方程(格子之间怎么推)、初始条件与遍历顺序。以打家劫舍为例示范完整口述:状态定义是"考虑前 i 家时能偷到的最大金额",转移是"第 i 家偷不偷取较大值——不偷则继承前一家的结果,偷则取前两家结果加当前金额",初始是第一家和第二家的直接值,时间空间都是线性,空间可滚动优化到常数。
背包、编辑距离、最长公共子序列是另外三个必练母题,AI 岗还常考的变形是把 DP 和字符串编辑结合(如"两单词的最小删除步数"本质就是 LCS)。练 DP 的正确姿势是先手推表格再写代码——在纸上画出行列、填出前几个格子,转移方程自然浮现,比盯着屏幕空想高效十倍。
从模板到临场:边写边讲的训练法
模板解决"会不会",临场表现解决"过不过"。训练方法很朴素:每道题限时二十五分钟,全程录音,先花三分钟口述暴力解法和优化思路,再动手写,写完主动报复杂度和一组测试用例,回放录音找冷场点和口误。两周之后,你会发现自己在大脑卡壳时嘴上依然能维持"这里我在考虑边界情况"的说明流——这正是面试官眼中的"思路清晰"。另一个高频临场问题是"没见过这题怎么办":标准动作是先给暴力解保底,再从数据规模反推期望复杂度(数据量十万对应线性或线性对数,一万对应平方,二十以内可指数),从期望复杂度倒推应该用的算法族。这个"数据规模—复杂度"对照表值得背下来,它是陌生题的指南针。
下一节离开代码编辑器,看开放性的系统设计环节怎么把工程思维讲成加分项。
五道必练母题的完整口述
第一题,旋转数组查找。 口述:数组被旋转过但两半各自有序,二分的变形——每次先判断 mid 落在哪个有序半区,若左半有序且目标在左半区间内则去左半,否则去右半,对称处理右半有序的情况。时间对数,空间常数。陷阱是数组含重复元素时最坏退化为线性,要主动提这个边界。
第二题,合并两个有序链表。 口述:哑结点起步,双指针比较两链表当前头,小的接到结果链上并后移,一方耗尽后直接挂另一方剩余。时间线性,空间常数。追问常是无哨兵版怎么写,以及递归版为什么空间是线性(调用栈)。
第三题,LRU 缓存。 口述:哈希表加双向链表的组合,哈希表提供键到结点的定位,双向链表维护访问序;get 命中则把结点搬到头部,put 满了则删除尾部。两个操作都是常数时间。这道题是工程味的最佳展示——它就是 Redis 和操作系统页面置换的真实机制。
class LRUCache: def __init__(self, capacity): self.cap = capacity self.map = {} # key -> node self.head, self.tail = Node(), Node() self.head.next, self.tail.prev = self.tail, self.head def _move_to_front(self, node): node.prev.next, node.next.prev = node.next, node.prev node.next, node.prev = self.head.next, self.head self.head.next.prev = node self.head.next = node def get(self, key): if key not in self.map: return -1 node = self.map[key] self._move_to_front(node) return node.value def put(self, key, value): if key in self.map: self.map[key].value = value self._move_to_front(self.map[key]) return node = Node(key, value) self.map[key] = node node.next, node.prev = self.head.next, self.head self.head.next.prev = node self.head.next = node if len(self.map) > self.cap: victim = self.tail.prev victim.prev.next = self.tail self.tail.prev = victim.prev del self.map[victim.key]
第四题,无重复字符最长子串。 前文已给完整代码,口述要点是滑动窗口加哈希索引,注意旧位置必须大于等于左指针才算在窗口内。追问常是"扩展为至多 k 个重复字符",答法是把哈希从索引改成计数,窗口合法条件变为不同字符数不超限。
第五题,二叉树的层序遍历。 口述:队列驱动,每层先记录当前队列长度再循环弹出,天然得到分层结果。空间是宽度量级,最坏整层结点。它的变形极多:锯齿遍历(层序加奇偶翻转)、右视图(每层最后一个)、最小深度(首次遇到叶子即返回),全部是同一模板的参数变化——练透一题等于拿下五题。
复杂度速查表
| 数据规模 | 期望时间复杂度 | 对应算法族 |
|---|---|---|
| 20 以内 | 指数或阶乘 | 状压、回溯、暴力排列 |
| 3000 以内 | 平方 | 双重循环、简单 DP |
| 10 万级 | 线性对数 | 排序、二分外层、堆 |
| 千万级 | 线性 | 哈希、双指针、滑窗 |
| 亿级以上 | 对数或常数 | 位运算、数学公式、并查集 |
这张表的价值在临场:读完题看一眼数据范围的约束,期望复杂度就锁定了,能用的算法族直接缩小到一两个。它是陌生题的破题指南针。
刷题的边际策略
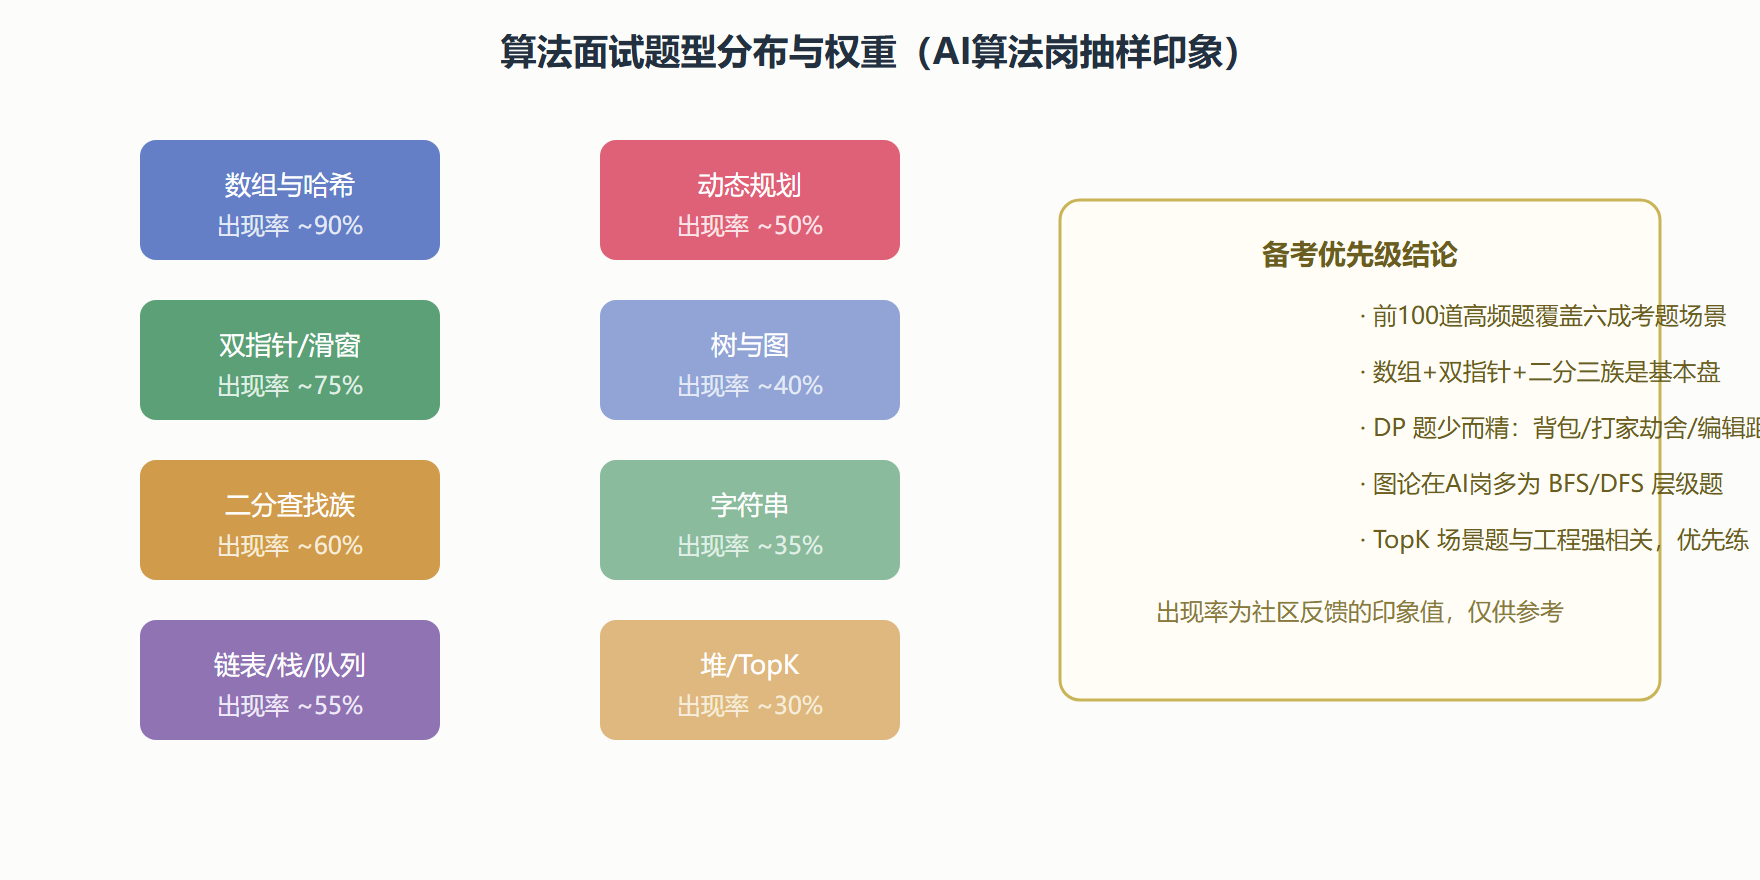
最后算一笔备考的边际账:前一百道高频题覆盖了绝大多数面试场景,第二个一百道覆盖率提升骤降,第三个一百道基本是为了心理安全感。把重复刷三遍的钱一百道的力气省下来,投给"每题一次口述录音"和"每族一次模板手写",回报率高得多。面试不是学术竞赛,它是稳定性的比拼——把会的题全部做对,胜过把难题做出一半。
链表与栈队列:指针操作的安全网
链表题的失分几乎全是引用丢失——把指针指过去之前忘了先存后继。两条安全网:其一,改动指针前先把要用的结点都存进局部变量,再统一改指向;其二,哑结点起步,凡是"可能删除头结点"的操作一律用哑结点兜底,消灭头结点特判。经典题反转链表的口述:三指针迭代,prev 初始为空,cur 每次先把下家存进 temp,再把 cur 指向 prev,然后整体右移一格。追问是区间反转(先走到区间左端点再做局部反转再接回去)和 k 个一组反转(递归或迭代都行,关键是最后不足 k 个保持原序)。
def reverse_between(head, left, right): dummy = Node(0, head) prev = dummy for _ in range(left - 1): prev = prev.next cur = prev.next for _ in range(right - left): temp = cur.next cur.next = temp.next temp.next = prev.next prev.next = temp return dummy.next
栈队列的高频组合是单调栈:下一个更大元素、柱状图最大矩形、每日温度,全是同一模板——维护一个栈内单调的栈,新元素比栈顶大则弹栈结算。口述每日温度:栈存下标,遍历温度,当前温度高于栈顶下标对应温度时弹栈并结算答案,差值就是天数。单调栈的本质是"每个元素最多进出栈各一次",所以线性。识别信号是题目问"下一个比它大/小的元素在哪"。
图与堆:AI 岗的高频子集
AI 岗的图论题集中在两块:遍历层级(岛屿数量、课程表、克隆图)和拓扑排序(依赖解析)。岛屿数量口述:双循环扫格子,遇到陆地做深度优先泛洪把整片岛标记为已访问,泛洪次数即岛数。课程表是拓扑排序——建边、统计入度、入度为零的进队列、出队时把后继入度减一,全部出队则无环。堆的考点集中在 TopK:数据流第 k 大用容量 k 的小顶堆,维护代价 log k;前 k 个高频元素用哈希计数加堆或桶排序。TopK 的识别信号是"只要前 k 个不要全体有序",这时候堆优于排序,因为 n log k 好于 n log n。
考场心理的技术化解法
紧张的本质是注意力被结果占用了。两个技术化解法:其一,把开场两分钟固化成仪式——自我介绍、项目一句话、进入题目,前两分钟的高度可预测会显著降低心率的不可控感。其二,遇到卡壳时启动标准动作:复述题目、给出暴力解、从数据规模反推,这三步给了大脑缓冲时间,同时向面试官输出"我在系统思考"的信号。记住面试官的隐含立场:他希望你能过——招聘的成本同样由他承担,你是来合作解题的,不是来受审的。