4.2 系统设计与开放问题
4.2 系统设计与开放问题
本节摘要:系统设计环节没有标准答案,只有推理过程。本节给出一套五步框架——需求澄清、容量估算、接口与数据模型、架构分层、演进与权衡,然后用它完整走一遍"设计一个 AI 推理服务"的例子(AI 岗位版短链服务),最后讲清权衡类开放问题(如"批处理还是流处理""自建还是上云")的应答结构。
学习目标
阅读完本节,你应当能够:
- 用五步框架组织任何系统设计回答,不漏关键环节
- 做量级估算:QPS、存储、带宽的快速心算
- 画出模型服务的分层架构并解释每层的存在理由
- 用"维度对比+场景锚定"的结构回答开放权衡题
- 识别面试官的引导信号,把设计往加分方向调整
为什么要有框架
开放题最大的风险不是答错,而是漫无边际。没有框架的候选人通常直接开始画框图,被追问"这个服务预期多大流量"时才意识到自己跳过了需求澄清。框架的价值是保证你在四十分钟里稳定覆盖所有得分点,并且让面试官看到你的思考是有序的——这本身就是工程素养的展示。
五步框架与一个完整示例
以"设计一个支撑千万日活的图像审核模型服务"为例走一遍五步。
第一步需求澄清,问三类问题:功能性(只判违规类别还是要给出具体类别和置信度?延迟要求多少?)、非功能性(可用性几个九?一致性要求强还是最终?)、规模(日活千万、人均上传几张?)。这一步的关键是"先问再画",哪怕你心里已有方案,也要把这些问题抛出来——提问本身就是得分行为。
第二步容量估算:千万日活、人均上传三张、活跃集中在四小时,峰值 QPS 约为总量除以高峰秒数,算出每秒数千次请求;单张图推理 fifty 毫秒(GPU 批量推理下),得出需要的 GPU 卡数量等于 QPS 乘以单次耗时再除以单卡吞吐;存储方面,若需留存原图三十天,按每天三千万张乘以平均两兆再乘三十天,得到约两 PB 的量级。估算不追求精确,追求量级正确和每一步可追溯——把假设大声说出来,让面试官能纠正你。
第三步接口与数据模型:接口通常是异步提交加回调或轮询的模式(同步推理在峰值下会拖垮服务);数据模型要分清热数据(待审核队列、结果缓存)和冷数据(原图归档、审计日志)。这一步容易被跳过,但它是"考虑过实际使用"的证据。
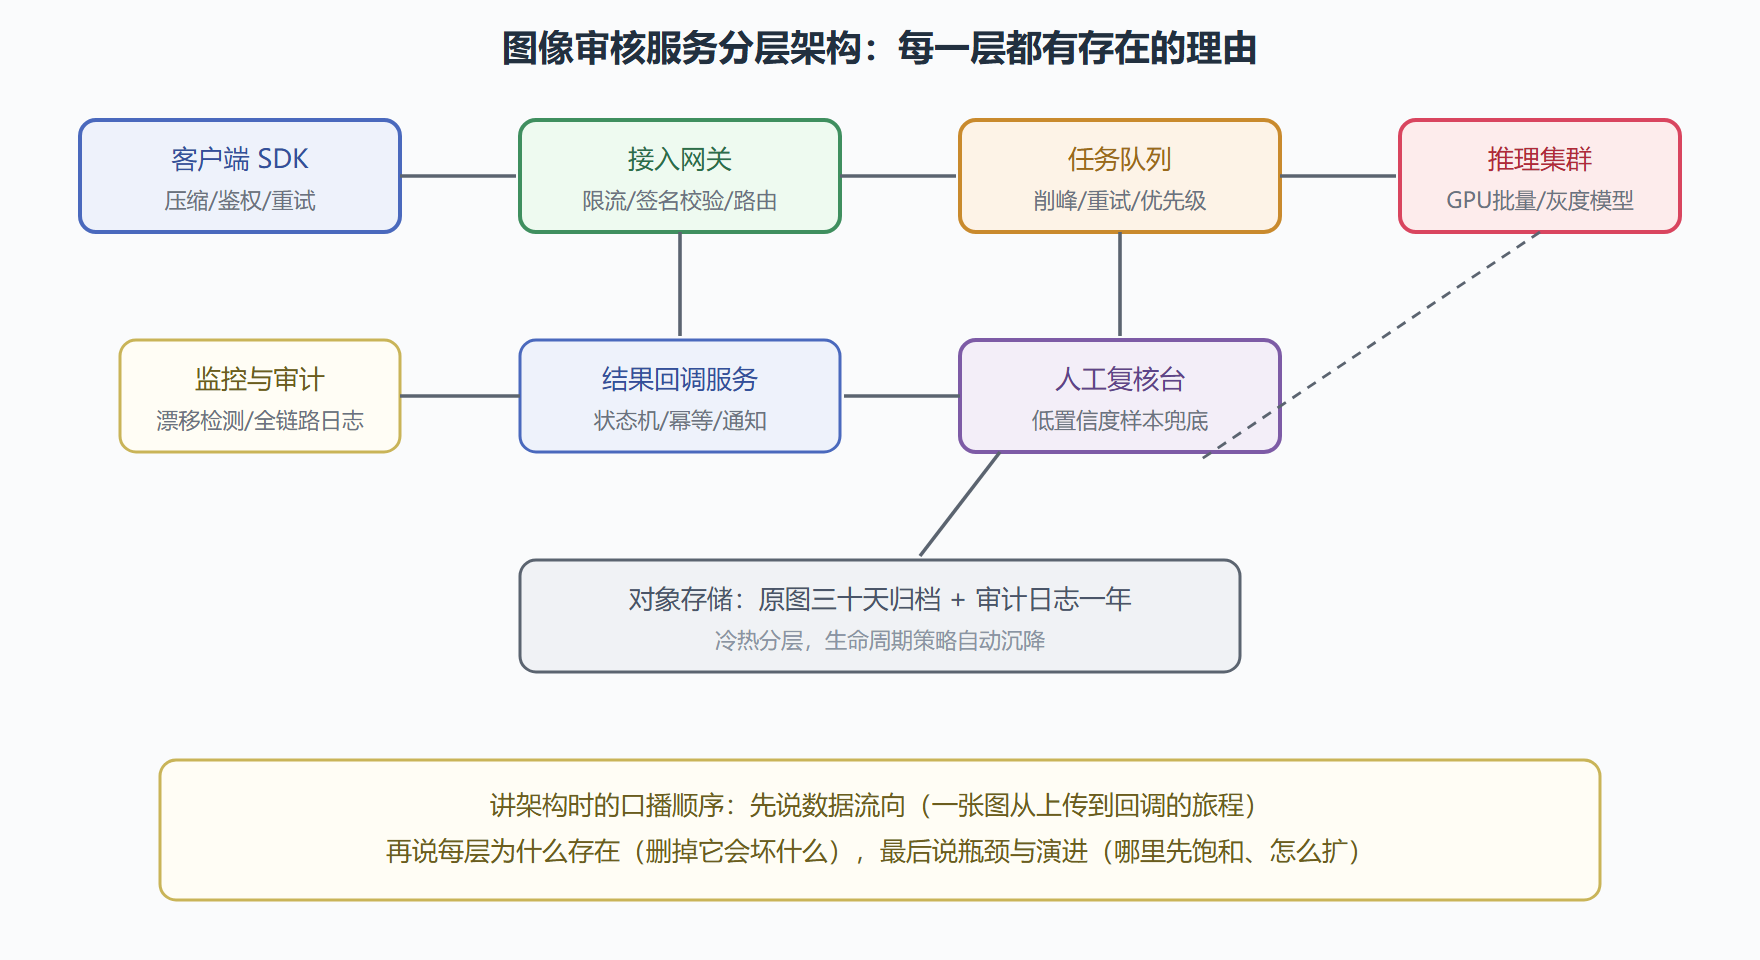
第四步架构分层:如上图。讲图时按数据流走一遍,再对每一层回答"为什么需要它"——队列是为了削峰和失败重试,人工复核是模型精度不足的运营兜底,监控层承担分布漂移的发现职责。
第五步演进与权衡:主动指出当前设计的三个瓶颈和对应预案——GPU 成本随流量线性上涨(引入模型蒸馏和量化降低单次成本)、恶意上传攻击推理集群(接入层加内容预检和频率限制)、模型迭代需要灰度(按流量百分比切分新旧模型对比指标)。最后主动收尾:"如果流量再涨十倍,优先扩推理集群和队列分区,存储改纠删码"。这个收尾展示了你thinking beyond当前规模。
开放权衡题的应答结构
"批处理还是流处理""自建机房还是上云""用 BERT 还是用大模型 API"这类问题的应答结构是"维度对比+场景锚定":先列三到四个对比维度(成本、延迟、运维复杂度、团队技能),每个维度给两方案的定性比较,然后锚定一个具体场景给出你的选择和理由。以"模型自研还是调 API"为例:维度是数据敏感性(敏感数据必须私有化)、边际成本(调用量大时自研摊薄)、迭代速度(API 即开即用)、效果上限(自研可针对领域微调)。锚定场景:初创公司验证期选 API,量起来且数据敏感后逐步自建。这个结构保证你既展示了全面性,又展示了决断力——只对比不选择是面试大忌。
三个常见失误
其一,上来就画框图跳过澄清,被反问后推倒重来,暴露无序。其二,只有 happy path 没有失败路径——限流、降级、重试幂等这些"坏情况设计"恰恰是资深感的来源。其三,堆砌名词没有取舍——把消息队列、缓存、多活全塞进图里却说不出各自解决什么问题。记住:设计的本质是取舍的展示,每加一个组件都要能回答"它换来了什么、付出了什么"。
下一节离开技术本身,讲行为面和求职策略——它决定前面所有努力能否兑现成 offer。
第二道完整例题:短链服务
再走一遍五步框架,这次换经典题"设计短链服务",用最紧凑的节奏展示框架如何复用。
需求澄清:问清跳转延迟要求(通常十毫秒级,301 还是 302)、自定义短链是否支持、过期策略、点击统计是否需要。规模假设:每天新链一千万条,读跳转是写的百倍量级,峰值读 QPS 数万。
容量估算:短链按七位 base62 编码,六十二的七次方约等于三点五万亿,容量富余;存储按每天一千万条记录、每条两百字节,五年不到两 TB,单库可扛但读写分离是必须的(读写比一百比一)。
发号与编码的三种方案对比——这是本题的得分核心:
| 方案 | 机制 | 优点 | 缺点 |
|---|---|---|---|
| 自增 ID 加 base62 | 分布式发号器发整数,转六十二进制 | 简单、无冲突、有序 | 可被枚举爬取,ID 泄露总量信息 |
| 哈希截取 | 对长链做哈希取前七位 | 无中心依赖 | 冲突要重试或加盐,长度浪费 |
| 预生成号池 | 离线批量生成随机短码入队列 | 抗枚举、削峰 | 多一套号池组件,复杂度上升 |
架构分层:接入层无状态可横向扩,缓存层用 Redis 热点短码(读写比高决定命中率可观),存储层主从加读写分离,统计链路异步投递到消息队列再落分析库——绝不能让统计同步阻塞跳转。这一句"绝不能"就是权衡意识的展示点。
演进与收尾:主动指出两个风险——热点短链打穿缓存(加多级缓存和请求合并)、恶意短链(接入层加内容安全预检与频控)。收尾句:"当前设计支撑到日新增五千万没有结构性瓶颈,再往上优先分库分表并把统计完全剥离出主链路。"
估算题的常数背包
容量估算不背常数就没法心算。常用的几个:一天约八万六千秒,估算用十万即可;千万日活集中在四小时高峰,平均峰值 QPS 约等于日请求量除以一万五千;一 GB 网口每秒约一百兆字节,够传两百张五百 KB 的图;GPU 单卡 batch 推理每秒几十到几百张取决于模型大小。把这些常数当乘法口诀背熟,估算环节就能从"卡壳重灾区"变成"行云流水的加分项"。
白板表达的三个细节
细节一,画图先画边界框再填内容,边画边说,让面试官的注意力跟着你的笔走。细节二,每个组件标上存在理由的关键词(队列标"削峰"、缓存标"命中率"),图本身就是你的提词器。细节三,被挑战时不防御——"这个质疑有道理,如果真要支持那个场景,我会在这里加……",把挑战当成免费的设计输入。面试官挑战你往往不是你错了,而是想看你被挑战后的思考质量。
AI 岗特有:模型服务化设计的考点清单
AI 岗的系统设计有一批专属考点,常规软件设计的候选人在这里是裸区,算法背景的候选人优势极大,务必吃透。
GPU 利用率与批处理:单条请求独占 GPU 时利用率极低,批处理把多条请求拼批推理,吞吐提升数倍代价是延迟增加。设计时要回答动态批的等待窗口多长(延迟预算减去推理耗时)、批满即发还是超时即发。追问点在延迟和吞吐的帕累托前沿怎么选。
KV 缓存与显存管理:大模型推理的显存大头是 KV 缓存,它随序列长度线性增长。设计要点:缓存的淘汰策略(LRU 或按会话活跃度)、前缀缓存(系统提示部分共享)、量化缓存(FP8 缓存几乎无损)。这些细节是区分"用过推理服务"和"读过博客"的硬指标。
模型版本与灰度:新模型上线不能一刀切。按流量百分比灰度,护栏指标(拒答率、延迟分位、敏感命中率)异常自动回滚。版本管理的粒度是"模型加配置加预处理"三位一体——三者任何一方变化都构成新版本,这个认知很多候选人缺。
降级链路:大模型超时或过载时怎么办?降级到小模型、降级到缓存结果、还是直接报错重试?设计答案是分业务:对话场景降级小模型保可用,结构化抽取场景宁可报错不能错抽。降级链路是可用性设计的最后一环,主动讲出来是资深信号。
一道开放题的现场示范
以"自建推理集群还是调 API"的完整应答做示范,展示"维度对比加场景锚定"的落地形态。先立维度:数据敏感性(合规要求私有化的必须自建)、成本结构(API 按量线性,自建是固定投入加边际递减,日请求千万级时自建的单次成本可比 API 低一个量级)、迭代速度(API 免运维即开即用,自建要养团队)、能力上限(自建可微调可定制推理策略,API 受限于厂商提供的能力面)。再锚定场景:日请求十万级以下的业务,API 的简单性完胜;日请求千万级且数据敏感的,自建加开源模型微调是主流选择。最后给判断加一句弹性:"中间态的业务可以先 API 验证再逐步迁移,迁移的触发条件是月账单超过自建成本的三分之一。"这个收尾把答案从"选边站"升级为"给出决策函数",是开放题回答的最高形态。
估算实战:从模糊到量级
补一道完整估算示范。题目:一个日活五百万的图像类 App,每天的图片存储增量大概多少?推理链:日活五百万,活跃用户人均上传八张,其中三成会压缩到原图的三分之一,其余按平均三兆算——日新增约五百万乘八乘三兆再打个七折量级修正,约百 TB 每天?不对,八十四 PB 明显高估,回检:三兆乘四千万张是一百二十万 GB 即约一点二 PB,量级修正后日增约 1 PB。看出问题了吗——这类回检的习惯比算得快更重要,估算的价值在于量级正确,差三倍内都算命中。面试官要看的正是你"边算边自检"的工程本能,而不是心算速度。