3.5 监控与日志栈模板
3.5 监控与日志栈模板
本节摘要:监控与日志栈模板给出 Prometheus、Grafana、Node Exporter 三件套的完整 compose 配置:Prometheus 负责抓取与存储指标并评估告警规则,Grafana 负责可视化与看板,Node Exporter 负责暴露主机指标。配置覆盖抓取目标、数据源预置、告警规则文件挂载,并集中处理抓取地址、时间戳对齐、卷权限三类高频坑。
本节地图
- 能说清 Prometheus、Grafana、Node Exporter 三个组件的职责边界
- 能写出带抓取配置和告警规则挂载的完整监控栈
- 能用 provisioning 预置 Grafana 数据源,避免手动点击配置
- 能解释抓取目标为何写服务名、时间戳为何要对齐
- 能处理 Grafana 与 Node Exporter 的卷权限问题
一、先分清三个组件
监控栈最常见的错误是"什么都要 Grafana 干"。职责其实分得很清楚:
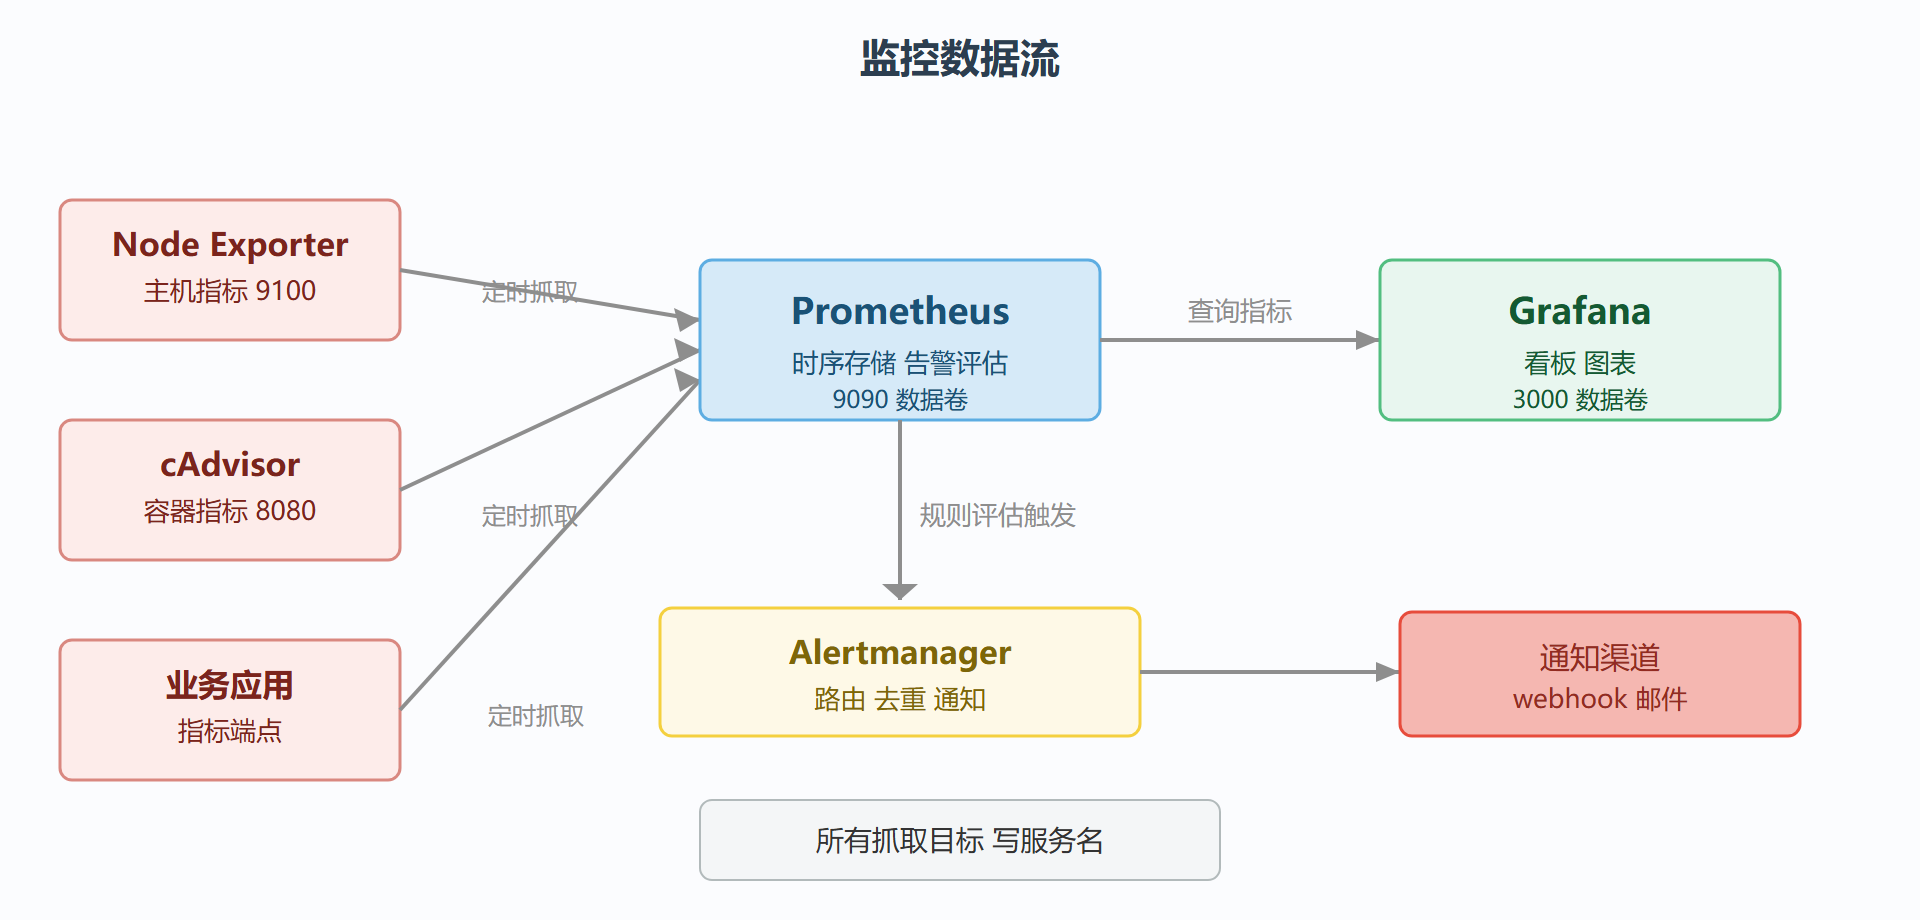
- Node Exporter 只做一件事:把主机的 CPU、内存、磁盘、网络指标翻译成 Prometheus 的指标格式,暴露在 9100 端口。它是数据源,不是监控系统。
- Prometheus 是监控中枢:定期去各 exporter 拉指标、存进自己的时序数据库、按告警规则评估阈值。它自带一个朴素的表达式查询界面,但一般没人拿它当看板用。
- Grafana 是展示层:从 Prometheus 查数据画成图。它不采集任何指标,只负责把时序数据变成人看得懂的看板。
这套分工决定了 compose 的依赖方向:Grafana 依赖 Prometheus 有数据,Prometheus 依赖 exporter 活着。三个组件挂一个网络里,用服务名互相访问。
指标只有三种形状。写告警规则前先分清指标类型:counter 是只增不减的计数器,比如请求总数、CPU 空闲时间,用 rate 取增速;gauge 是可升可降的仪表值,比如内存占用、磁盘剩余,直接比较;histogram 是分布统计,比如请求耗时分位数,用 histogram_quantile 计算。把类型搞混是告警表达式写错的高发原因——拿 counter 直接比大小,重启一次服务就误报一次。
二、完整 compose 配置
services: prometheus: image: prom/prometheus:v2.53.0 container_name: prometheus restart: always ports: - "9090:9090" volumes: - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro - ./rules:/etc/prometheus/rules:ro - prometheus_data:/prometheus command: - --config.file=/etc/prometheus/prometheus.yml - --storage.tsdb.retention.time=15d grafana: image: grafana/grafana:11.1.0 container_name: grafana restart: always ports: - "3000:3000" environment: - GF_SECURITY_ADMIN_USER=admin - GF_SECURITY_ADMIN_PASSWORD=admin_password volumes: - ./provisioning:/etc/grafana/provisioning:ro - grafana_data:/var/lib/grafana depends_on: - prometheus node-exporter: image: prom/node-exporter:v1.8.2 container_name: node-exporter restart: always ports: - "9100:9100" volumes: - /proc:/host/proc:ro - /sys:/host/sys:ro - /:/rootfs:ro command: - --path.procfs=/host/proc - --path.sysfs=/host/sys - --path.rootfs=/rootfs volumes: prometheus_data: grafana_data:
逐块解读:
prometheus_data:/prometheus:Prometheus 的时序数据目录,不挂卷则每次重启都从零开始,历史指标全丢。--storage.tsdb.retention.time=15d控制保留 15 天,按磁盘容量调整。./prometheus.yml与./rules两个目录以只读方式挂进容器,配置随仓库走,改完 restart 生效。- Grafana 的管理员账号密码用
GF_SECURITY_ADMIN_USER与GF_SECURITY_ADMIN_PASSWORD初始化,首次登录就是它;grafana_data:/var/lib/grafana存看板、数据源配置和用户。 ./provisioning目录预置数据源和看板,解决"每次重建环境都要手动配一遍"的重复劳动。- Node Exporter 必须挂载宿主机的 /proc、/sys 和根目录,否则它看到的只是容器自己的内核视图。三个挂载全部只读,exporter 没有写宿主的能力。如果不想映射 9100 端口,可以让它加
--web.listen-address只监听内部网络,或者直接放弃它改用 cAdvisor 看容器指标。
三、抓取配置 prometheus.yml
global: scrape_interval: 15s evaluation_interval: 15s rule_files: - /etc/prometheus/rules/*.yml scrape_configs: - job_name: node static_configs: - targets: ["node-exporter:9100"] - job_name: prometheus static_configs: - targets: ["localhost:9090"]
scrape_interval: 15s:每 15 秒拉一次指标;evaluation_interval: 15s:每 15 秒评估一次告警规则。两个间隔可以独立设置,抓取密度的代价是存储量线性上涨。rule_files指向挂载的规则目录,规则文件用通配符加载,新增文件不用改主配置。targets里写的是服务名:node-exporter:9100。compose 网络内 DNS 解析到容器,Prometheus 容器里没有 localhost 的 exporter——把 target 写成 localhost 或 127.0.0.1 是头号坑,它只会连到 Prometheus 自己。- 想监控其他服务的容器指标,加一个 cAdvisor 服务(gcr 系的 cadvisor 镜像),targets 指向
cadvisor:8080,再配上对应的 job。
四、Grafana 数据源预置与持久化
手动点界面配数据源,重建一次环境就要重配一次。provisioning 目录结构如下:
provisioning ├── datasources │ └── prometheus.yml └── dashboards └── default.yml
datasources/prometheus.yml 的内容:
apiVersion: 1 datasources: - name: Prometheus type: prometheus access: proxy url: http://prometheus:9090 isDefault: true
url字段填 Prometheus 的服务名加端口:prometheus:9090。Grafana 容器内访问 Prometheus 同样走服务名,这里写 localhost 连的是 Grafana 自己,数据源永远显示不可达。access: proxy:请求由 Grafana 服务端转发,避免浏览器直连 Prometheus,也绕开了跨域限制。- 看板也可以预置:dashboards 配置里指向挂载的 JSON 看板文件,Grafana 启动时自动导入。
五、告警规则文件挂载
告警规则写在 rules 目录里,Prometheus 按 evaluation_interval 周期评估:
groups: - name: host-alerts rules: - alert: HostHighCPU expr: 100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100 > 85 for: 5m labels: severity: warning annotations: summary: 主机 CPU 使用率超过 85%
expr是 PromQL 表达式,这里用空闲 CPU 的速率反推使用率;for: 5m要求持续 5 分钟才触发,过滤瞬时抖动。- 规则文件的格式是 YAML 的 groups 结构,Prometheus 启动时如果语法错误,会在启动日志里直接报出文件名和行号。
- 默认情况下告警只写入 Prometheus 的 Alert 状态里,界面能看到,但没人盯着。要真正通知人,再加 Alertmanager 组件,通过 webhook 或邮件路由到钉钉、飞书、Slack 之类的地方,规则里用
alertmanager服务名配置路由。
六、常见坑位清单
坑一:抓取目标写错地址。 三种典型错误:targets 写 localhost、端口写错、服务名拼错。排查顺序固定:docker compose ps 看三容器都 healthy,再进 Prometheus 容器手动拉一次指标,能通则配置没问题:
docker compose exec prometheus wget -qO- http://node-exporter:9100/metrics
Prometheus 自带的 targets 页面(9090 端口 /targets)会直接标红失败的抓取并给出错误信息,这是第一眼该看的地方。
坑二:时间戳对齐。 Prometheus 只接受当前时间前后五分钟内的样本,容器时钟漂移超过这个窗口,指标会被全部拒绝,界面上表现为 Target Down。Docker Desktop 场景很少见,但虚拟机宿主机休眠恢复后时钟可能跳变。解法是让容器共享宿主时钟或确保宿主机开了 NTP 同步,再 docker compose restart prometheus。虚拟机场景下,宿主与容器两侧的时钟都要查,只修一边治标不治本。
坑三:Grafana 卷权限。 Grafana 镜像以 uid 472 运行。用命名卷没问题,一旦改成绑定挂载,宿主机目录属主不是 472,Grafana 会因写不了 /var/lib/grafana 起不来。处理办法是 chown 472:472 ./grafana-data,或者干脆继续用命名卷。
坑四:Node Exporter 挂载目录权限。 它挂载宿主 /proc 和 /sys 属于只读读取,本身不写数据;但要把宿主根目录挂成 rootfs 时,某些宿主安全策略会拦截。多数发行版没问题,遇到权限拒绝,检查宿主机是否启用了 SELinux,考虑给挂载加 :ro 之外的 z 标记。
坑五:忘记管理员密码。 Grafana 的账号密码在环境变量里初始化一次,之后改环境变量并不会改已有密码。忘了密码的恢复路径是进容器重置:docker compose exec grafana grafana-cli admin reset-admin-password 新密码,重置后旧密码立即失效。别折腾删卷——删卷等于把看板和数据源配置全丢了,除非你确认 provisioning 能完全重建。
坑六:端口与防火墙。 三件套映射了 9090、3000、9100 三个端口,内网访问都靠它们。常见现象是"容器健康但浏览器打不开":先查宿主防火墙是否放行,再确认端口没被其他进程占用。9100 只在内网开放即可,别把 Node Exporter 暴露到公网,它泄露的主机信息对攻击者很有用。Grafana 对外则建议挂反代加 HTTPS,方法同 3.1 节。
⚠️ 监控栈自身也要监控:三件套里 Prometheus 挂了,Grafana 的图全黑,而且没人通知你。生产上把三件套自身也纳入告警:Prometheus 的 up 指标对每个 job 都生成一条,up == 0 就告警,监控系统的可用性才算闭环。
💡 看板先导入官方模板再改:Grafana 社区有大量现成的 Node Exporter 看板 JSON,导入后按自己的主机名调整,比自己从零拖图省一小时。看板 JSON 放进 provisioning 的 dashboards 目录,环境重建后自动恢复。
七、Alertmanager 的接入
Prometheus 只负责"判定告警",通知动作交给 Alertmanager。在监控栈 compose 里补一个服务:
alertmanager: image: prom/alertmanager:v0.27.0 container_name: alertmanager restart: always ports: - "9093:9093" volumes: - ./alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro command: - --config.file=/etc/alertmanager/alertmanager.yml
alertmanager.yml 里定义路由与接收者:
route: group_by: ["alertname"] group_wait: 30s group_interval: 5m repeat_interval: 4h receiver: webhook receivers: - name: webhook webhook_configs: - url: http://notify-service:8080/alert
group_wait: 30s收集同一批告警一起发,避免风暴;repeat_interval: 4h控制重复通知频率,同一个告警四小时内不刷屏。- 接收者指向团队的通知服务(钉钉、飞书机器人通常要一个转发中间件),把 webhook 地址填进 receivers 即可。
- 别忘了在 Prometheus 的启动参数里加
--web.enable-lifecycle与配置 alertmanager 地址,或者用--alertmanager.url参数;规则触发后,Alertmanager 的 9093 界面能看到已分组、已抑制的完整状态。
存储容量估算。Prometheus 的磁盘占用可以粗略估算:指标数量乘采样频率乘时间序列基数。比如 1000 条时间序列、15 秒采样间隔、每条样本 2 字节压缩后,一天的存量约 1000 乘 5760 乘 2 字节,约 11MB 量级——实际因为标签和高基数会放大几倍到几十倍。先按放大 10 倍规划磁盘,再观察 prometheus_tsdb_head_samples_appended_total 这类自监控指标修正。retention 参数与磁盘容量对齐,宁可缩短保留期也不让 Prometheus 磁盘写满,写满会直接拒绝新样本。
常用指标速查:
| 指标 | 含义 | 典型告警表达式 |
|---|---|---|
| up | 抓取目标是否存活 | up 等于 0 告警 |
| node_load1 | 一分钟平均负载 | node_load1 大于 CPU 核数两倍 |
| node_filesystem_avail_bytes | 磁盘可用空间 | 可用空间小于 10% |
| rate 函数 | 计算计数器增速 | 请求错误率等 |
标签与 relabel。多台主机时,exporter 的 instance 标签默认是抓取地址,看不出哪台机器。在 scrape 配置里加 relabel 把主机名写进标签:metric_relabel_configs 或 relabel_configs 段用 target_label: hostname 替换 instance 的一部分。标签设计决定了看板和告警好不好写,规则是"主机名、环境、应用"三件套必备,别的标签够用就好,标签基数爆炸是 Prometheus 内存杀手,一个高基数字段就能拖垮整个实例。
八、日志栈的补充:Loki 加 Promtail
指标和日志是两套体系:Prometheus 管"现在发生了什么",日志管"当时发生了什么"。排查问题通常是先看指标定位时间点,再翻日志看细节。容器日志默认只进 docker compose logs,容器重建就丢,补一个轻量日志栈的思路是用 Loki 加 Promtail:
promtail: image: grafana/promtail:3.0.0 restart: always volumes: - ./promtail.yml:/etc/promtail/config.yml:ro - /var/lib/docker/containers:/var/lib/docker/containers:ro command: -config.file=/etc/promtail/config.yml loki: image: grafana/loki:3.0.0 restart: always ports: - "3100:3100" command: -config.file=/etc/loki/local-config.yaml
Promtail 以只读方式挂载 Docker 的容器日志目录,把日志转发给 Loki;Loki 只存索引不建全文索引,资源占用比 ELK 那套小一个量级,单机足够。Grafana 里加 Loki 数据源后,看板图上的异常点可以直接下钻到对应时间段的日志,指标与日志在同一个界面闭环。不想多养两个容器的话,退而求其次是把 docker compose logs 的输出定时重定向到文件并轮转,至少日志不会随容器消失,但检索能力差很多。
抓取间隔与评估间隔的关系。scrape_interval 决定数据粒度,evaluation_interval 决定告警灵敏度,两者不必相等,但告警表达式里 rate 的窗口要大于等于抓取间隔的若干倍,比如 15 秒抓取配 5 分钟窗口,否则 rate 计算会缺样本抖动。改抓取间隔后,旧数据还在但粒度不齐,看板上的曲线会出现阶梯状,这是正常现象,不用慌。
组件参数对照
| 组件 | 镜像 | 端口 | 数据卷 | 数据来源 | 职责 |
|---|---|---|---|---|---|
| Prometheus | prom/prometheus:v2.53.0 | 9090 | /prometheus | 各 exporter | 抓取 存储 告警评估 |
| Grafana | grafana/grafana:11.1.0 | 3000 | /var/lib/grafana | Prometheus | 可视化 看板 |
| Node Exporter | prom/node-exporter:v1.8.2 | 9100 | 无 | 宿主 /proc /sys | 主机指标采集 |
| cAdvisor 可选 | gcr 系 cadvisor 镜像 | 8080 | /var/lib/cadvisor | Docker daemon | 容器指标采集 |
图 3-5 监控数据流图
一节小结
- 三个组件三个职责:采集、存储评估、展示,不要互相越权
- 抓取目标写服务名:localhost 只会连到 Prometheus 自己
- 时序数据必须挂卷:不挂卷等于每次重启清零
- Grafana 数据源用 provisioning 预置:url 写 http 加服务名加端口
- 告警规则文件挂载加 rule_files 加载:新增规则不用改主配置
- 时间戳漂移超五分钟会被拒收:宿主时钟同步是前提
- Grafana 卷属主是 472:绑定挂载前先 chown
- 监控栈自身纳入告警:up 等于 0 必须有人知道
下一节把视野从监控转到数据——对象存储与数据管道模板,MinIO 与 Airflow 的组合拳。