3.6 对象存储与数据管道模板
3.6 对象存储与数据管道模板
本节摘要:对象存储与数据管道模板覆盖两类基础设施:MinIO 提供 S3 兼容的对象存储,Apache Airflow 提供可编程的定时任务调度。MinIO 部分讲密钥环境变量、双端口、数据卷与健康检查;Airflow 部分讲 AIRFLOW__ 环境变量体系、单机多组件编排、数据库初始化与日志卷。两者组合起来就是一条从文件落盘到任务调度的最小数据管道。
上手前先明确
- 能写出 MinIO 的完整 compose 配置并理解 API 与控制台双端口
- 能配置 MinIO 的密钥环境变量与健康检查
- 能搭 Airflow 单机模式,理解 AIRFLOW__ 前缀环境变量的含义
- 能说清 scheduler、webserver、worker 的分工
- 能处理数据管道模板的常见坑:密码规则、初始化、目录权限
一、MinIO 对象存储模板
MinIO 是 S3 兼容的对象存储,API 与 AWS S3 对齐,本地起一个就能让应用代码走标准 S3 客户端,将来迁移云厂商零改动。生产最小形态是一对容器:
services: minio: image: quay.io/minio/minio:RELEASE.2024-06-13T22-53-53Z container_name: minio restart: always ports: - "9000:9000" - "9001:9001" environment: MINIO_ROOT_USER: minio_admin MINIO_ROOT_PASSWORD: minio_admin_pass_2024 volumes: - minio_data:/data command: server /data --console-address ":9001" healthcheck: test: ["CMD", "curl", "-f", "http://localhost:9000/minio/health/live"] interval: 30s timeout: 10s retries: 3 start_period: 10s volumes: minio_data:
关键行:
MINIO_ROOT_USER与MINIO_ROOT_PASSWORD:管理员账号密码。MinIO 有硬性要求,密码最短 8 位,长度不够容器直接拒绝启动,日志里明确提示。别用默认的 minioadmin 组合,那是文档演示账号,公网上被扫到就是裸奔。- 端口分工:9000 是 S3 API 端口,应用和 SDK 连它;9001 是 Web 控制台端口,人用浏览器管理桶和密钥。只映射其中一个都会造成"界面能开但程序连不上"的困惑。
command: server /data --console-address ":9001":server 子命令启动服务,数据目录 /data 挂卷;console-address 显式声明控制台监听地址。- 健康检查用 curl 打 MinIO 自带的健康端点
/minio/health/live,返回 200 即存活。镜像内置 curl,不需要额外安装。 - 镜像 tag 用带日期的 RELEASE 格式而不是 latest,MinIO 发版频繁,latest 可能在某次升级后行为变化;固定到具体 release,升级是主动行为。
初始化桶的两种方式:MinIO 没有类似数据库 entrypoint 的脚本目录,建桶要么在控制台点,要么用 mc 客户端脚本化。一次性初始化可以加一个 mc 容器:
mc: image: minio/mc:RELEASE.2024-06-13T13-53-50Z depends_on: minio: condition: service_healthy entrypoint: > /bin/sh -c " mc alias set local http://minio:9000 minio_admin minio_admin_pass_2024 && mc mb --ignore-existing local/uploads && mc mb --ignore-existing local/backups "
mc 容器跑完即退出,mc alias set 建立连接别名,mc mb 建桶,--ignore-existing 让重复执行不报错。这样桶的存在性也进了配置仓库,重建环境一条命令恢复。
桶命名规范。S3 协议的桶名要求全小写字母、数字和连字符,不能有下划线,长度 3 到 63 字符。命名建议按"用途加环境"组合:uploads-dev、backups-prod,同环境内的桶前缀统一,权限策略和生命周期规则写起来更省事。桶名一旦被客户端引用就不好改,起名时多想一步。
二、MinIO 变体与注意点
单机单盘是演示和内部工具的主流形态,数据卷一个;单机多盘把多个目录或磁盘传给 server 命令,获得纠删码保护,能容忍磁盘故障;分布式模式是四台以上节点组成集群,属于生产级话题,compose 能起但通常不值得在单机环境尝试。
访问权限走 bucket 策略和访问密钥两套:程序用 Access Key 加 Secret Key 连接,每套密钥可以限定只读或只写某个桶。给应用创建独立密钥、最小权限授权,别把 root 账号发给业务代码。
⚠️ 对象存储的数据卷是命根子:MinIO 的卷一旦损坏,恢复手段比数据库还少。挂载后先验证:docker compose exec minio mc ls local 能列出桶,再往里面传一个测试文件并下载比对。备份策略上,单机 MinIO 至少要定期把卷内容同步到异机。
三、Airflow 单机模板
Airflow 是"把定时任务写成代码"的调度平台:DAG 文件定义任务依赖和调度周期,scheduler 负责读 DAG 并触发任务,webserver 提供 Web 界面,worker 执行任务。单机部署把三者塞进一个项目:
services: postgres: image: postgres:14 environment: POSTGRES_USER: airflow POSTGRES_PASSWORD: airflow POSTGRES_DB: airflow volumes: - airflow_db:/var/lib/postgresql/data healthcheck: test: ["CMD-SHELL", "pg_isready -U airflow -d airflow"] interval: 5s timeout: 5s retries: 10 scheduler: image: apache/airflow:2.9.2 restart: always depends_on: postgres: condition: service_healthy environment: AIRFLOW__CORE__EXECUTOR: LocalExecutor AIRFLOW__DATABASE__SQL_ALCHEMY_CONN: postgresql+psycopg2://airflow:airflow@postgres:5432/airflow AIRFLOW__CORE__LOAD_EXAMPLES: "False" AIRFLOW__CORE__DEFAULT_TIMEZONE: Asia/Shanghai AIRFLOW__WEBSERVER__SECRET_KEY: change_this_secret_key _AIRFLOW_DB_UPGRADE: "true" volumes: - ./dags:/opt/airflow/dags - airflow_logs:/opt/airflow/logs command: scheduler webserver: image: apache/airflow:2.9.2 restart: always depends_on: - scheduler ports: - "8080:8080" environment: AIRFLOW__CORE__EXECUTOR: LocalExecutor AIRFLOW__DATABASE__SQL_ALCHEMY_CONN: postgresql+psycopg2://airflow:airflow@postgres:5432/airflow AIRFLOW__WEBSERVER__SECRET_KEY: change_this_secret_key _AIRFLOW_DB_UPGRADE: "true" volumes: - ./dags:/opt/airflow/dags - airflow_logs:/opt/airflow/logs command: webserver volumes: airflow_db: airflow_logs:
AIRFLOW__ 前缀环境变量是这套模板的钥匙,规则是:AIRFLOW__SECTION__KEY 对应配置文件里 [section] key = value,下划线加双下划线分隔。上面几个变量的含义:
AIRFLOW__CORE__EXECUTOR: LocalExecutor:任务在本机进程池里执行,单机标配;要分布式就换 CeleryExecutor 并加 worker 容器和消息中间件。AIRFLOW__DATABASE__SQL_ALCHEMY_CONN:元数据库连接串,Airflow 的任务定义、运行记录、调度状态全存这里,用 PostgreSQL 而不是默认的 SQLite,避免并发写锁。AIRFLOW__CORE__LOAD_EXAMPLES: "False":关闭官方示例 DAG。不关的话界面上会多出十几个示例,第一次用容易分不清哪些是自己写的。AIRFLOW__CORE__DEFAULT_TIMEZONE: Asia/Shanghai:调度时区。Airflow 默认 UTC,cron 表达式按 UTC 解释,国内早上 8 点的任务要写 0 0 * * * 才能对上,直接设成业务时区省掉换算。_AIRFLOW_DB_UPGRADE: "true":带下划线前缀是官方镜像的启动钩子,启动时自动执行元数据库迁移,首次部署和版本升级都靠它。_AIRFLOW_WWW_USER_CREATE: "true"配合_AIRFLOW_WWW_USER_USERNAME与_AIRFLOW_WWW_USER_PASSWORD可以自动创建 Web 登录账号,避免手动airflow users create。
DAG 目录与日志卷:./dags 绑定挂载,DAG 文件改动即生效,scheduler 默认每 30 秒扫一次目录;airflow_logs:/opt/airflow/logs 存任务日志,任务失败排查全靠它,不挂卷的话日志随容器消失。
四、Airflow 多组件模式与单容器权衡
上面的模板是 scheduler 加 webserver 两个容器。完整生产形态还要加 worker(执行任务)和 triggerer(服务延迟型任务),每个组件一个容器、共享同一份 DAG 与元数据库。LocalExecutor 下 scheduler 自己也能跑任务,两个容器足够单机使用。
另一种选择是官方单容器模式:一个 airflow 容器跑 airflow standalone,它会把 scheduler、webserver、触发器都拉起来并自动建用户,适合本地体验。我们的建议:写 DAG 用单容器,跑业务用两容器模板——standalone 模式把组件耦合在一起,重启和看日志都不好定位,而两容器之间只差一个依赖声明。
上面是一个典型 ETL 的 DAG 依赖链,Airflow 按依赖关系顺序执行,任务失败自动重试并标记状态,这是它比 cron 强的地方:失败可见、依赖可查、重跑可控。
五、数据管道模板的常见坑
坑一:DAG 目录属主。 官方 Airflow 镜像以 uid 50000 运行。用绑定挂载时宿主机目录属主不对,scheduler 扫描会报权限错误。chown -R 50000:50000 dags 或改用命名卷。改完 DAG 不生效时,先看 scheduler 日志里有没有 import 报错,Airflow 对 DAG 文件的语法错误是静默跳过的。
坑二:任务失败先查日志再查代码。 Airflow 界面里任务失败点开就有日志,多数是依赖库没装或连接串写错。镜像里缺 Python 依赖要在 Dockerfile 里 pip install 后重新构建,运行时临时安装会在容器重建后消失。
坑三:密码规则与密钥轮换。 MinIO 的 root 密码改起来麻烦,建议一开始就用独立访问密钥给应用,root 只留管理。Airflow 的 SECRET_KEY 影响 session 签名,多容器之间必须一致,且不要用示例值上生产。
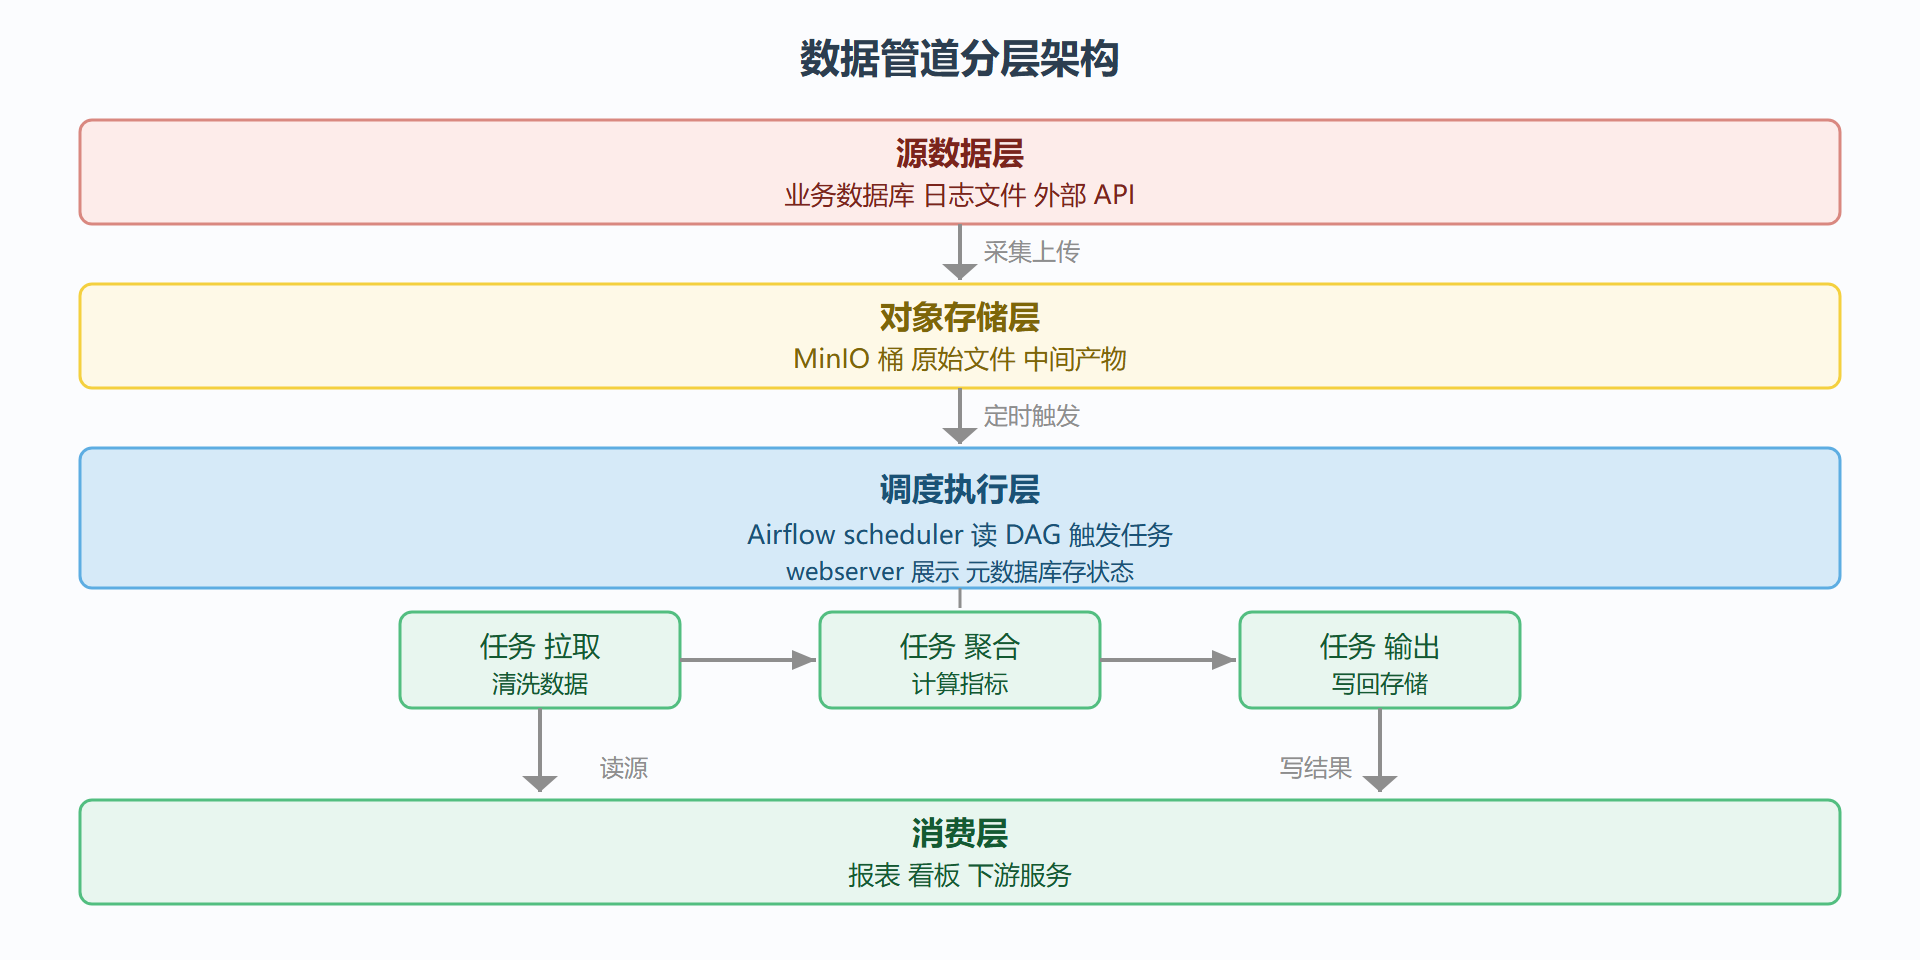
💡 把数据管道画成分层再动手:先画清"数据从哪来、谁调度、存哪里、谁消费",再照着模板填服务。下面的分层图是这类架构的通用骨架:
图 3-6 数据管道架构图
六、访问密钥与数据生命周期
MinIO 的权限模型与云厂商 S3 对齐:root 账号之外,用 mc 给每个应用建独立密钥:
mc admin user add local app_user app_secret_password mc admin policy attach local readwrite --user app_user
mc admin user add 建用户,mc admin policy attach 附加策略。更细的桶级权限可以写 JSON 策略文件再 mc admin policy create,只允许指定桶的读写。密钥要能轮换:应用侧把 Access Key 与 Secret Key 放进环境变量,轮换时改环境变量重启应用,不要烧进镜像或代码里。
版本控制与生命周期。MinIO 支持桶级版本控制,开启后每次覆盖写都会留一个历史版本,误删误改都能找回:
mc version enable local/uploads mc retention set local/uploads --default 30d
mc version enable 开版本控制,mc retention set 设对象保留期。注意版本控制会放大存储量,一个文件改十次就占十份空间,配合生命周期策略定期清理过期版本,比如 90 天前的版本自动删除。这个组合是对象存储防误删的标准姿势。
七、Airflow 的连接与任务可靠性
Airflow 的任务里要连数据库、调 API,连接信息存在"连接"和"变量"两个概念里。连接用 AIRFLOW_CONN_ 前缀环境变量注入,比如 AIRFLOW_CONN_MY_DB: postgresql://user:pass@db:5432/mydb,DAG 代码里用 BaseHook.get_connection('my_db') 取;变量用 AIRFLOW_VAR_ 前缀,适合放路径、开关这类非敏感配置。敏感密码不要写进 DAG 文件,用环境变量或 Airflow 的加密变量后端。
任务可靠性靠三个参数:
default_args = { "retries": 2, "retry_delay": timedelta(minutes=1), "email_on_failure": False, }
retries 与 retry_delay 让瞬时故障自动重试,网络抖动、数据库连接闪断都能扛过去;email_on_failure 关了就用 Web 界面的告警。还有两个调度概念容易踩:catchup=False 必须显式设置,否则补跑历史调度周期的任务会把积压的几百个 DAG 实例全跑一遍;max_active_runs=1 限制同一 DAG 的并发实例数,防止任务跑得比周期还慢时堆叠。
日志卷膨胀。任务日志随运行次数无限增长,airflow_logs 卷几个月就能吃满磁盘。处理办法是定期清理:docker compose exec scheduler bash -c "find /opt/airflow/logs -name '*.log' -mtime +30 -delete" 挂到宿主 cron,或者把日志目录设为 tmpfs 只留当天的。日志该留多久取决于审计要求,但"无限保留"是默认选项里最危险的一个。
💡 DAG 写好先 dry-run:docker compose exec scheduler airflow dags test my_dag 2024-01-01 可以手动跑一次 DAG 且不写调度状态,用来验证依赖和参数,比直接等定时触发快得多。
八、管道的可观测性
数据管道最大的风险是"静默失败":任务表面成功,数据质量已经坏了。三道防线按成本从低到高:第一道,任务内部断言——任务末尾校验记录数、金额合计,不达标就抛异常,让任务标记失败;第二道,Airflow 的 SLA 机制——DAG 里声明 sla,任务超时未完成触发通知;第三道,数据新鲜度监控——下游报表里检查"最后更新时间",用 3.5 节的 Prometheus 对 MinIO 桶里最近对象的修改时间做探测,超过阈值就告警。三道防线各有侧重,第一道防逻辑错,第二道防调度错,第三道防"整个管道没跑"。
MinIO 侧同样要监控。对象存储的可用性直接影响管道:桶里写入失败、磁盘将满,任务再重试也是白费。MinIO 的 /minio/health/live 端点可以进 Prometheus 抓取目标,配合 3.5 节的磁盘告警(node_filesystem_avail_bytes),对象存储的容量与存活就纳入了统一监控。管道类组件最怕"平时没人看,出事一起出",提前把监控接上,比事故复盘划算。
组件参数对照
| 组件 | 镜像 | 端口 | 关键环境变量 | 数据卷 | 定位 |
|---|---|---|---|---|---|
| MinIO | quay.io/minio/minio 固定 release | 9000 9001 | MINIO_ROOT_USER 与 PASSWORD | /data | 对象存储 |
| mc 客户端 | minio/mc 固定 release | 无 | 无 | 无 | 初始化桶 |
| Airflow | apache/airflow:2.9.2 | 8080 | AIRFLOW__ 系列 | dags 挂载 日志卷 | 任务调度 |
| Airflow 元库 | postgres:14 | 无 | POSTGRES_ 系列 | /var/lib/postgresql/data | 调度状态 |
核心回顾
- MinIO 双端口别漏:9000 给程序,9001 给人,漏一个就有一半功能用不了
- root 密码最少 8 位:短了容器直接拒绝启动
- 桶的初始化用 mc 容器:alias 加 mb 脚本化,重建环境一条命令恢复
- AIRFLOW__ 前缀即配置路径:双下划线对应配置文件的小节与键
- 元数据库用 PostgreSQL:SQLite 在并发写场景会锁死
- DAG 目录属主是 50000:绑定挂载前 chown,语法错误会静默跳过
- 示例 DAG 要关掉:LOAD_EXAMPLES 设 False,界面只留自己的任务
- 管道画成分层再动手:源、存储、调度、消费四层各司其职
下一节收尾于团队日常——自托管协作应用模板,把网盘、代码托管、容器管理搬回自己的机器。