3.2 Prim算法:步步为营的树扩张
3.2 Prim 算法:步步为营的树扩张
本节摘要:Prim 算法从任意一个种子顶点开始,每轮把"横跨树内与树外的边中权重最小的一条"连同其外侧端点吸入树中,重复到覆盖全部顶点,即得最小生成树。它的正确性直接来自 3.1 节的切割性质;朴素实现为点数平方,优先队列优化后为"边数乘 log 点数",在稠密图上尤为顺手。本节覆盖执行模拟、两版实现、与 Dijkstra 的结构对照以及选型建议。
读前必看
阅读完本节,你应当能够:
- 手工模拟 Prim 在小图上的逐轮扩张过程;
- 写出朴素版与堆优化版的 Prim 实现;
- 说明 Prim 与 Dijkstra "形似神异"的具体差别;
- 解释 Prim 为什么天然适合稠密图、为什么中途的树永远连通。
一、问题与直觉:树是"长"出来的
想象在居民区电网施工现场:你从变电站(种子顶点)开始通电,每一轮环顾"已通电区"与"未通电区"之间的所有候选线路,挑最便宜的一条把一个新的住户拉进电网。重复到人人通电,工程结束。
这个流程有两个天然的好性质:其一,任何时刻手上的边集都是一棵树——每轮恰好加入"一端在内、一端在外"的边,连通性保持、永不成环;其二,"树内 vs 树外"恰好构成 3.1 节所说的割,每轮吸入的又是横跨割的最小边——切割性质保证了这条边安全,属于某棵 MST。n 减 1 轮之后,得到一棵货真价实的最小生成树。
Prim 的视角是局部的:它从不需要看全图的边,只关心"树边界"上有什么。这一点与 Kruskal 的"全局排序所有边"形成鲜明对照,也是两者适用场景分野的根源。
二、执行过程:一张表的演化
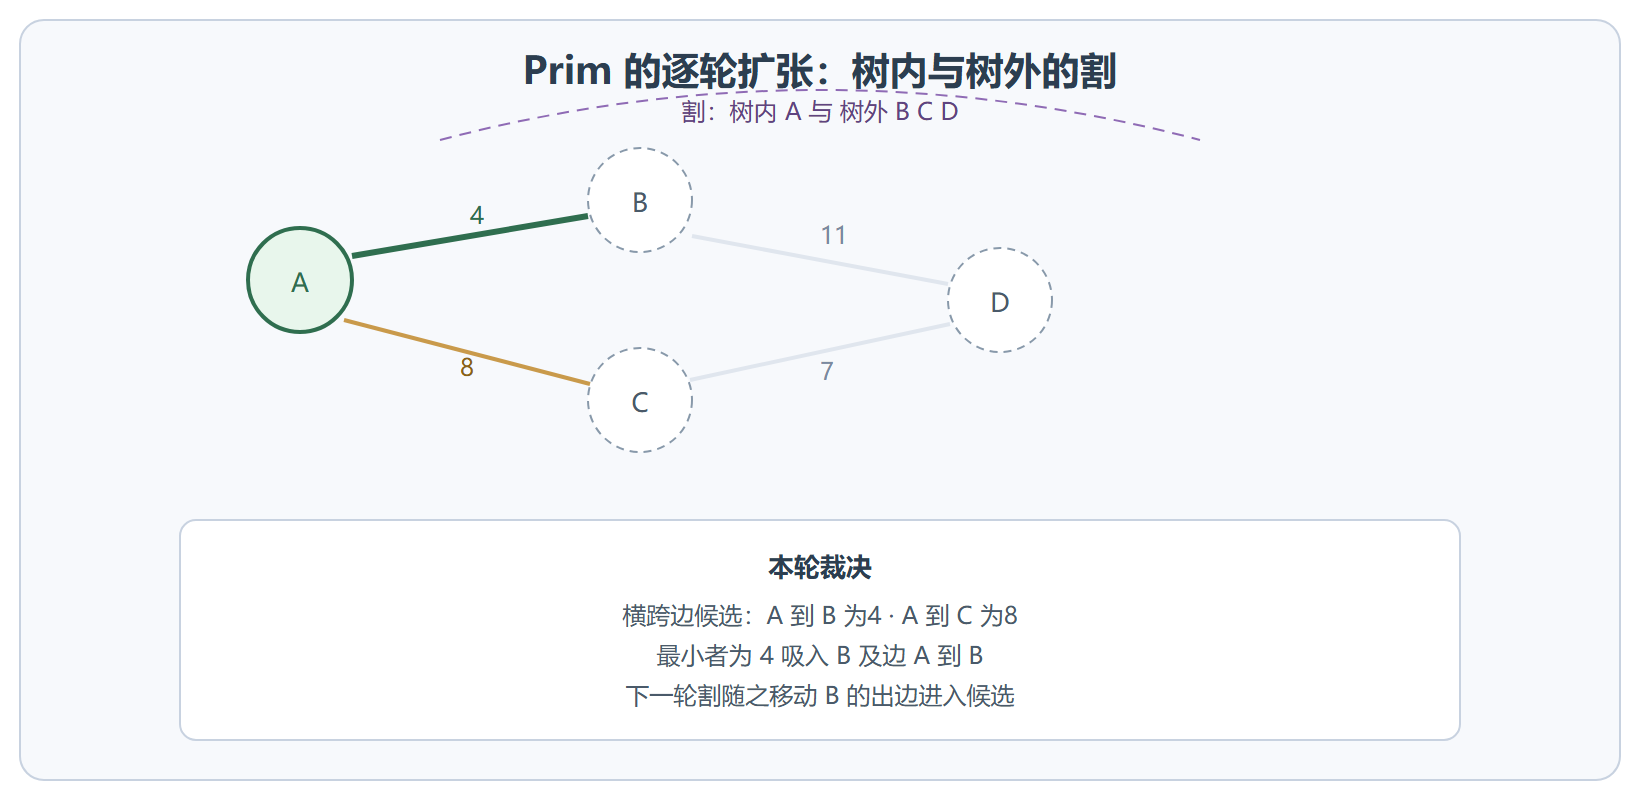
用原始文集的经典 9 顶点例图(边权含 4、8、11、7、1、6、2、4、9、14、10):从顶点 A 出发,邻居为 B(权 4)与 H(权 8)。
轮次 树内 候选横跨边中最小 吸入 1 {A} A-B为4 B(权4) 2 {A,B} H-G为1 ... 视图演化 G 或按边界最小选 3 ... ... 8 全部9点 共8条边 构成MST
第一轮毫无悬念:A 的两条出边里 4 更小,B 入树。此后每轮的候选集 = 原有横跨边去掉"两端都已在树内"的、加上新入顶点的出边中"外侧端点未入树"的。手算时维护一张"每个树外顶点到树内最近距离"的表格最不易乱——这正是代码里 dist 数组的雏形。
算法骨架(找最小、入树、更新边界三步循环):
def prim(graph, start): # graph 为邻接表 dict 顶点 -> 邻居与权重 import heapq in_tree = {start} edges = [] # 记录入选边 pq = [(w, start, v) for v, w in graph[start]] heapq.heapify(pq) total = 0 while pq and len(in_tree) < len(graph): w, u, v = heapq.heappop(pq) if v in in_tree: continue # 两端都已在树 弃 in_tree.add(v) edges.append((u, v, w)) total += w for nv, nw in graph[v]: if nv not in in_tree: heapq.heappush(pq, (nw, v, nv)) return edges, total
要点拆解:
- 堆里存什么:横跨边(权重、内端点、外端点)。弹出时外端点可能已入树,跳过即可——与 Dijkstra 的"懒删除"同款技巧。
- 提前判连通:循环结束时若 in_tree 没覆盖全部顶点,说明图不连通,得到的只是"生成森林的一个分量",应向上层报告。
- 边数校验:结果应恰好 n 减 1 条边,3.1 节的结构特征可直接当断言用。
三、与 Dijkstra 的"形似神异"
Prim 堆优化版与 Dijkstra 堆优化版的代码几乎是一个模子:都在优先队列里挑"最小"、都拿挑出的点去更新邻居、都用懒删除。差别只有一处,但这一处是本质:
| 维度 | Dijkstra | Prim |
|---|---|---|
| 堆中键值 | 源点到该点的累计距离 | 该点到树的最近距离 |
| 更新公式 | dist 加边权 再比较 | 直接与新边权比较 |
| 不变量 | 已定型点的距离为全局最优 | 树内边集属于某棵 MST |
| 解决的问题 | 点到点怎么走最省 | 整体怎么连最省 |
| 朴素复杂度 | 点数平方 | 点数平方 |
| 堆优化复杂度 | 边数乘 log 点数 | 边数乘 log 点数 |
Dijkstra 记的是"从起点出发的累计账单",Prim 记的是"离树的最近一步"。把两者的更新语句并排看:Dijkstra 是"若 dist 加 w 小于 dist 则更新",Prim 是"若 w 小于当前到树的距离则更新"——后者不累加。这一字之差决定了两个算法服务两套目标,抄代码时抄串了,跑出来的结果"像对的其实是错的"。
四、性能分析与选型
- 朴素版(点数平方):用数组维护"每个树外顶点到树的最近距离",每轮线性扫最小。当图稠密(边数接近点数平方)时,堆优化版的优势消失——堆里塞了近乎平方条边,反而更慢。工程惯例:边数超过点数平方的若干分之一,直接上朴素版。
- 堆优化版(边数乘 log 点数):稀疏图的标准选择,与 Dijkstra 堆版同级。
- 起点无关性:MST 是全局对象,从哪个顶点启动 Prim 得到的树总权重都相同(边权互异时连边集都相同)。起点选择只影响实现细节,不影响答案。
选型结论(与 3.3 节呼应):稠密图用 Prim,稀疏图用 Kruskal;需要"增量式"处理(图逐步长大、随时要当前 MST)时 Prim 的边界结构更友好;拿到的是排序好的边列表或只关心"最小连通森林"时 Kruskal 更直接。
Prim 执行过程示意
⚠️ 常见坑:堆优化 Prim 里忘了"弹出时检查外侧端点是否已入树",会把两端都在树内的边也记入结果,边数超过 n 减 1、树中出现环。另一个坑是从 Prim 的结果反推"任意两点最短路"——3.1 节已经用反例说明两套目标互不保证。
💡 关键直觉:Prim 是"滚雪球"——雪球(树)每滚一步只黏住离自己最近的一层雪(最小横跨边)。切割性质保证每一步黏的都是"安全雪",滚满全场时,雪球就是最小的那个。
五、深入一层:堆优化 Prim 的退化与重建
堆优化 Prim 在一种边形态下会明显退化:大量重复边权或"横跨边数量爆炸"的图。堆里同时挤着成千上万条候选边,而每轮真正有用的只有一条——弹出大量过期条目的开销成了主角。工程对策有三:其一,用"键值数组加索引堆"(支持真正的降键操作),把堆规模压到"顶点数"而不是"边数";其二,回到朴素数组版——它的复杂度只看点数,边再多也不怕,这正是稠密图选它的深层原因;其三,对超大规模图改用"分块 Prim"(分区局部生长再拼接)或直接换 Kruskal。
另一个值得体会的结构对照:Dijkstra 的堆条目"过期"是因为距离被更新得更小;Prim 的堆条目"过期"是因为端点已入树。两种过期的语义不同,但处理方式相同(弹出时校验丢弃)。这类"同一容器承载不同语义"的复用在图算法里俯拾皆是——认出模式,代码就能少写一半。
常见疑问解答
Prim 的中间结果能用吗?比如跑了五轮就停。
可以,且这正是 Prim 的一个独特优势:中间态是一棵"部分 MST"——已选边集是某个包含当前树的最小生成树的子集。增量式场景(节点陆续加入、随时要当前最优连通方案)里,Prim 可以从上次的树继续生长,无需重算。Kruskal 的中间态是多棵子树的森林,语义上不适合"继续长成整体"。
为什么 Prim 不用担心负权边?
MST 的正确性证明(切割性质)从不依赖权重的符号——负权边完全合法,甚至全负权的图照样求 MST。这与 Dijkstra 形成有趣对照:同样"贪心加堆"的骨架,一个怕负权、一个不怕,差别在于贪心依据的性质不同(累计距离的单调性 vs 横跨边的最小性)。
起点、邻居顺序会影响结果吗?
边权互异时不会——MST 唯一,任何实现路径殊途同归。有权重并列时可能得到不同的(同为最优的)树,属于 3.1 节讨论的多解情形。调试时若两次运行结果不同,先查是否权重并列,再怀疑代码。
优先队列里存边和存点,哪个更好?
本节实现存"横跨边"(三元组),直观且适合教学;存"点到树的距离"(二元组,配"哪条边达成该距离"的辅助数组)内存更省、语义与 Dijkstra 更接近。两者复杂度同阶,选择看团队习惯与调试偏好。
动手实验:三种起点的 Prim 会师
取 3.3 节同款 9 顶点例图,分别从三个不同顶点启动 Prim,每轮记录吸入的边与当前总权。三次运行的总权应当一致;边集是否一致取决于权重有无并列。再做一次"作弊"对照:故意在某一轮选次小的横跨边,观察最终总权是否变大——变大了,说明贪心的每一步都"省在了刀刃上";如果某些图恰好不变,找找原因(多半是并列权重或对称结构)。这种"故意犯错"的实验比正确性证明更能建立对算法的信任感。
Prim 的代码骨架复用清单
Prim 的实现与 Dijkstra 共享如此多的结构,工程上可以直接复用一套"贪心加堆"模板,只改三个槽位:堆条目的键(累计距离或到树最近距离)、更新条件(加完再比或直接比)、终止条件(覆盖全部顶点或目标点定型)。把模板抽出来,两个算法各填三个槽位,代码量减半且不易抄错——这也是"理解结构同源"的直接工程红利。
Prim 要不要预处理边?
不必排序(这正是它相对 Kruskal 的省事之处),但建议做两个轻量准备:过滤零容量与负异常边(权重可为负是合法的,但要确认业务语义);邻接表按目标点去重或按权排序(后者能让"到树最近距离"的更新更早命中小值,属可选微优化)。真正必须预处理的是连通性检查——树长不到的孤岛要提前报备。
补充一个稳定性的观察:Prim 的每一步选择只依赖当前树边界上的最小边,因此对输入顺序天然鲁棒;配合确定性的堆比较规则,整个算法的执行轨迹可以做到完全可复现——这对回归测试与结果审计都是好消息。
核心回顾
- 算法流程:任选种子入树;每轮吸入最小横跨边及其外侧顶点;n 减 1 轮完成。
- 正确性来源:树内外构成割,吸入的是横跨最小边,切割性质背书每一步。
- 过程性质:任何时刻的边集是一棵树,连通、无环,边数恰为已入定点数减一。
- 两档复杂度:朴素点数平方(稠密图反而占优),堆优化边数乘 log 点数。
- 对照 Dijkstra:代码骨架相同,键值语义不同——累计距离 vs 到树最近距离;更新一个要加、一个不加。
- 起点无关:MST 是全局对象,种子选择不影响结果。
- 连通检查:结束时未覆盖全部顶点说明图不连通,输出的是分量级森林。
Prim 从局部"长"出全局最优。下一节的 Kruskal 换一个视角——把所有边摊在桌上按价格排序,从最便宜的开始一件一件"买"。