5.1 从ENIAC到超算的硬件代际演进
5.1 从ENIAC到超算的硬件代际演进
本节摘要:高性能计算的硬件史,是一部不断撞墙又不断翻墙的记录。本节按代际拆解 HPC 硬件的五代更替——真空管并置时代(ENIAC 的物理并行)、晶体管与向量流水线(Cray 系列)、大规模并行处理 MPP(千核集群与 MPI)、GPU 异构崛起(CUDA 打开通用计算大门)、异构融合与领域专用架构(CPU 加 GPU 加高速互连的当代超算)。每一代都被一个物理或工程瓶颈卡住,又都被下一代硬件架构绕过。读完你会理解,今天的超算为什么长成"多核 CPU 加 GPU 加 InfiniBand"的样子,以及下一代可能往哪走。
你能学到什么
阅读完本节,你应当能够:
- 复述 HPC 硬件五代代际的标志性特征和代表机型
- 说清每一代被突破的瓶颈和催生下一代的原因
- 解释登纳德缩放终结与功耗墙为什么是 HPC 的转折
- 从演化脉络判断异构融合与领域专用架构的必然性
一、问题与直觉
看一台当代超算的照片——成排的机柜、密密麻麻的线缆、闪烁的指示灯,像一座工厂。它和八十多年前那台三十吨重的 ENIAC,看起来毫无相似之处。但如果你把它们的演进画成一条时间线,会发现 HPC 的硬件史有一个清晰的内在逻辑:每一代架构都在解决上一代留下的"算不动",然后自己又撞上新的墙,逼出下一代。
很多人觉得 HPC 的进步就是"晶体管越做越小、算力越做越强",这其实只说对了一半。单纯的制程微缩确实带来了几十年的红利,但 HPC 真正的跨越,每一次都来自架构范式的更替——从单核到向量、从向量到大规模并行、从纯 CPU 到异构加速。制程是燃料,架构是引擎,缺一不可。
这节我们用演化的视角,把五代硬件串起来看。重点不是记住哪个机型哪年发布,而是看清"为什么这一代会结束、下一代必须来"。
二、核心原理
2.1 第一代:真空管与物理并置(1940s—1950s)
ENIAC 是公认的电子计算机鼻祖之一,它用一万八千多个真空管实现每秒五千次加法。从并行计算的视角看,ENIAC 的"并行"是物理层面的——真空管阵列的物理并置,让多个运算单元可以同时工作。但这种并行是脆弱的:真空管平均几分钟就烧一个,整台机器一半时间在维修。
这一代的意义不在于算多快,而在于它确立了"用电子器件做计算"这条路。它的瓶颈是器件本身不可靠、能耗惊人(ENIAC 耗电一百五十千瓦,传说一开机费城的灯都暗一点)。要往前走,必须换一种更可靠、更省电的开关元件。
| 代际 | 时段 | 代表机型 | 并行形态 | 主要瓶颈 |
|---|---|---|---|---|
| 真空管 | 1940s—1950s | ENIAC | 物理并置 | 器件不可靠、高能耗 |
| 晶体管向量 | 1960s—1980s | CDC 7600、Cray-1 | 指令流水线与向量寄存器 | 单机内存与带宽 |
| 大规模并行 MPP | 1990s—2000s | IBM SP2、Cray T3E | 千核集群与消息传递 | 通信延迟与编程复杂 |
| GPU 异构 | 2000s—2010s | Tesla 系列、天河一号 | 海量轻量线程数据并行 | 数据搬运与编程模型断层 |
| 异构融合 DSA | 2010s 至今 | Frontier、富岳、神威 | CPU 加 GPU 加高速互连 | 能效、可移植性、可验证 |
2.2 第二代:晶体管与向量流水线(1960s—1980s)
晶体管替代真空管,解决了可靠性和能耗问题。真正的突破来自 Seymour Cray 主导的系列机型——CDC 6600、CDC 7600,以及后来的 Cray-1。Cray 引入了两项关键设计:指令流水线(把一条指令的执行拆成多个阶段,让不同指令的不同阶段重叠)和向量寄存器(一条指令一次处理一整组数据)。
向量处理是这一代的核心。它把"数据并行"从电路设计层面提升到了指令集架构层面——程序员(或编译器)写一条向量加法,硬件就并行处理一整组数据。Cray-1 在 1976 年达到每秒一亿六千万次浮点运算,是当时的天文数字。
这一代的瓶颈是单机规模。向量机靠极致的单机工艺堆算力,但内存带宽和单机容量终有上限。当问题的规模超过单机能装下的数据,向量机就力不从心。要算更大的问题,必须把多台机器连起来。
2.3 第三代:大规模并行处理 MPP(1990s—2000s)
大规模并行处理(Massively Parallel Processing,MPP)的核心思想是"用数量换性能"——把成百上千个处理器用高速网络连起来,每个处理器有自己的私有内存,靠消息传递协同。代表机型有 IBM SP2、Cray T3E、Intel Paragon。
这一代的关键伴随物是 MPI(消息传递接口)标准的诞生。没有统一的通信标准,每家厂商的机器编程方式都不同,代码没法移植。MPI 在 1994 年发布,让分布式内存的并行程序第一次有了跨平台的通用语。这极大地降低了集群编程的门槛,也让 MPP 架构迅速成为超算的主流。
图 MPP 时代的计算与通信交织
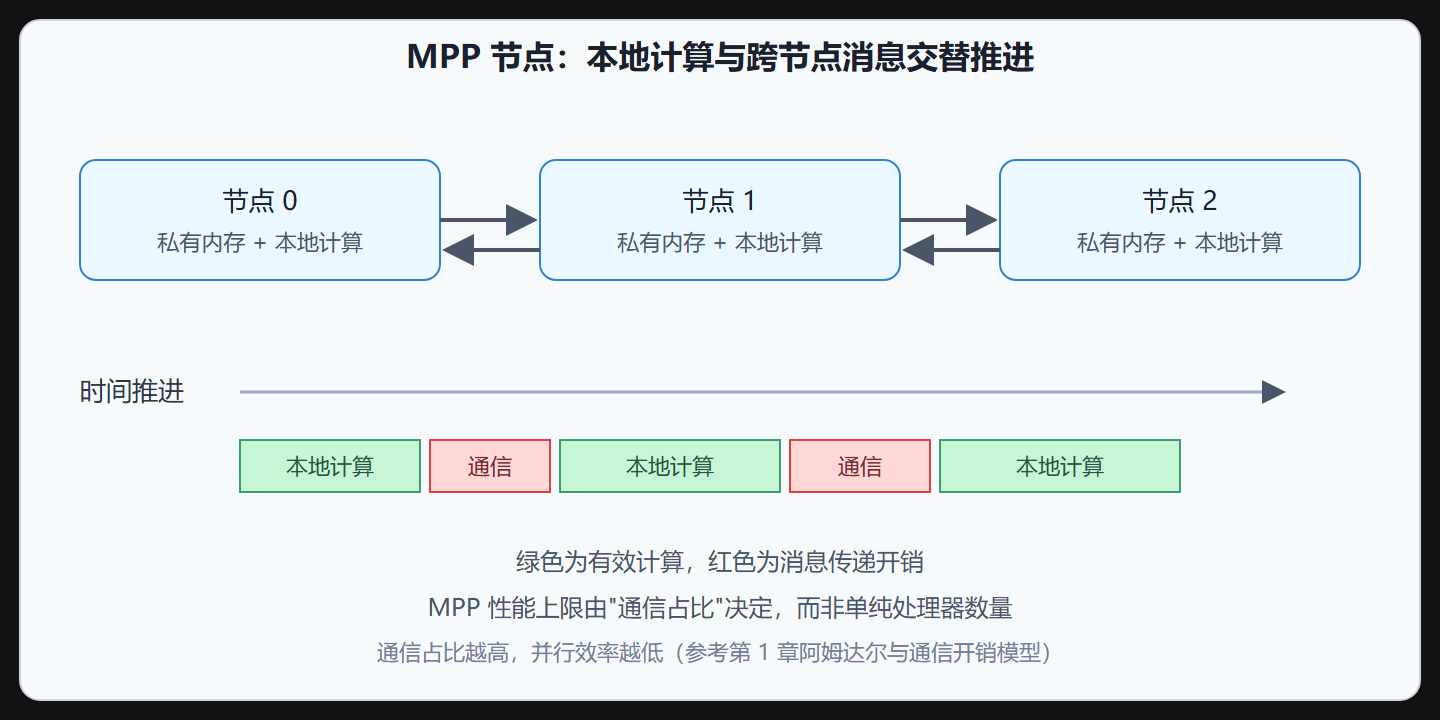
MPP 时代的核心矛盾转移了:不再是单机算力不够,而是"通信开销怎么压下去"。一台峰值很高的 MPP,跑实际任务时效率可能不到峰值的百分之十——大部分时间花在节点间传消息上。这个矛盾直接催生了第 2 章讲的数据分布、通信聚合、计算通信重叠这一整套并行算法技巧。
💡 关键直觉:从这一代开始,HPC 的主要矛盾从"算得快不快"变成了"通信少不少"。后面每一代硬件演进,本质上都在围绕这个矛盾做文章——更快的互连、更聪明的数据布局、更激进的计算通信重叠。
2.4 第四代:GPU 异构崛起(2000s—2010s)
GPU 原本是为图形渲染设计的,但它"海量轻量线程"的架构意外地适合通用并行计算。2007 年 NVIDIA 发布 CUDA,把 GPU 从"图形专用芯片"变成了"通用并行加速器"——这是 HPC 史上一次范式级转折。
CUDA 的意义在于:它让普通程序员(而不只是图形专家)能在 GPU 上写通用计算。一个矩阵乘法,在 CPU 上靠几十个重核心算,在 GPU 上可以分给成千上万个轻量线程并行算,吞吐高出几十倍。这对数据并行的应用(线性代数、卷积、蒙特卡洛)是降维打击。
| 维度 | CPU(向量机/MPP 节点) | GPU(异构加速器) |
|---|---|---|
| 核心数 | 几个到几十个 | 成千上万 |
| 单核能力 | 强,复杂逻辑分支 | 弱,简单计算 |
| 适合任务 | 控制/分支密集 | 数据并行/计算密集 |
| 内存层次 | 深缓存,低延迟 | 浅缓存,高带宽 |
这一代也有它的代价。CPU 和 GPU 是两套独立的内存空间,数据要在两者间搬运。如果计算强度不够大(每个搬过来的数据被算的次数太少),搬运开销会吃掉 GPU 的算力优势。这逼出了第 1 章讲的"计算强度"概念,以及一整套为 GPU 重写算法的工程实践。
天河一号在 2010 年成为全球第一台全 GPU 异构的千万亿次超算,标志异构架构正式进入 HPC 主流。
2.5 第五代:异构融合与领域专用架构(2010s 至今)
当摩尔定律放缓、登纳德缩放(Dennard Scaling,晶体管缩小后功耗密度不变的规律)终结,单纯靠制程微缩堆算力的路走到了尽头。功耗墙成了硬约束——一台超算的功耗动辄几十兆瓦,相当于一个小城市的用电,散热和电费成了天文数字。
这逼出了当代超算的核心架构:异构融合。一台节点里同时有多核 CPU、一个或多个 GPU、可能还有 AI 加速器或 FPGA,用高带宽互连(NVLink、InfiniBand)把它们粘在一起。CPU 负责控制流和串行部分,GPU 负责大规模数据并行,节点间用高速网络协同。Frontier、富岳、神威系列都是这一代的代表。
更激进的演化方向是领域专用架构(Domain-Specific Architecture,DSA)。既然通用处理器在能效上撞墙了,那就为特定类型的工作负载定制芯片——AI 训练专用的加速器、用于分子动力学的专用计算单元、针对稀疏矩阵优化的数据通路。中国神威系列走了自主处理器加定制互连的路线,也是 DSA 思路的体现。
这一代的挑战和前几代完全不同了。性能可移植性(同一段代码在不同厂商的异构平台上性能差几个数量级)、能效优化(每瓦算多少浮点操作成了核心指标)、可验证性(百亿核上跑三个月的结果怎么信)成为新的硬骨头。这些正是第 4 章讲的前沿挑战。
三、工程实践要点
3.1 每一代都不会消失,只会沉淀
⚠️ 常见误区:以为新一代硬件出现,旧的就过时了。实际恰恰相反——HPC 的代际是叠加而非替代。今天一台超算里,向量指令(第二代)还在用、MPI 通信(第三代)还在用、GPU 加速(第四代)是主力、异构融合(第五代)是框架。新一代架构往往建立在旧一代之上,把旧的封装成底层。理解这一点,就不会对"为什么超算上同时跑着 MPI 和 CUDA"感到困惑。
3.2 制程红利与架构红利的区别
| 红利类型 | 来源 | 是否可持续 | 现状 |
|---|---|---|---|
| 制程红利 | 晶体管缩小 | 已放缓 | 摩尔定律接近物理极限 |
| 架构红利 | 范式更替 | 仍可挖掘 | 异构、DSA、专用加速 |
很多人把"算力涨"全归功于制程进步,忽略了架构范式的贡献。事实上,向量机到 MPP、纯 CPU 到 GPU 异构,每一次架构跨越带来的性能提升,并不亚于制程微缩。在制程红利接近枯竭的今天,架构创新(异构融合、领域专用、近存计算、光互连)成了 HPC 继续往前的主要燃料。
3.3 功耗墙是真实的硬约束
💡 关键直觉:评估一台超算不能只看峰值算力,得看能效(每瓦算力)。功耗墙意味着你不能无限堆功率——一台二十兆瓦的超算,光是电费和散热就是巨大的运营成本。这也是为什么 TOP500 榜单之外,还有 Green500 专门排名能效。能效高的设计(比如 ARM 加 GPU、专用加速器)正在变得越来越有吸引力,哪怕峰值算力不是最高。
本章回顾
- 第一代真空管确立了电子计算的路,但器件不可靠能耗高,被晶体管替代。
- 第二代向量机(Cray 系列)把数据并行提升到指令集层面,瓶颈是单机规模。
- 第三代 MPP用数量换性能,伴随 MPI 标准,主要矛盾转为通信开销。
- 第四代 GPU 异构(CUDA 开启)用海量轻量线程换吞吐,代价是数据搬运和算法重写。
- 第五代异构融合与 DSA是功耗墙下的必然,挑战是性能可移植、能效、可验证。
- 代际是叠加不是替代,旧架构沉淀为底层;制程红利放缓后,架构创新成主燃料。
下一节看编程生态怎么跟着硬件代际一步步演化——从手写汇编到 AI 框架。