5.2 并行编程模型与生态的演化脉络
5.2 并行编程模型与生态的演化脉络
本节摘要:硬件每换一代,软件栈就得跟着重写一遍,但旧栈不会消失,而是沉淀成底层依赖。本节顺着硬件代际,讲清并行编程生态的四代演化——手工与厂商库时代(汇编加数学库)、消息传递与共享内存的分野(MPI 与 OpenMP)、异构计算崛起(CUDA 打开通用并行大门)、AI 框架重塑上层(PyTorch 等接管数据并行与模型并行)。重点说清代际更替是叠加而非替代,以及当前生态面临的代际断层危机。读完你会理解,为什么一台当代超算上同时跑着 Fortran、MPI、CUDA 和 PyTorch,它们各自承担什么角色。
阅读收获
阅读完本节,你应当能够:
- 复述并行编程生态四代演化的标志性产物
- 解释为什么代际更替是叠加而非替代
- 说清 MPI、OpenMP、CUDA、AI 框架各自覆盖的层次
- 理解当前软件栈代际断层的根源与影响
一、问题与直觉
上一节我们看到 HPC 硬件经历了五代更替。但硬件是死的,软件才是让硬件发挥出来的活水。一台同样的 GPU 集群,用九十年代的编程方式写,性能可能只有现代写法的零头。这说明编程模型不是硬件的附属品,它本身就是 HPC 演化的主线之一。
很多人对并行编程生态有一个误解:觉得有了新的、更高级的工具,旧的就该被淘汰。但你去任何一台当代超算上看,会发现 Fortran、MPI、OpenMP、CUDA、Python、PyTorch 全都在用——这不是因为大家念旧,而是因为每一代工具都解决了某个层次的痛点,新工具无法完全替代旧工具的全部职责。生态的演化像地层堆积,新的盖在旧的上,旧的还在底下默默承重。
这节我们沿着硬件代际,看编程生态怎么一步步长成今天这个样子。重点不是罗列每个工具的语法,而是看清每一代工具为什么出现、解决了什么、留下了什么。
二、核心原理
2.1 第一代:手工与厂商库时代(1950s—1980s)
早期的并行编程基本靠手工。程序员直接用汇编甚至机器码,针对特定机器的硬件特性手写并行逻辑。那时候的并行是"隐式"的——藏在硬件的向量寄存器和流水线里,程序员要靠对硬件的深刻理解才能榨出性能。
随着向量机普及,厂商开始提供优化的数学库(BLAS、LAPACK 的前身),把常用的线性代数运算封装成高度优化的例程。普通程序员调用这些库,就能间接享受硬件并行带来的加速,而不必自己写底层的向量化代码。这是"库化"思路的开端——把高性能实现交给少数专家封装,大多数使用者只管调用接口。
这一代的瓶颈是可移植性差。每家厂商的硬件不同,库的接口也不同,代码换个机器就得重写。科学计算界急需一套跨平台的标准,这为下一代埋下了种子。
2.2 第二代:消息传递与共享内存的分野(1990s—2000s)
MPP 架构的普及,让"分布式内存"成为主流。但每家厂商的消息传递接口都不同,代码没法在机器间移植。1994 年 MPI(Message Passing Interface)标准发布,统一了分布式内存的编程接口——这是 HPC 软件史上最重要的标准化事件之一。
几乎同时,共享内存的多核服务器也开始普及。针对共享内存的并行,出现了 OpenMP 标准——用编译制导指令(pragma)标注可并行的循环,编译器自动展开成多线程。OpenMP 的优势是改动小,在已有串行代码上加几行指令就能拿到多核加速。
于是 HPC 编程生态出现了清晰的两条线:
| 编程模型 | 内存模型 | 典型硬件 | 核心抽象 |
|---|---|---|---|
| MPI | 分布式,私有 | 集群、超算 | 进程加消息 |
| OpenMP | 共享,统一 | 多核 CPU、单节点 | fork-join 线程 |
这两条线长期分庭抗礼:跨节点的并行用 MPI,节点内的多核并行用 OpenMP。现代超算上最常见的组合是"MPI 加 OpenMP"——MPI 管节点间通信,OpenMP 管节点内的多核并行。这种分层一直到今天都是科学计算代码的主流写法。
💡 关键直觉:MPI 和 OpenMP 的分野,本质是对应了硬件的"分布式内存加共享内存"两层结构。编程模型之所以这样设计,是为了匹配硬件的现实——你没法在分布式内存上假装大家共享一份内存,也没必要在共享内存上强行用消息传递。匹配硬件层次,是选编程模型的根本心法。
2.3 第三代:异构计算崛起(2000s—2010s)
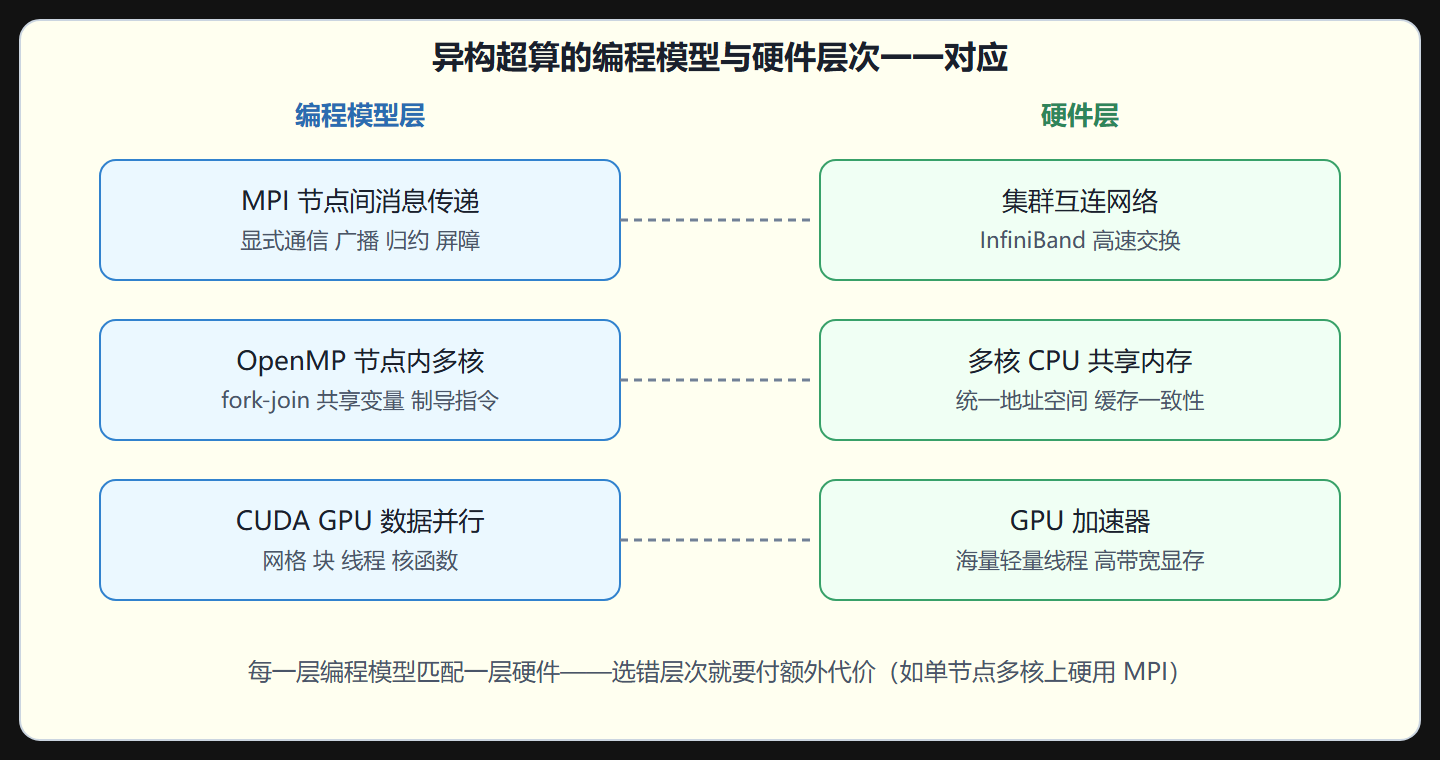
GPU 进入 HPC 改变了一切。CUDA 在 2007 年发布后,GPU 不再只是图形芯片,而成了通用并行加速器。但 CUDA 带来的不只是新硬件,更是一套全新的编程模型——它要求程序员用"网格加块加线程"的层次结构组织计算,用核函数描述单个线程的行为,然后启动成千万个线程实例。
这与 MPI 和 OpenMP 的思维方式截然不同。MPI 想的是"进程间怎么传消息",OpenMP 想的是"循环怎么并行",CUDA 想的是"怎么把数据展开成海量线程同时算"。开发者面对的不再是"两选一",而是"三层叠加"——一个大规模异构程序,可能同时用 MPI 管节点间、OpenMP 管节点内 CPU 多核、CUDA 管 GPU 加速。
图 三层编程模型与硬件层次的对应
异构时代最大的痛点是代码要为不同的硬件重写。同一段数值算法,CPU 版、CUDA 版、后来还有 OpenCL 版、SYCL 版,维护成本爆炸。这催生了一批抽象层框架(Kokkos、RAJA、Alpaka),试图用"上层统一接口、下层多后端"的方式缓解可移植性痛点,但至今没有形成共识级标准。
2.4 第四代:AI 框架重塑上层(2010s 至今)
最近十年,深度学习的爆发让 PyTorch、TensorFlow 这类 AI 框架成为 HPC 上层的新主角。它们表面上是为训练神经网络设计的,但实际上重塑了整个并行计算的工作流——自动微分、分布式数据并行、张量并行、流水线并行、混合精度训练,这些能力让"在几千张 GPU 上训大模型"变成相对标准化的工程。
AI 框架的意义在于它把并行的复杂性大幅封装起来了。一个普通研究者用几行配置就能启动多卡数据并行训练,底层的数据切分、梯度同步、通信优化被框架接管。这和九十年代用 MPI 手写通信原语、小心翼翼避免死锁的体验完全不同。
但 AI 框架并没有取代 MPI 和 CUDA,它是在它们之上加了一层。PyTorch 的分布式训练,底层仍可能调用 MPI 做进程管理、调用 CUDA 做核函数执行。这就形成了当代 HPC 的完整地层:
| 层次 | 工具 | 角色 |
|---|---|---|
| 应用层 | PyTorch 等 AI 框架 | 训练大模型、自动并行 |
| 加速层 | CUDA | GPU 核函数 |
| 节点内层 | OpenMP | CPU 多核并行 |
| 节点间层 | MPI | 跨节点通信 |
| 数学库层 | BLAS、cuBLAS | 优化基础运算 |
2.5 代际断层:演化的副作用
演化是叠加的,但每一代之间并不平滑衔接。这就造成了第 4 章讲过的"软件栈代际断层"——年轻一代研究者熟稔 Python 和 PyTorch,却对 MPI 调试、性能剖析、HDF5 数据模型陌生;资深 HPC 工程师精通 Fortran 和 OpenMP,却难驾驭大模型的混合精度训练和梯度压缩。
⚠️ 常见坑:低估代际断层的影响。一个团队里,做气象模拟的老专家和做大模型训练的新人,可能完全无法直接协作——他们用的工具、思维方式、调试手段都不在一个层。这不是技术问题,是教育和工程文化的问题。破解之道不是让一方学另一方,而是培养既懂数值方法又懂并行、还能在多层栈之间切换的复合人才。
三、工程实践要点
3.1 选层:从最高抽象层开始
| 任务类型 | 推荐起点 | 理由 |
|---|---|---|
| 训练神经网络 | AI 框架(PyTorch 等) | 自动微分、自动并行 |
| 数据并行数值计算 | 数学库或 OpenMP | 改动小、见效快 |
| 跨节点科学仿真 | MPI(必要时加 OpenMP) | 分布式内存标准 |
| 极致性能的内核 | CUDA 核函数 | 手动控制硬件 |
💡 关键直觉:选工具从你能用的最高抽象层开始,性能不够再往下挖一层。能用 PyTorch 的分布式数据并行就别手写 MPI,能用 cuBLAS 就别手写 CUDA 核函数。只有在抽象层挡住了你需要的控制粒度时,才往下沉。过早沉到底层,是给自己找麻烦。
3.2 不要轻易推翻旧代码
HPC 里有大量几十年前的 Fortran 代码还在超算上跑,它们经过无数验证、承载着领域的集体智慧。看到旧代码就想用新框架重写,是常见但危险的想法——重写容易,但验证重写后的正确性极难,特别是浮点数值行为哪怕一个微小差异都可能导致结果完全不同。务实的做法是渐进式改造:旧代码保留作为参考实现,新工具先在小范围验证一致后再逐步替换。
3.3 警惕"新即好"的迷思
⚠️ 常见坑:盲目追新工具,觉得用上最新的框架就是先进。事实上,对一个稳定的科学计算代码来说,迁移到新框架的代价(重写、验证、重新调优)往往远大于它带来的收益。新工具适合新项目;对存量代码,除非旧工具确实卡住了性能或维护,否则"不动"往往是更明智的选择。HPC 的工程理性,是不为技术先进性买单,而为解决问题买单。
3.4 复合人才是演化的真正瓶颈
回顾四代演化,会发现一个反复出现的现象:每一代新工具出现时,瓶颈都不在工具本身,而在能驾驭它的人。MPI 时代缺懂分布式通信的工程师,CUDA 时代缺懂 GPU 架构的程序员,AI 框架时代缺既懂神经网络又懂并行的复合人才。工具可以快速普及,但能用好工具的人才培养是以年为单位的慢过程。
这意味着,一个团队要跟上 HPC 的演化节奏,最重要的投资不是买最新硬件,而是培养人。理想的 HPC 人才具备三层能力:懂领域(知道物理或化学问题要算什么)、懂数值方法(知道怎么离散、怎么求解)、懂并行(知道怎么把求解映射到硬件)。这种复合能力很难从单一学科培养出来,往往需要跨项目的实战历练。
| 能力层 | 关注问题 | 培养途径 |
|---|---|---|
| 领域层 | 物理或化学过程怎么建模 | 学科训练 |
| 数值层 | 怎么离散求解、误差怎么控 | 计算数学训练 |
| 并行层 | 怎么映射到硬件、怎么调优 | HPC 工程实战 |
💡 关键直觉:HPC 演化的下一程,竞争的不再是硬件算力(那会逐渐趋同),而是能驾驭异构栈的复合人才密度。一个团队能在多层栈之间自由切换,才是真正的核心竞争力。这也是为什么第 4 章把"软件栈代际断层"列为四大挑战之一——断层本质是人才断层的体现。
要点串联
- 第一代手工与厂商库:靠汇编和数学库,可移植性差,催生标准化需求。
- 第二代 MPI 与 OpenMP 分野:对应分布式与共享内存两层硬件,至今是科学计算主流。
- 第三代 CUDA 异构崛起:带来"网格加块加线程"的新思维,编程变成三层叠加。
- 第四代 AI 框架重塑上层:把并行封装成高层抽象,但底层仍是 MPI 和 CUDA。
- 代际是叠加不是替代,演化像地层堆积;选工具从最高抽象层开始,别盲目追新。
至此我们看完了 HPC 的硬件和软件两条演化线。下一章回到当下,讲实战选型和排错。