附录 HPC术语表与性能公式速查
附录 HPC术语表与性能公式速查
本附录摘要:汇总高性能计算与并行计算领域的核心术语和性能公式,方便日常工作中快速回顾。
学习目标
阅读完本附录,你应当能够:
- 准确解释 HPC 相关核心术语
- 快速查阅并行性能的关键公式和选型准则
一、术语表
| 术语 | 含义 |
|---|---|
| HPC | 高性能计算,用并行硬件解决大规模计算问题 |
| 并行计算 | 多个处理单元协同执行以缩短时间或提升吞吐 |
| 依赖约束 | 任务间的数据依赖,真依赖不可并行 |
| 阿姆达尔定律 | 固定问题规模下并行加速的上限,由串行段决定 |
| 古斯塔夫森定律 | 问题规模随处理器增长时加速近似线性 |
| 强扩展性 | 固定问题加处理器,看时间降不降 |
| 弱扩展性 | 问题和处理器同步涨,看时间稳不稳 |
| 弗林分类法 | 按指令流和数据流分 SISD SIMD MISD MIMD |
| 共享内存 | 多处理器访问统一地址空间 |
| 分布式内存 | 各处理器私有内存,靠消息传递交换数据 |
| MPI | 消息传递接口,分布式内存的标准 |
| OpenMP | 共享内存的线程级并行编程模型 |
| CUDA | GPU 异构计算编程模型 |
| Reduction | 把分散的中间结果归约成全局结果 |
| 数据分布 | 数据在节点间的分配策略(块 循环 块循环) |
| 通信开销 | 消息传递的时间代价,等于延迟加长度除带宽 |
| 负载均衡 | 让所有单元工作量尽量相等,防木桶效应 |
| 工作窃取 | 闲单元从忙单元偷任务的动态负载均衡 |
| Profiler | 性能分析工具,定位程序瓶颈 |
| SLURM | 常见的 HPC 作业调度系统 |
| 并行文件系统 | 支撑多节点并发读写的高带宽存储(Lustre GPFS) |
| 检查点 | 作业定期存状态,故障后恢复 |
| 异构计算 | CPU 加 GPU 加加速器的混合计算 |
| 计算强度 | 每字节数据的计算量,决定是否带宽受限 |
易混淆概念辨析
新手常把几个概念搞混,这里单独拎出来说清。
强扩展性 vs 弱扩展性:这是最容易缠在一起的 pair。强扩展性固定问题规模、只加处理器,问的是"同一份任务能不能算得更快"——理想是时间随处理器数线性下降。弱扩展性让问题和处理器一起涨,问的是"任务变大但每处理器负担不变时,时间稳不稳"——理想是时间持平。前者反映串行段和通信的开销,后者反映算法能否随规模扩展。一个程序强扩展好不代表弱扩展好,反之亦然,评估时两个维度都要看。
共享内存 vs 分布式内存:共享内存指多个处理器看到同一个地址空间,写一个变量别人立刻能读到,典型是单机多核(OpenMP 编程)。分布式内存指每个处理器有私有内存,别人要数据得通过显式消息传递,典型是集群(MPI 编程)。两者不是互斥的——一个集群的每个节点内部是共享内存,节点之间是分布式内存,于是有了 MPI 加 OpenMP 的混合编程。
真依赖 vs 假依赖:真依赖是后一个任务真的要用前一个任务算出的结果,必须等,没法并行。假依赖只是名字上冲突(比如复用了同一个变量名),实际值不依赖,编译器或运行时可以重命名消除。性能优化时只关心真依赖——它才是并行的硬约束。
二、性能公式速查
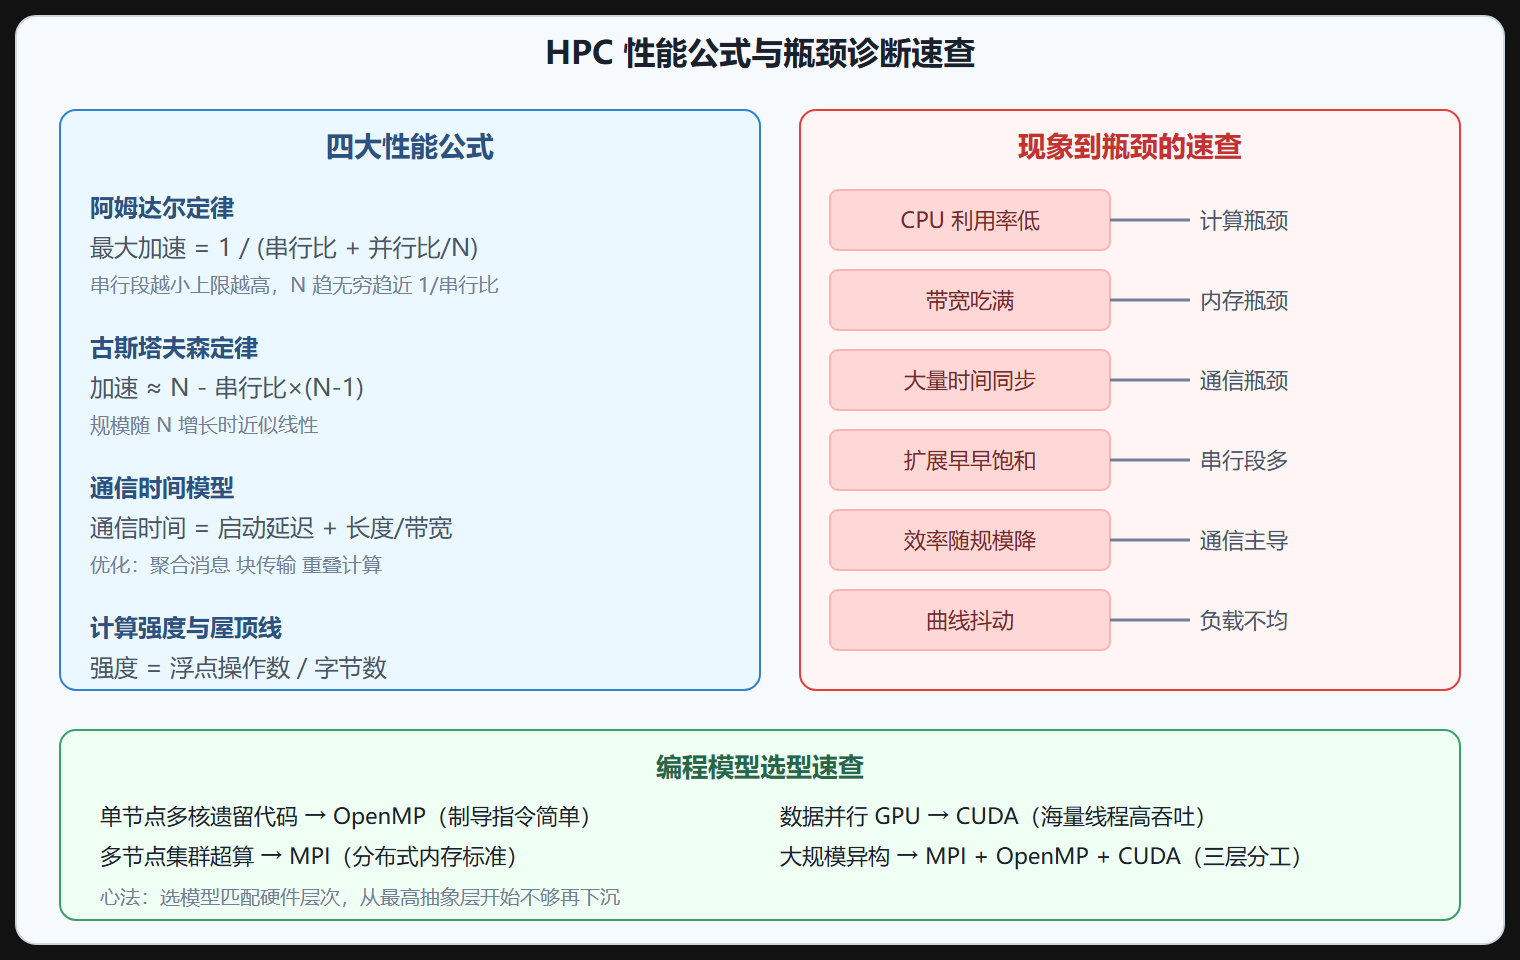
下面这张图汇总了 HPC 里最常用的几个性能关系:
图 HPC 性能公式与瓶颈诊断一图通
阿姆达尔定律
最大加速比等于一除以(串行比例加并行比例除以处理器数)。串行段越小,上限越高;处理器数趋于无穷时,加速比趋近一除以串行比例。
古斯塔夫森定律
加速比约等于处理器数减去串行比例乘以(处理器数减一)。当问题规模随处理器增长时,加速比随处理器数近似线性增长。
通信时间模型
一次点对点消息的传输时间等于启动延迟加上消息长度除以带宽。优化方向:减少消息数(聚合)、增大消息量(块传输)、重叠通信与计算(异步)。
并行效率
并行效率等于加速比除以处理器数。理想值为一(完全线性加速),实际随处理器数增加而下降,下降速度反映通信和负载的开销。
计算强度
计算强度等于每字节数据的计算量(浮点操作数除以字节数)。它和硬件的"屋顶线"(算力除以带宽)对比,能判断程序是计算受限还是带宽受限。实操上,先用 profiler 测出程序的实际浮点速率和带宽占用,算出实际计算强度,再和屋顶线模型的拐点比——拐点之前受限于带宽(提高数据局部性、减少搬运有效),拐点之后受限于算力(这时优化访存无益,得减少计算量或提升指令级并行)。很多人调性能时凭感觉优化,往往用错方向:明明是带宽受限却去堆向量化,等于火上浇油,因为向量化会进一步拉高带宽需求。先算计算强度再决定优化方向,是屋顶线模型最大的工程价值。
三、瓶颈诊断速查
| 现象 | 可能瓶颈 | 优化方向 |
|---|---|---|
| CPU 利用率低 | 计算瓶颈 | 向量化、指令级并行 |
| 带宽吃满 | 内存瓶颈 | 缓存优化、数据布局 |
| 大量时间在同步 | 通信瓶颈 | 消息聚合、异步通信 |
| 强扩展早早饱和 | 串行段多 | 压缩串行部分 |
| 效率随规模下降 | 通信主导 | 减少通信、优化拓扑 |
| 曲线抖动 | 负载不均 | 动态负载均衡 |
四、编程模型选型速查
| 场景 | 推荐模型 | 理由 |
|---|---|---|
| 单节点多核、遗留代码 | OpenMP | 制导指令简单 |
| 多节点集群、超算 | MPI | 分布式内存标准 |
| 数据并行、GPU | CUDA | 海量线程高吞吐 |
| 大规模异构 | MPI 加 OpenMP 加 CUDA | 三层分工 |
五、本附录小结
这份附录是整套 HPC 教程的速查工具。术语表帮你对齐概念,性能公式帮你估算,瓶颈诊断表帮你定位问题,选型表帮你决策。HPC 是个横跨硬件、算法、系统、应用的交叉领域,把这些基础概念和公式记牢,能让你在选硬件、写代码、调性能时不至于迷失方向。
实际工作中,建议把这套速查当成"第一反应工具":遇到性能问题先看瓶颈诊断表定位大类,再用对应公式量化,最后回到选型表确认方案是否合适。另一个实用习惯是给自己的关键程序建立一份"性能档案"——记录它的计算强度、通信占比、强弱扩展曲线,下次优化或迁移到新硬件时,这份档案比重新 profiling 节省大量时间。HPC 的优化往往不是一次到位,而是反复在这套框架里迭代:测、算、改、再测,每一轮都让性能曲线往理想值靠近一点。记住,没有哪个公式或工具能单独给出答案,它们组合起来才构成判断的依据。