6.3 碳足迹追踪与数字护照
6.3 碳足迹追踪与数字护照
本节摘要:一项产品的碳足迹要“从摇篮到坟墓”整个生命周期的排放都被算清、沿供应链流转,这需要一个可追溯、可互认的数据载体——产品数字护照。本节讲全生命周期碳足迹怎么追踪、数字护照如何贯通供应链与碳市场,并坦述落地的数据与生态难题。
一、从一袋咖啡到一架飞机的“碳痕迹”
你面前放着一袋咖啡豆:种植用了几度电、运输烧了多少油、烘焙排了多少碳、包装吃了多少塑料、喝完的包装进了回收还是填埋……把这一连串加到一起,才是这袋咖啡的“全生命周期碳足迹”。再放大到一辆电动车、一块芯片、一家工厂的整条供应链,这件事瞬间规模庞大。
全生命周期碳足迹(Life Cycle Assessment 下的碳排放侧)之所以重要,因为它回答了一个越来越被追问的问题:“这块东西到底带了多少碳来”。减碳若只看工厂围墙内的排放,就会陷入“把高碳工序外包出去、账面上很干净”的绿色陷阱。要真正诚实,必须看产品从摇篮到坟墓整条链路。
二、追踪的基础:把排放数据装进“护照”
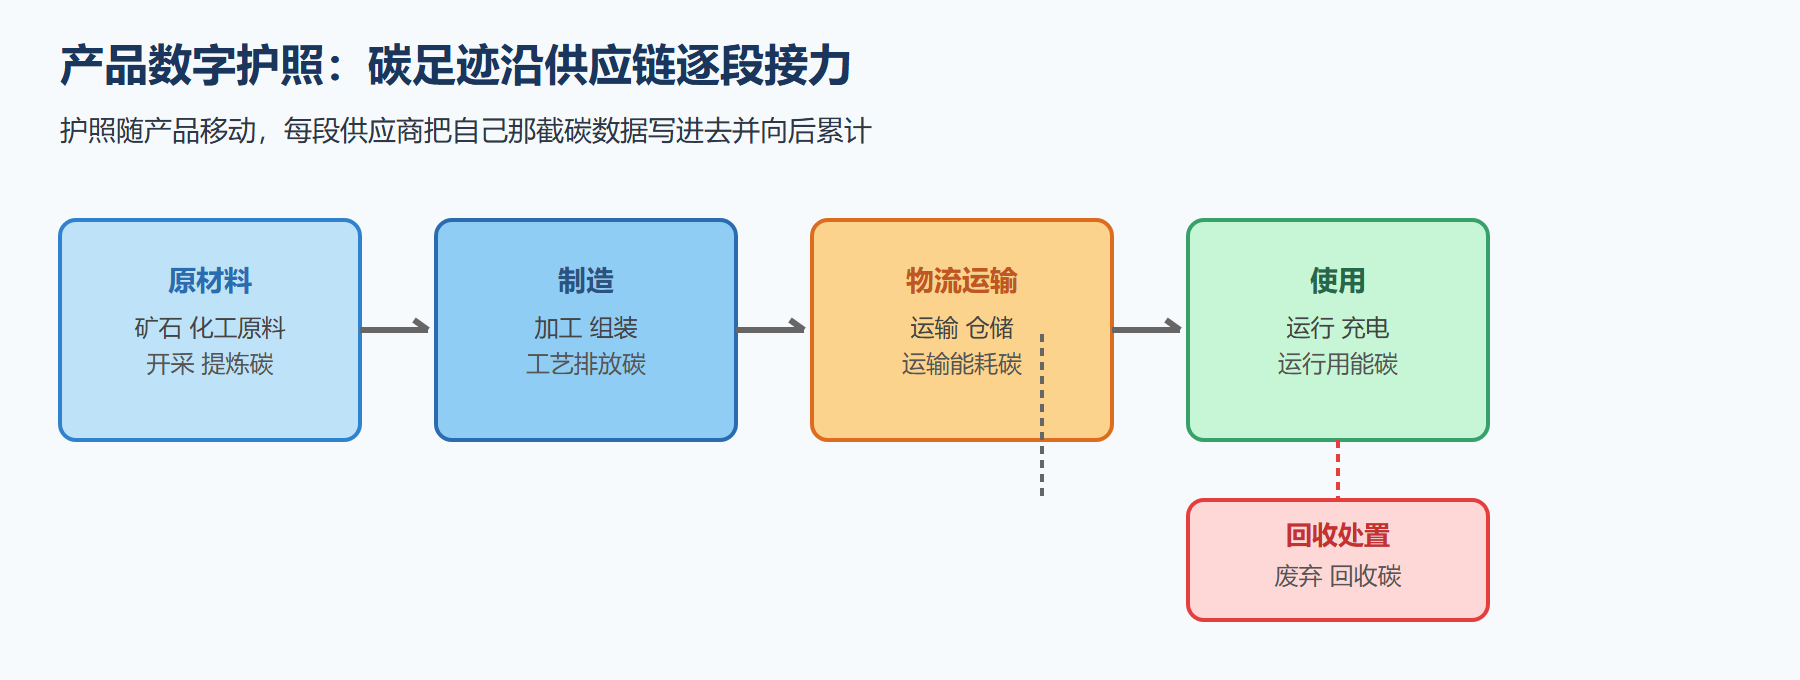
追踪碳足迹,核心难题不是概念,而是数据能不能跟着供应链一起走。每个环节的供应商要交出自己的排放数据,而后逐段把“碳足迹”往后传递:矿石的开采碳、炼铁的碳、轧钢的碳、物流的碳,一层层累加在最终产品头上。
这一需求催生了产品数字护照(Digital Product Passport):一份跟产品绑定、可机读、可追溯的数据档案,里面记录了这块产品的身份、材料成分、能耗、碳足迹、回收信息,并沿供应链逐步更新。它让“碳数据”不再是封闭在各自企业里的孤岛,而能沿价值链流转、汇总、供下游与监管随时查验。
三、图示:数据集卡与链条级流转如何接力
我画一张图,帮助你直观理解数字护照如何把分散的各段碳数据接力汇总到最终产品:
碳足迹沿供应链的接力汇总
四、数字护照为什么成了“香饽饽”
数字护照不只是个数据档案,它的战略价值在于一旦建起来,几个大买家都想用:
- 支撑碳关税:欧盟碳边境调节机制(CBAM)要求核算进口产品的碳含量,一份可靠的产品护照是核算与申报的依据。
- 绿色采购与标签:采购方想挑低碳供应链,消费者想看“这个更绿吗”,护照把碳信息透明化,让绿色溢价有据可循。
- 对接碳市场:一份可追溯、可审计的碳护照,也能支撑可持续燃料与 CDR 等减排量的可信核算与交易。
可以说,数字护照是把“数字化碳账”从企业内部延伸到供应链、海关、消费者与碳市场的那座桥。它的价值不只在环保,更在让“谁更绿”变成可交易的差异。
五、理想的背后:数据与互认的两座大山
但别把数字护照想得太美,落地有两大硬障碍:
- 数据可得与一致:全供应链逐段交出可靠的同口径碳数据,是庞大工程。中小供应商没工具、没能力,数据颗粒度和口径常常对不齐。
- 标准与互认:各国各行业的护照格式、核算方法尚在统一中,若区域各自为政,护照可能变成新的贸易壁垒而不是通行证(前车之鉴就是碳边境税的公平争议)。
现实的姿态应是“小步快跑”:先从重点行业、重点产品的核心段位数据做起,用可机读、可审计的规范逐步建立互认。数字护照本身不是终点,而是一套让整个碳体系“数据可流通、绿色可信赖”的长期基础设施,值得有耐心地推进。
六、落到判断:怎么给一件产品算出一本“碳账”
讲了碳足迹与数字护照,现在落到一个能上手的最小例子:给一件产品粗算口径——工厂里的排放,并延伸到我们看到的多阶供应链数据如何接力。
用一段代码做一次极简“缆车式”累加
全生命周期碳足迹可以抽象成“把各环节排放逐个乘上比例再累加”。示意如下:
def product_carbon(stages): # stages: [(环节名, 排放量kg), ...] 简化为直接求和(示意) return {"环节": [s[0] for s in stages], "累计kgCO2": [round(sum(c for _, c in stages[: i + 1]), 2) for i in range(len(stages))]} trace = product_carbon([("原料开采", 2.0), ("加工", 3.5), ("运输", 1.2), ("使用", 8.0)]) for stage, cum in zip(trace["环节"], trace["累计kgCO2"]): print(stage, "→ 累计", cum, "kgCO2") print("越到下游,碳账越重——这正是护照要跟着供应链一起累计的原因")
这段直接累加只展示思路,真实每步要按“物料量 × 排放因子”并写明数据来源与边界,才能被海关与碳市场认账。但它足以说明:碳足迹不是单点的数,而是一条沿着供应链逐段累计的链。
落到链条的设计细节
真正做起来,有几件容易被忽略的事:
- 边界要一致:算到哪一步(摇篮到大门、还是摇篮到坟墓)先约定清楚,否则两地数字不可比。
- 数据要可审计:每一段碳数据都要能追溯到原始凭证,护照才有公信力。
- 主数据要唯一:同一种材料在不同供应商那的碳因子应统一,否则汇总会打架。
落到判断
判断一个碳足迹或护照项目靠不靠谱,就问三件事:数据源全不全、核算口径一不一致、全程可不可审计。 产品数字护照的价值,不在于“有没有那张证书”,而在于背后的数据是不是真实、可溯、能互认。把这三件事做实,碳账才算真的立得住。
本节要点回顾
- 全生命周期:抓摇篮到坟墓的整条链路碳,才能识破“外包高碳工序”的绿色陷阱。
- 护照是载体:产品数字护照沿供应链累计碳数据,让碳足迹透明可追溯。
- 战略价值:支撑碳关税申报、绿色采购、碳市场交易,一座连通四方的桥。
- 落地两难:数据可得一致性与标准互认,是数字护照绕不开的大山。
- 小步快跑:从重点行业做起,逐步建标准与互认,是务实的推进姿态。