1.1 五分钟跑起你的第一个 ClickHouse
1.1 五分钟跑起你的第一个 ClickHouse
本节摘要:本节用 Docker 把 ClickHouse 跑起来,连上客户端,建一张 MergeTree 表,灌入一批测试数据,跑一句聚合查询,让你在几分钟内拿到"亚秒级出结果"的第一手体感。动手优先,原理留给后面的章节。
学习目标
阅读完本节,你应当能够:
- 用 Docker 拉起一个 ClickHouse 服务并连上命令行客户端
- 写出一张带分区键和主键的 MergeTree 建表语句
- 用
INSERT ... SELECT和numbers表快速造测试数据 - 跑一句带
GROUP BY的聚合查询并观察耗时
一、拉起一个实例
ClickHouse 的官方镜像里同时打包了服务端和客户端,一条命令就能起一个单机实例。假设你机器上装了 Docker,打开终端执行:
docker run -d --name ch-play \ -p 8123:8123 -p 9000:9000 \ clickhouse/clickhouse-server
这两个端口要记住:8123 是 HTTP 端口,给 HTTP 客户端和驱动用;9000 是原生 TCP 端口,给命令行客户端和原生协议驱动用。很多人第一次连不上,就是端口搞混了——用 JDBC 走 HTTP、用 clickhouse-client 走 TCP,别张冠李戴。
起好之后,进容器跑客户端:
docker exec -it ch-play clickhouse-client
看到 ch-play :) 这个提示符就说明连上了。ClickHouse 的 SQL 方言和 MySQL 比较接近,但有些细节不一样,后面会逐个点到。
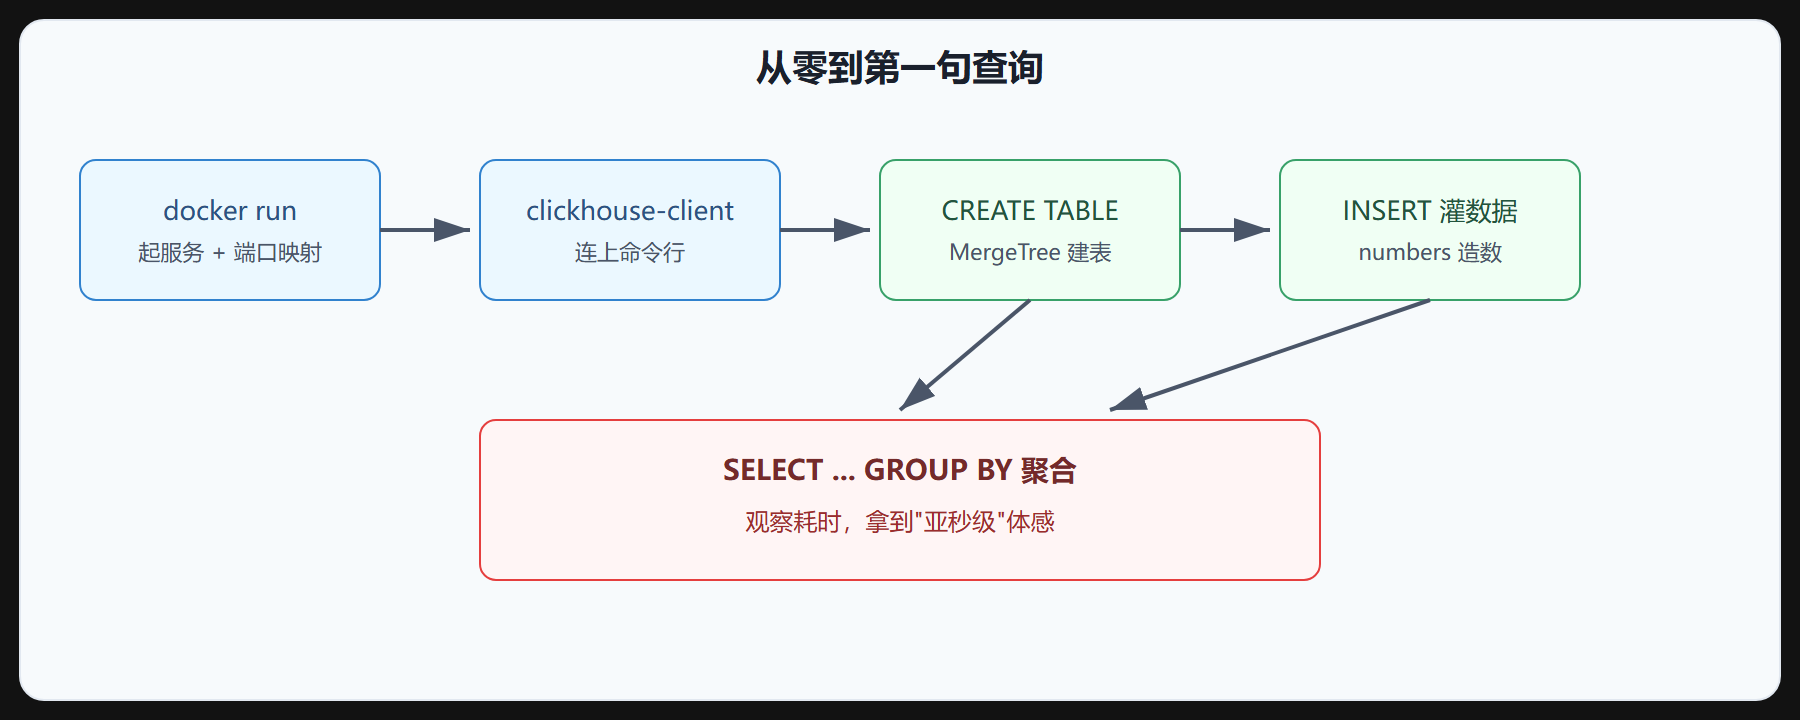
安装与首查询流程
下面这张图把从拉镜像到出结果的整个流程串起来,心里有这条主线,后面每一步都对得上。
图 1-1 从零到第一句查询的流程
二、建一张表
我们来建一张模拟"用户行为日志"的表,这是 ClickHouse 最典型的用法。在客户端里执行:
CREATE TABLE events ( event_time DateTime, user_id UInt64, event_type LowCardinality(String), city LowCardinality(String), amount Float64 ) ENGINE = MergeTree PARTITION BY toYYYYMMDD(event_time) ORDER BY (event_time, user_id);
逐行说清楚这几行在做什么,因为它们是后面所有章节的根。
ENGINE = MergeTree:选 MergeTree 引擎。这是 ClickHouse 最核心的引擎家族,几乎所有 OLAP 场景都从它开始。别的引擎(如 Log、TinyLog)只是特例。PARTITION BY toYYYYMMDD(event_time):按天分区。分区是 ClickHouse 管理数据的最粗粒度单位,查询时能用分区键裁掉不相关的整块数据。ORDER BY (event_time, user_id):这是 MergeTree 的主键,也叫排序键。数据在磁盘上按这个顺序物理排列,查询时靠它做稀疏索引跳过无关数据块。
💡 关键直觉:ClickHouse 的
ORDER BY既是排序键也是主键索引,它决定了数据在磁盘上的物理顺序。这跟 MySQL 的"主键 = 唯一约束"完全不是一回事——ClickHouse 的主键不要求唯一,它要求的是"查询时最常过滤的列排前面"。
注意 LowCardinality(String) 这个类型。它对枚举值少(比如城市名、事件类型)的字符串做了字典编码,能大幅省存储和提速。这是 ClickHouse 一个很实用的特性,第 3 章会细讲。
三、灌点数据
真实业务里数据是流式写入的,这里为了演示,用 ClickHouse 自带的 numbers 表函数快速造一批。numbers(N) 返回 0 到 N-1 的整数序列,我们用它生成一千万行:
INSERT INTO events SELECT now() - (number % 86400) AS event_time, number % 100000 AS user_id, ['click','view','pay','login'][1 + (number % 4)] AS event_type, ['北京','上海','广州','深圳','杭州'][1 + (number % 5)] AS city, rand() % 1000 / 10.0 AS amount FROM numbers(10000000);
这一句会灌入一千万行数据。在普通笔记本上,ClickHouse 灌一千万行通常只要几秒——这本身就是它写入吞吐的体现。等它跑完,我们来查一下:
SELECT count() FROM events;
四、跑一句聚合
现在跑一句典型的分析查询:每个城市的总金额和事件数。
SELECT city, sum(amount) AS total_amount, count() AS event_count FROM events GROUP BY city ORDER BY total_amount DESC;
按一下回车,结果几乎瞬间就出来了。一千万行的聚合在单机上亚秒级完成,这就是 ClickHouse 的体感。如果换成 MySQL 跑同样规模的聚合,多半要转好几秒甚至更久。
我们再跑一句带时间过滤的,体会分区裁剪的效果:
SELECT event_type, count() FROM events WHERE event_time >= now() - 3600 GROUP BY event_type;
这句只查最近一小时的,ClickHouse 会通过分区键直接跳过其他天的数据,扫描量更小,更快。
五、几个容易踩的坑
| 现象 | 原因 | 怎么办 |
|---|---|---|
| 客户端连不上 9000 端口 | 用了 HTTP 驱动连 TCP 端口 | HTTP 用 8123,TCP 用 9000 |
INSERT 单行很慢 |
ClickHouse 不擅长高频单行写 | 改成批量插入,每次几千行起 |
查询报 Memory limit exceeded |
聚合基数太大撑爆内存 | 加 GROUP BY 限制或调 max_memory_usage |
| 表建完查不到刚插入的数据 | 用了 ReplacingMergeTree 还没合并 | 用 FINAL 或等后台合并 |
⚠️ 常见坑:很多人拿 ClickHouse 当 MySQL 用,一条一条
INSERT单行,结果写入吞吐惨不忍睹。ClickHouse 的写入是"批量追加"模型,单次插入至少要凑够一批(官方建议每批不少于 1000 行,理想是几万到百万行)。高频小批量写入是 ClickHouse 最忌讳的用法,第 2 章会从存储结构解释为什么。
一节小结
- 两个端口:
8123是 HTTP、9000是原生 TCP,别连错。 - 建表三要素:
ENGINE = MergeTree、PARTITION BY分区键、ORDER BY主键/排序键,三者决定数据的物理布局。 ORDER BY不是唯一约束,它是排序键,决定查询能跳过多少数据块,把最常过滤的列排前面。LowCardinality(String)对低基数字符串做字典编码,省存储又提速。- 写入要批量,单行高频写是 ClickHouse 的死穴。
- 一千万行聚合亚秒级出结果,这是 ClickHouse 给你的第一手体感。
下一节我们回头解释:为什么刚才那句聚合能这么快?列存、向量化、稀疏索引、MergeTree 各贡献了多少。