1.2 ClickHouse 是什么,为什么这么快
1.2 ClickHouse 是什么,为什么这么快
本节摘要:ClickHouse 是一个面向 OLAP 场景的列式数据库,由 Yandex 为其 Web 分析产品 Metrica 而开发。它快的原因不是某一项黑科技,而是列式存储、向量化执行、稀疏主键索引、MergeTree 合并模型四件事的叠加。本节把这四件事拆开讲,并说清它慢在哪。
本节目标
阅读完本节,你应当能够:
- 区分 OLTP 和 OLAP,说清 ClickHouse 的定位
- 解释列式存储为什么对聚合查询友好
- 说清向量化执行和逐行执行的区别
- 描述稀疏主键索引如何跳过无关数据块
- 指出 ClickHouse 不擅长的几类场景及原因
一、它是什么:一个为分析而生的列式数据库
ClickHouse 最初是俄罗斯搜索引擎公司 Yandex 内部为 Web 分析产品 Metrica 开发的存储引擎。Metrica 的业务特点很极端:每秒要写入数亿条用户行为事件,同时要支撑几千个实时仪表盘做即席查询,且不允许采样失真——分析师查出来的数必须和原始日志对得上。这个组合需求把传统架构逼到了墙角:写入要快就得批量追加,查询要快就得有索引,但索引多了写入又慢,这是个死结。
ClickHouse 的解法是放弃 OLTP 的强项——事务、点查、单行更新——把全部工程预算压在"批量写入 + 批量扫描聚合"这一条路上。它是一个 OLAP(在线分析处理)数据库,不是 OLTP(在线事务处理)数据库。这个定位决定了它后面所有的设计取舍。
| 维度 | OLTP(MySQL 等) | OLAP(ClickHouse) |
|---|---|---|
| 典型负载 | 高频点查、短事务 | 大范围扫描、聚合 |
| 写入模式 | 单行随机写 | 批量追加 |
| 存储布局 | 行存 | 列存 |
| 事务 | 强 ACID | 弱,最终一致 |
| 更新/删除 | 原生支持 | 重,要异步合并 |
| 并发模型 | 大量连接 + 锁 | 少查询 + 大扫描 |
记住这张表,后面所有"为什么 ClickHouse 这么设计"都能从这张表推出来。
二、为什么快:四个机制的叠加
机制一:列式存储
行存把一行的所有字段连续放在一起,列存把一列的所有值连续放在一起。看起来只是排列方式不同,但对聚合查询影响巨大。
假设有一张 10 列的表,你要算 SELECT sum(amount) FROM events。行存要把每一整行都从磁盘读出来(因为字段是连续的),即使你只要其中一列。列存只读 amount 这一列,其他 9 列根本不碰。如果每列平均 100 字节,行存读 1000 字节/行,列存只读 100 字节/行——IO 直接降到十分之一。
图 1-2 列存 vs 行存的读取差异
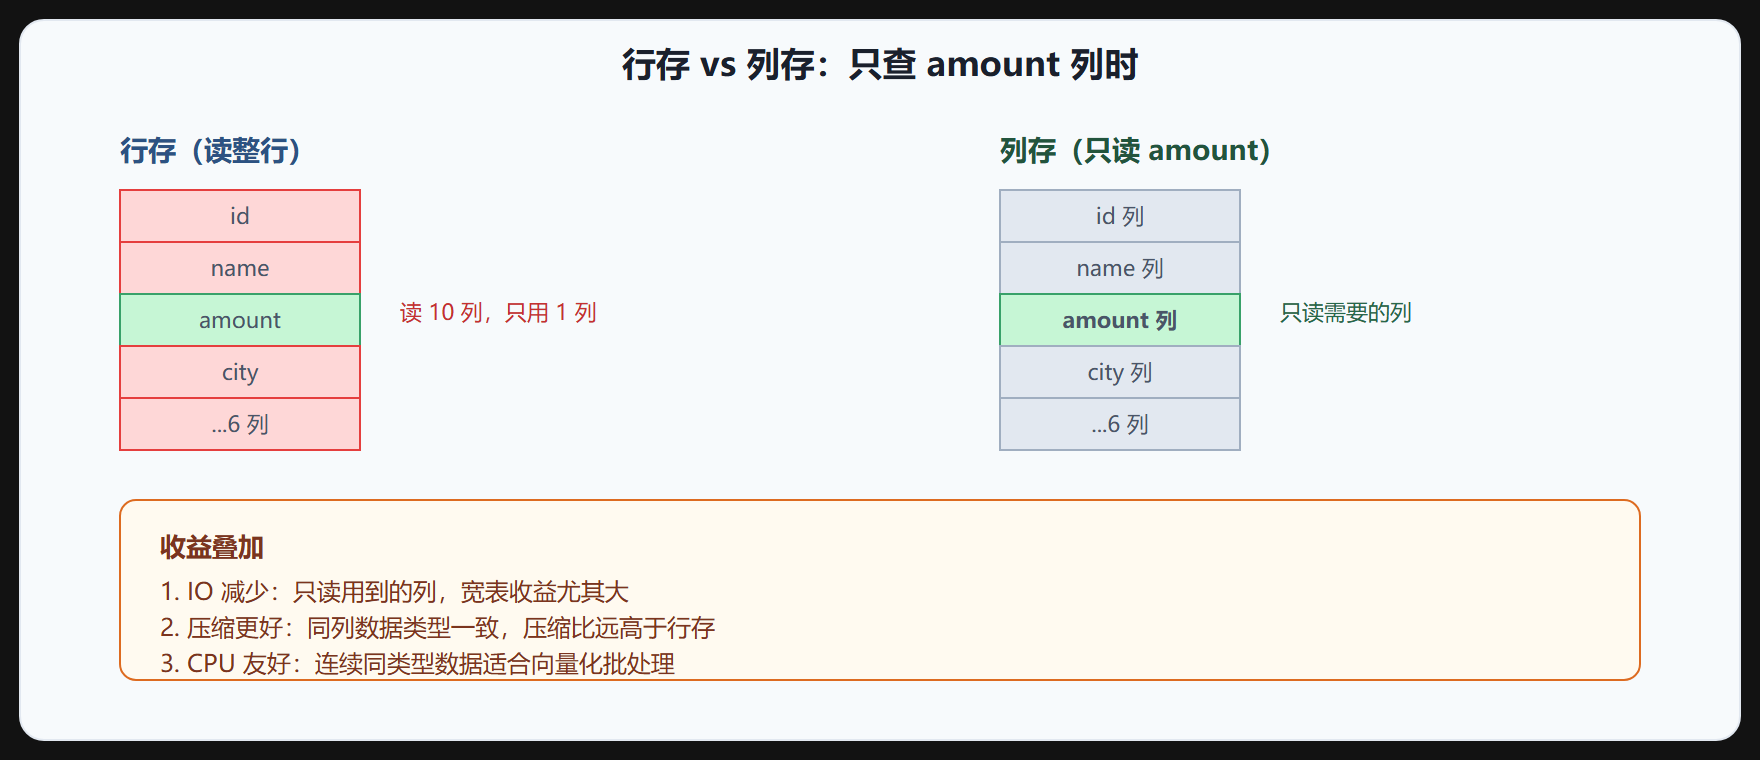
列存还有一个隐性收益:压缩。同一列的数据类型一致(都是整数、都是字符串),压缩算法能找到的规律远多于行存里"一行混着各种类型"的情况。ClickHouse 的实际压缩比通常能到 5–10 倍,等于又把 IO 量降了一个量级。
机制二:向量化执行
光把数据按列排好还不够,CPU 处理数据的方式也得跟上。传统的逐行执行是:取一行、算一次、再取下一行。向量化执行是:取一批(比如几千个值)同类型的数据,用 CPU 的 SIMD 指令一次算完这批,再取下一批。
打个比方,逐行执行像一个人一件一件搬砖,向量化执行像用叉车一次叉一摞。对 sum(amount) 这种聚合,向量化能把 CPU 利用率拉满,几千万个数的求和在毫秒级完成。
向量化要求"一批数据类型一致且连续",这正好是列存天然提供的。所以列存和向量化是配套的,缺一不可——行存很难做向量化,因为一行里类型杂。
机制三:稀疏主键索引
光扫一列还是不够快,如果能跳过不相关的数据块就更好。ClickHouse 的 MergeTree 把数据按 ORDER BY 排序后切成一个个 granule(默认 8192 行一个 granule),每个 granule 在主键索引里记一条。查询时先查主键索引,找出哪些 granule 可能含目标数据,其余的直接跳过。
这就是"稀疏"的含义:不是每行都有索引项,而是每 8192 行才一条,索引本身极小,常驻内存。如果查询条件命中主键前缀,ClickHouse 能跳过 99% 的 granule,只扫描命中的一小部分。
机制四:MergeTree 合并模型
写入要快就得追加,但追加多了数据就碎,查询要扫很多小文件。MergeTree 的解法是:写入时追加成 part,后台异步把小 part 合并成大 part。这样写入快(只追加)、查询也快(合并后大 part 扫描效率高),代价是后台合并要消耗资源、且数据有"最终一致"的特性。
这四个机制是叠加的:列存降 IO、向量化拉满 CPU、稀疏索引跳过无关块、合并模型扛住写入。少了任何一个,ClickHouse 都不会这么快。
三、它慢在哪
只说快不说慢是不诚实的。ClickHouse 有几类天生不擅长的活:
- 高频单行写入:每次插入一个 part,后台要合并,单行写会制造海量小 part,把合并拖垮。
- 点查(按主键取单行):能查,但不如 Redis/MySQL 快,因为稀疏索引定位到 granule 后还要扫 8192 行。
- 频繁 UPDATE/DELETE:本质是异步重写整个 part,重且慢,不适合 OLTP 那种频繁改单行的场景。
- 复杂多表 JOIN:宽表预聚合是它的主场,星型模型多表 JOIN 虽然支持但性能不如专门的 MPP 引擎。
⚠️ 别走极端:ClickHouse 不是万能数据库。把高频点查、强事务、频繁单行更新的业务塞给它,结果一定是灾难。它的主场是"批量写 + 大扫描聚合"。
💡 关键直觉:ClickHouse 的快是用"放弃 OLTP 能力"换来的。理解了它放弃了什么,就理解了它的边界在哪。
核心回顾
- 定位:ClickHouse 是 OLAP 列式数据库,不是 OLTP,所有设计取舍都从这里出发。
- 快的四个来源:列存降 IO、向量化拉满 CPU、稀疏主键索引跳过无关块、MergeTree 合并模型扛住批量写入。
- 列存 vs 行存:聚合只读需要的列,IO 大幅减少;同列压缩比也更高。
- 稀疏索引:每 8192 行一条索引项,索引极小常驻内存,命中主键前缀能跳过 99% 数据。
- 慢的地方:高频单行写、点查、频繁更新删除、复杂多表 JOIN——这些是它放弃的领域。
下一节把这四个机制和其余能力摆成一张全景图,让你对 ClickHouse 的能力边界有个整体印象。
用一句 SQL 感受列存的威力
光讲原理可能不够直观,建议你手上有个环境后亲手做一次对比:建一张一百万行的宽表,分别跑"只读一列"和"读全部列"的查询,观察 system.query_log 里的扫描字节数。ClickHouse 会记录每一次查询的详细指标:
-- 建一张 100 万行的订单表(生产环境数据量通常远大于此) CREATE TABLE orders ( order_time DateTime, user_id UInt64, city String, amount Float64, device String ) ENGINE = MergeTree PARTITION BY toYYYYMMDD(order_time) ORDER BY (order_time, user_id); -- 查看最近一条查询读了多少字节、扫了多少行 SELECT read_bytes, read_rows, query_duration_ms, query FROM system.query_log ORDER BY event_time DESC LIMIT 1;
对比两种写法:SELECT sum(amount) FROM orders 只读 amount 一列,read_bytes 远小于读整行;而 SELECT * FROM orders 会读全部五列,read_bytes 成倍增长。同一个表、同一种数据量,仅仅是"读哪几列"的选择,就决定了查询是毫秒级还是秒级。这就是列存最朴素也最直接的收益。
再配合 EXPLAIN 看执行计划,确认优化器有没有把过滤下推到扫描层:
EXPLAIN SELECT city, sum(amount) FROM orders WHERE order_time >= '2024-06-01' AND order_time < '2024-07-01' GROUP BY city;
如果 EXPLAIN 输出里过滤步骤紧挨着扫描,说明裁剪生效了;如果过滤发生在合并之后,说明谓词没有下推,通常是条件里写了函数或类型不匹配。把这两个例子跑一遍,你对"为什么快"的体会会从抽象变成具体。