5.3 节点数字的真相:从22nm到3nm到底缩了什么
5.3 节点数字的真相:从22nm到3nm到底缩了什么
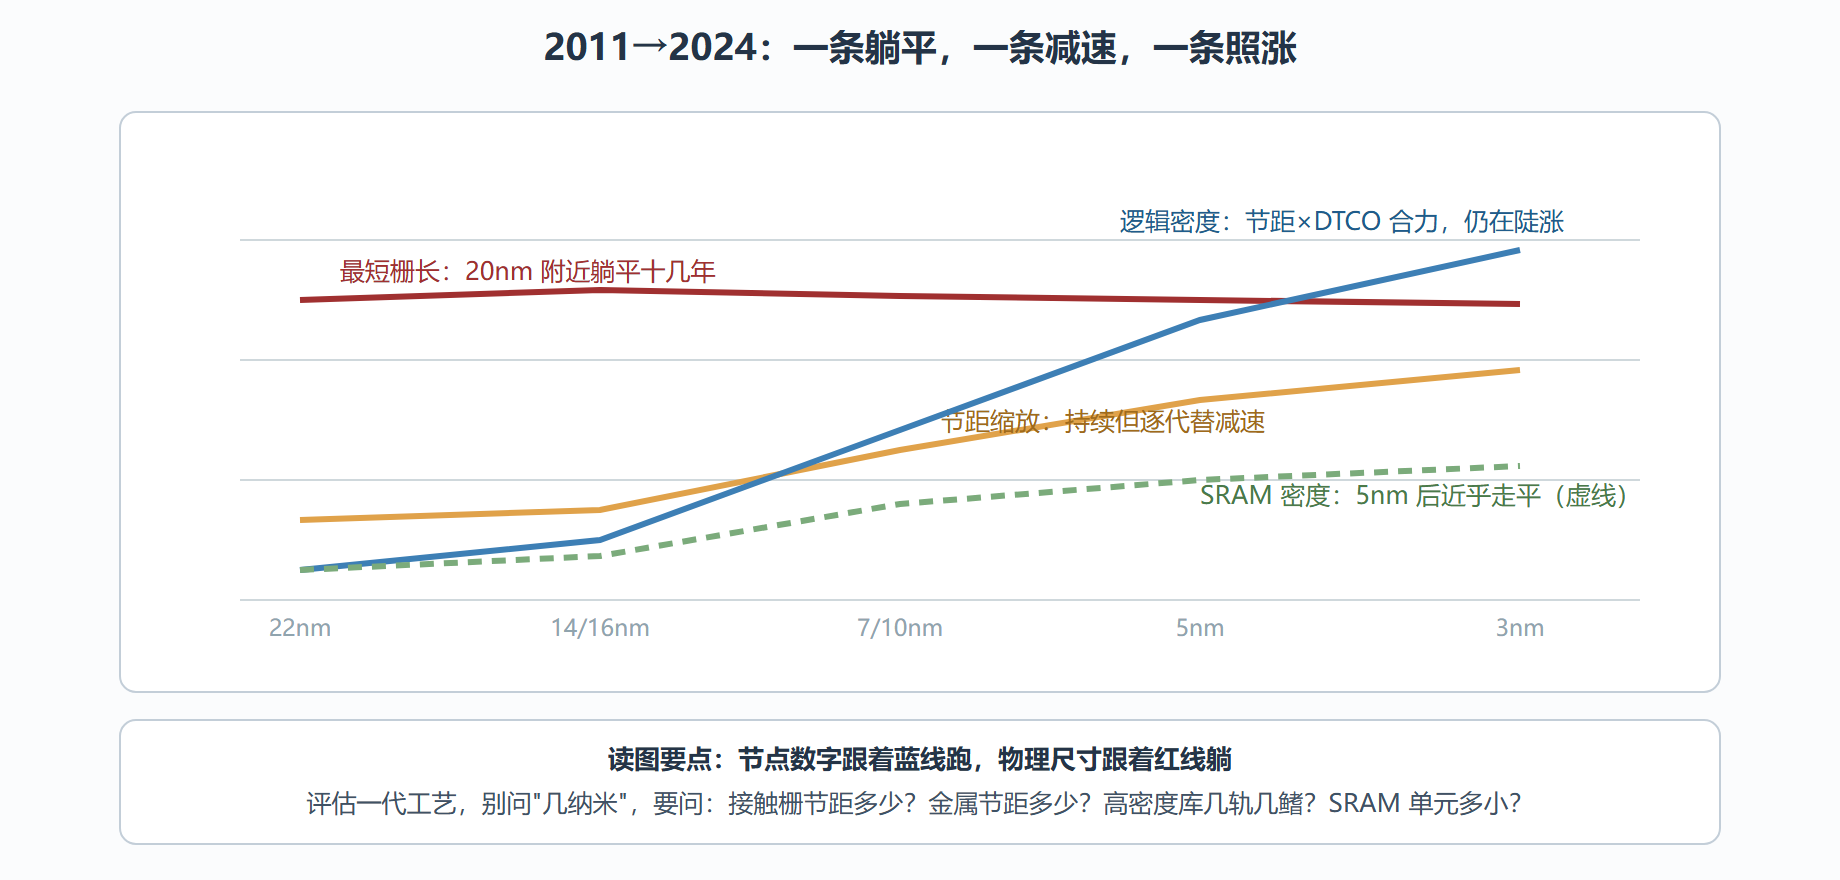
拿卡尺去量一颗"3 纳米"芯片,你找不到任何 3 纳米的尺寸。 最短的栅长停在十几到二十纳米已经快二十年,最细的金属线间距是二十纳米级,鳍宽是五纳米级——没有一个数字等于 3。节点名早已从"物理尺寸"退化为"代际商标"。本节讲清这场退化的来龙去脉,列出每代真正在缩的三个节距,并用算例拆穿密度宣传的话术,最后解释为什么 SRAM 的微缩先一步躺平。
节点名是怎么和尺寸脱钩的
FinFET 之前的命名还算诚实:"32 纳米工艺"的栅长确实是三十纳米上下。转折发生在两个物理墙相继立起之后:沟道太短则隧穿失控,栅长在二十纳米附近实质性停滞;栅介质薄到几个原子层后靠高 k 材料续命,进一步压缩的空间也没了。可产业还需要一个每代前进的坐标——于是节点名与任何单一物理尺寸脱钩,变成"这一代整体密度与性能水平的代号"。从 16/14 纳米那一代起,各家厂商标注的数字不再对应同一物理量,同一节点名下不同厂商的节距可以差出百分之十几。
判断一代工艺的真实水平,要看三个节距:接触栅节距(相邻栅的中心距,决定标准单元的宽度方向)、最小金属节距(互线的中心距,决定布线密度)、鳍节距(决定单元高度方向能排多少鳍)。逻辑密度的第一近似就是前两个节距乘积的倒数,再乘上单元高度方向的设计协同收益。
| 节点名(上市序) | 代表年代 | 最短栅长趋势 | 节距与密度的实际动作 | 标称逻辑密度增益 |
|---|---|---|---|---|
| 22/20nm | 2011–2014 | 首代 FinFET,~26nm | 鳍式三面栅替代平面,密度微缩为主 | 基准 |
| 16/14nm | 2014–2017 | 停在 20nm 级 | 节距基本平移,靠 FinFET 拿性能与漏电 | 约 1.1–1.2× |
| 10/7nm | 2017–2020 | 停在十几 nm | 节距实质缩两成级,多重图形化铺开 | 约 1.6× |
| 7nm+/6/5nm | 2020–2022 | 基本不动 | EUV 引入替代多重图形,节距续缩 | 约 1.7–1.8× |
| 4/3nm | 2022– | 基本不动 | 节距续缩但放缓,靠库设计与堆叠补密度 | 约 1.25–1.3× |
两个转折值得圈出来。第一,16/14 纳米那一代节距几乎没缩——那一代卖的全部是 FinFET 本身的红利(第 1、2 章的静电收益兑现成同功耗性能提升三四成)。第二,密度增益从 7 纳米代的近两成节距缩幅,滑到 3 纳米代的一成出头——节距缩放这台发动机的输出,肉眼可见地在衰减。
# 逻辑密度的第一近似:密度 ∝ 1/(接触栅节距 × 最小金属节距),再乘库高协同因子 gens = [ ("16/14nm", 90, 64, 1.00), ("10/7nm", 66, 44, 1.10), ("6/5nm", 57, 36, 1.15), ("4/3nm", 51, 32, 1.10), ] base = None for name, cpp, mm, lib in gens: d = lib / (cpp * mm) # 任意单位的相对密度 if base is None: base = d print(f"{name}: 相对逻辑密度 ≈ {d/base:.2f}×(上一代的 {d/base:.2f} 倍基准)") # 即便节距照缩,代际增益也从 ~1.6× 滑向 ~1.3×——发动机在减速,数字营销还在加速
设计协同:数字缩不动的部分靠什么补
节距缩放减速之后,密度的接力棒传给了设计工艺协同优化(DTCO)。单元高度从早期 FinFET 的八九轨降到六七轨再往五轨压——同一片面积里塞进更多行单元;单元内部从每轨三鳍降到两鳍再降到单鳍,配合 4.1 节讲过的宽度量化,库设计者学会了"用更少的鳍、更挤的布局换密度";布线层往上再摞几层,供电网络从正面改到晶圆背面,给信号层腾出资源。这些动作不改变任何光刻物理,但每一项都在真实地压密度。
从另一个角度读 5.1、5.2 两节:两条工艺路线的全部努力——筑坝、驯浮体、压寄生——都是在节距每代缩一两成的既定节奏下,把性能和良率的账做平。节距缩放是发动机,DTCO 是变速箱,路线之争争的是底盘调校。
图 5-3 节点名、物理尺寸与密度的三条曲线
SRAM 先躺平:密度故事里最诚实的一条线
逻辑密度靠 DTCO 还能续命,SRAM 不能。存储位单元是高度定制的六管或八管结构,单元面积直接由鳍节距、栅节距与接触尺寸决定,几乎没有 DTCO 的腾挪空间——它因此成了衡量微缩健康度最诚实的指标。而这条指标讲的故事不乐观:先进节点上,高密度 SRAM 单元的面积在 5 纳米代已经只缩百分之二十上下,到 3 纳米代几乎原地踏步——逻辑密度靠库设计每年还在爬,缓存密度却停了下来。这直接改写了芯片架构的经济学:缓存占先进芯片面积的三到六成,SRAM 不缩,整机密度收益就被大幅稀释,也催生了加大容量末级缓存、近存计算这些架构层面的对策。
怎么读厂商的密度宣传
三条防忽悠守则。第一,分开问逻辑与 SRAM:宣传页的"密度提升若干成"几乎总指高密度逻辑库,同一代的 SRAM 缩幅要单独问,答案常常尴尬。第二,问清楚对比的库类型:用高性能库对比上一代高密度库,数字能差出一截——轨数、鳍数、驱动档位全不同的两个库,直接比每平方毫米晶体管数没有意义。第三,性能与功耗的修辞要看方向:"同功耗性能加两成"与"同性能功耗省四成"可以来自同一颗芯片,只是选了不同的表述锚点;更要留意的是,这些数字通常基于特定的测试电路与条件,落到你的实际设计上要重新折算。
节点数字退化为商标,不是欺瞒,是产业需要一根公众能理解的进度轴。但对工程师而言,把商标当物理尺寸就是事故的开始——选工艺、估密度、排布图,永远从节距、库高、鳍配置这些真实数字出发。
本节要点回顾
- 节点名与物理尺寸早已脱钩:最短栅长在二十纳米附近停了十几年,"3 纳米"里没有 3 纳米——它是代际商标,不是尺寸标注。
- 每代真正缩的是三个节距:接触栅节距、最小金属节距、鳍节距;逻辑密度第一近似等于前两者乘积的倒数乘库协同收益。
- 16/14 纳米那一代节距没缩:那一代卖的是 FinFET 结构红利本身;7 纳米后 EUV 接棒多重图形化,节距续缩但增益逐代从近两成滑向一成。
- DTCO 是减速期的变速箱:单元高度从八九轨压向五六轨、单轨鳍数递减、背面供电——不动光刻物理,持续压密度。
- SRAM 是最诚实的温度计:没有 DTCO 空间的位单元在 5 纳米后近乎走平,缓存占芯片面积三到六成,它躺平就稀释掉整机的密度叙事。
- 读宣传的三个动作:分开问逻辑与 SRAM、确认对比库的类型、辨清性能功耗表述的锚点。
缩放发动机的减速,正是第 7 章"FinFET 终点与接班人"的伏笔。但在此之前,第 6 章先看这个格局上长出来的变体与生态。