6.3 一次502故障的完整复盘
6.3 一次502故障的完整复盘
本节摘要:502 表示网关收到了后端的无效响应或根本连不上后端。本节按时间线复盘一次真实故障:从告警到根因 20 分钟,演示"指标切面 → 日志证据 → 配置对照 → 根因确认"的完整排查链路,把全书知识串成一条线。
时间线
第 0 分钟:告警。 5xx 比例 0.3% 涨到 6%,全部是 502,集中在下单接口。
第 3 分钟:指标切面。 stub_status 上 Writing 从 200 涨到 1400——响应堆积;QPS 没涨,说明不是流量问题;应用服务器 CPU 正常。初步定位:Nginx 与后端之间"协商失败",不是算不动。
第 7 分钟:日志证据。 错误日志里成片出现:
upstream sent too big header while reading response header from upstream
访问日志佐证:出问题的请求 urt 都极短(几毫秒就断),响应体 0 字节——不是超时,是握手后被拒。
第 12 分钟:配置对照。 对照 2.3 节的缓冲参数:proxy_buffer_size 还是默认 8k。当晚发版的新接口在下单异常时会返回一个带完整调试信息的超大响应头(后端把整段堆栈塞进了 header),超过 8k,Nginx 按"无效响应"处理成 502。
第 15 分钟:止血。 紧急调整并 reload:
proxy_buffer_size 32k; proxy_buffers 16 32k; proxy_busy_buffers_size 64k;
502 消失。
第 20 分钟:根因归档。 真正的根因有两个:新接口不该把调试信息放响应头(后端修复);网关缓冲参数没有随业务复杂度演进(平台侧修复)。两边都改,事故才不会重演。
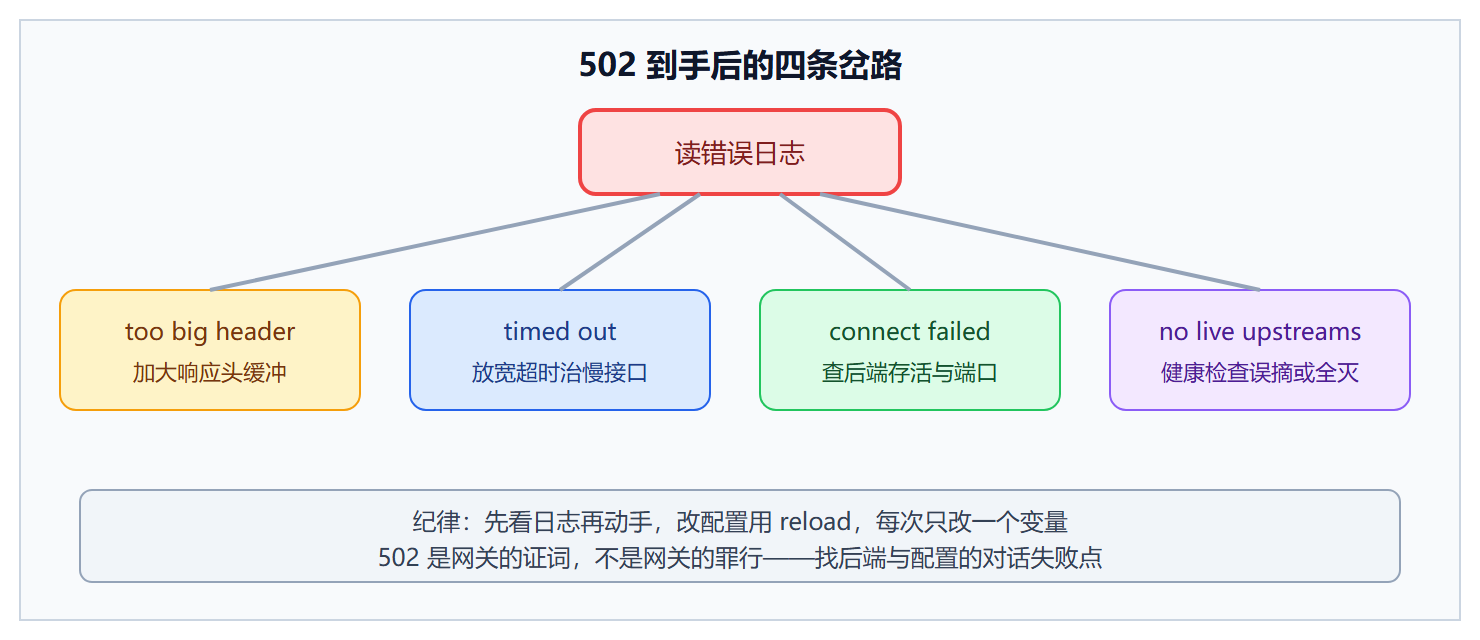
502 家族的对照表
同样的状态码,含义分岔:
| 错误日志关键词 | 根因方向 | 处理 |
|---|---|---|
| too big header | 响应头超缓冲 | 加大 proxy_buffer_size(本案例) |
| upstream timed out | 后端处理超时 | 放宽 read_timeout 或治慢接口 |
| connect() failed | 连不上后端 | 后端挂了或端口错,查健康状态 |
| no live upstreams | 全部节点被摘 | max_fails 误摘或后端全灭 |
| reset by peer | 后端主动断连 | 应用崩溃或中间设备杀连接 |
排查的关键动作是先读错误日志再看访问日志:前者给"哪一层失败",后者给"哪些请求、多广面"。
图:502 排查决策树
复盘沉淀的三条纪律
一是每次只改一个变量:止血时同时改缓冲、超时、重启后端,就算恢复了也不知道哪个起了作用,下次还得赌。二是根因必须落到配置或代码:"调大就好了"不算结论,要回答"为什么是 8k 就炸、谁该负责演进这个参数"。三是把错误日志关键词写进排障手册:502 家族对照表就是这次复盘的产物,下次第一分钟就能岔对路。
如果根因在别处:三条平行时间线
同一个 502 症状,另外两种根因的排查路径长什么样,值得对照演练。版本 B,后端进程假死:Writing 同样堆积,但错误日志是 upstream timed out 而非 too big header,urt 是打满超时值而不是极短——一个是"等不到",一个是"被拒绝",日志措辞就是分岔口。版本 C,连接数耗尽:错误日志出现 no live upstreams 或 connect 拒绝,访问日志里 urt 为空(根本没到后端),此时去查后端进程存活与端口监听,一分钟见分晓。把三条时间线的差异压缩成口诀:urt 极短看缓冲、urt 打满看超时、urt 为空看存活。
too big header → 缓冲参数(本案例 15 分钟止血) timed out → proxy_read_timeout 或后端慢查询 connect refused / no live upstreams → 后端存活与摘除策略
演练:把复盘变成能力
复盘文档写完不等于团队有了能力,定期演练才是转化器。 quarterly 演练的方式:值班工程师在测试环境随机注入一种 502(改小缓冲、杀后端进程、加超短 read_timeout),另一位只给告警不透露注入方式,按四步链路走完排查并计时。三次演练后,团队的平均定位时间从 25 分钟降到 8 分钟——不是因为更聪明,而是因为错误日志关键词到根因方向的映射被练成了条件反射。故障处理的水平不是靠真事故堆出来的,是把事故的教训变成可重复的练习。
复盘的最后一块拼图是横向推广:这次事故暴露的"缓冲参数没有随业务演进"问题,在其他集群同样存在。一周内对所有入口做了参数审计,三个集群发现同类隐患。单次复盘的价值是修好一台机器,把复盘结论升级为全量检查项,价值才放大到整个体系。事故是学费,交一次就该全班级学会——这是全书把 502 复盘放在最后的原因:它不只演示一次排障,更演示了如何把故障变成组织资产。
合上这次复盘,把全书的知识点按这次故障的排查顺序串一遍:识别症状用到第二章的日志字段设计,定位层级用到第六章前两节的指标与日志手法,根因确认用到第二章的代理缓冲知识,修复动作用到第一章讲的平滑 reload,预防措施落在第五章的监控面板与本章的演练机制。一次 502 走下来,六本书六章全部派上用场——这就是"体系化知识"的含义:每个知识点都有一根线连到真实故障的某个环节,而不是孤零零躺在指令手册里。
这次复盘还留下了一个小小的组织惯例:重大故障的复盘会必须在恢复后四十八小时内开,趁着记忆新鲜,且负责人必须到场讲清自己环节的时间线。拖到一周后的复盘,细节被记忆美化、借口被时间发酵,产出只剩一份人人签字的文档。二十分钟的故障,值得一场认真的一小时会议——这是对故障本身最好的尊重。
本节要点回顾
- 排查链路固定:指标切面定层 → 错误日志定性 → 访问日志定量 → 配置对照定位;
- 502 是证词不是判决:根因分布从缓冲、超时到后端存活都可能;
- rt/urt 双字段区分超时与立即失败,本案例 urt 极短即"握手即拒";
- 复盘产出纪律与手册,而不是一次性的"重启解决"。