4.4 综合演练:日志字段提取
4.4 综合演练:日志字段提取
本节把前 3 节的零件组装成一台完整机器:识别两种格式的访问日志,提取 IP、时间、接口、状态码、耗时五个字段,清洗后产出结构化记录,为第 5 章的多文件流水线备好内核。
任务与样本
手头两种行格式并存:
10.0.0.5 [12/Aug/2026:03:14:51] "GET /api/order" 200 12ms 10.0.0.9 - 03:14:52 WARN /api/search 503 890ms
目标是把它们都变成统一记录:IP|时间|接口|状态|耗时。
完整解析函数
#!/usr/bin/perl use strict; use warnings; my $acc_re = qr{ ^(\S+) # 1: IP \ \[(\d{2}/\w{3}/\d{4}:\d{2}:\d{2}:\d{2})\] # 2: 完整时间 \ "(\w+)\ (\S+)" # 3: 方法 4: 路径 \ (\d{3}) # 5: 状态码 \ (\d+)ms$ # 6: 耗时 }x; my $simple_re = qr{ ^(\S+)\ -\ (\d{2}:\d{2}:\d{2})\ \w+ # 1: IP 2: 时刻 3: 级别占位 \ (\S+) # 4: 路径 \ (\d{3})\ (\d+)ms$ # 5: 状态 6: 耗时 }x; sub parse_line { my ($line) = @_; chomp $line; $line =~ s/\s+/ /g; # 压缩空白,抵御对齐差异 if (my @f = ($line =~ $acc_re)) { return { ip => $f[0], time => $f[1], api => $f[3], status => $f[4], ms => $f[5] }; } if (my @f = ($line =~ $simple_re)) { return { ip => $f[0], time => $f[1], api => $f[2], status => $f[3], ms => $f[4] }; } return undef; }
qr{...}x 的 x 标志允许在模式里排空白与注释——长正则不写注释,一个月后自己都读不懂。
消费端:一分钟验收
my %status_count; my $parsed = 0; my $failed = 0; while (my $line = <DATA>) { my $rec = parse_line($line); if ($rec) { $parsed++; $status_count{ $rec->{status} }++; } else { $failed++; } } printf "解析成功 %d 行,失败 %d 行\n", $parsed, $failed; $status_count{$_} and printf " %s : %d 次\n", $_, $status_count{$_} for sort keys %status_count;
两种格式到统一记录的映射
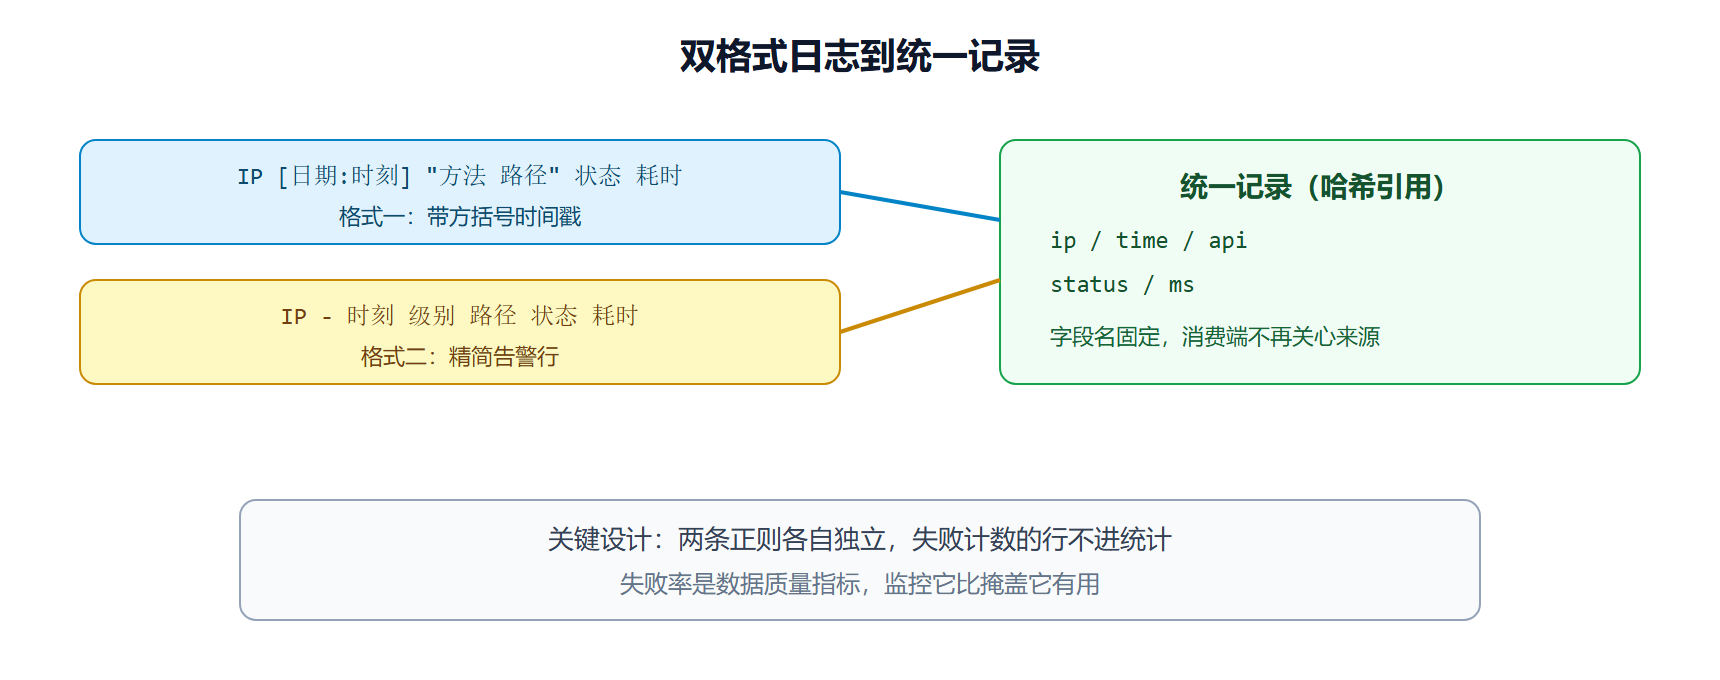
⚠️ 常见坑:不要写一条"万能正则"硬吃两种格式。两条独立模式各管一种,谁失配就归入失败计数,排查时一眼就知道是哪种格式出了问题。
变式一:格式漂移的防御性处理
真实的日志格式会漂移:新版本加了字段、时间格式换了、耗时单位从 ms 变成 s。演练机器要活得久,得在三个位置预留弹性。第一,模式里对"可能消失的字段"用可选分组并给默认值:
\ (?:([0-9.]+)m?s)? # 耗时字段可选,秒或毫秒都可能 # 解包侧补默认值: ms => $f[5] ? ($f[5] =~ /s$/ ? $f[5] * 1000 : $f[5]) : 0,
第二,入口保留原始行进失败样本文件,格式漂移当天就能从样本里看出变化,而不是从统计数字的异常倒推。第三,给 parse_line 加版本号常量并在输出里打印——两份日志对不上时先确认双方用的解析版本是否一致,这是多人协作排查时最常被忽略的一步。
变式二:从行到指标,再走一步
解析出结构化记录只是半程,顺势接上聚合才有产出感。在消费端后面加两层统计:
my (%api_ms, %status_by_api); while (my $line = <$fh>) { my $r = parse_line($line) or next; push @{ $api_ms{ $r->{api} } }, $r->{ms}; $status_by_api{ $r->{api} }{ $r->{status} }++; } for my $api (sort { avg($api_ms{$b}) <=> avg($api_ms{$a}) } keys %api_ms) { my @v = sort { $a <=> $b } @{ $api_ms{$api} }; my $err5xx = 0; $err5xx += $status_by_api{$api}{$_} for 500 .. 599; printf "%-20s 均值 %4dms P95 %4dms 5xx %d 次\n", $api, avg(\@v), $v[ int(@v * 0.95) ], $err5xx; } sub avg { my $v = shift; return 0 unless @$v; my $sum = 0; $sum += $_ for @$v; return $sum / @$v; }
P95 用排序后取分位点实现,比均值更能暴露长尾——接口均值 50ms 但 P95 两秒,用户抱怨的正是后一种体验。这段聚合逻辑将在 5.3 节直接搬进多文件批处理,此处先把单文件版本跑顺。
变式三:与其他日志的联查思路
字段提取的最后一级应用是跨日志关联。访问日志里的请求 ID(若有)能串起应用日志的处理链路:先从访问日志提取慢请求的 ID 集合装进哈希,再扫应用日志时只保留命中行。两次扫描、一个哈希、零复杂数据库——文本工坊处理千万行级关联问题的标准姿势。若日志没有请求 ID,退而求其次用"IP + 秒级时间窗"做弱关联,命中精度虽降,定位方向已经够用。
本节要点回顾
qr//x带注释的长正则是可维护性的底线- 压缩空白再匹配,抵御不同来源的对齐差异
- 返回哈希引用而不是裸列表,字段名即文档
- 失败计数单独保留,它是日志质量的第一手信号
- 这个 parse_line 就是第 5 章流水线的内核,届时只换输入源
评论区
(0)
U