1.3 共享缓冲区:页面在内存中的生命周期
1.3 共享缓冲区:页面在内存中的生命周期
本节摘要:共享缓冲区是所有 backend 进程共同读写的一块内存,缓存磁盘上的 8KB 数据页。页面按 clock-sweep 算法淘汰,命中率是衡量它工作好坏的核心指标。理解"读写都发生在缓冲区、磁盘只是兜底",是理解后面 MVCC、脏页刷写、检查点全部机制的地基。
一次读页的完整路径
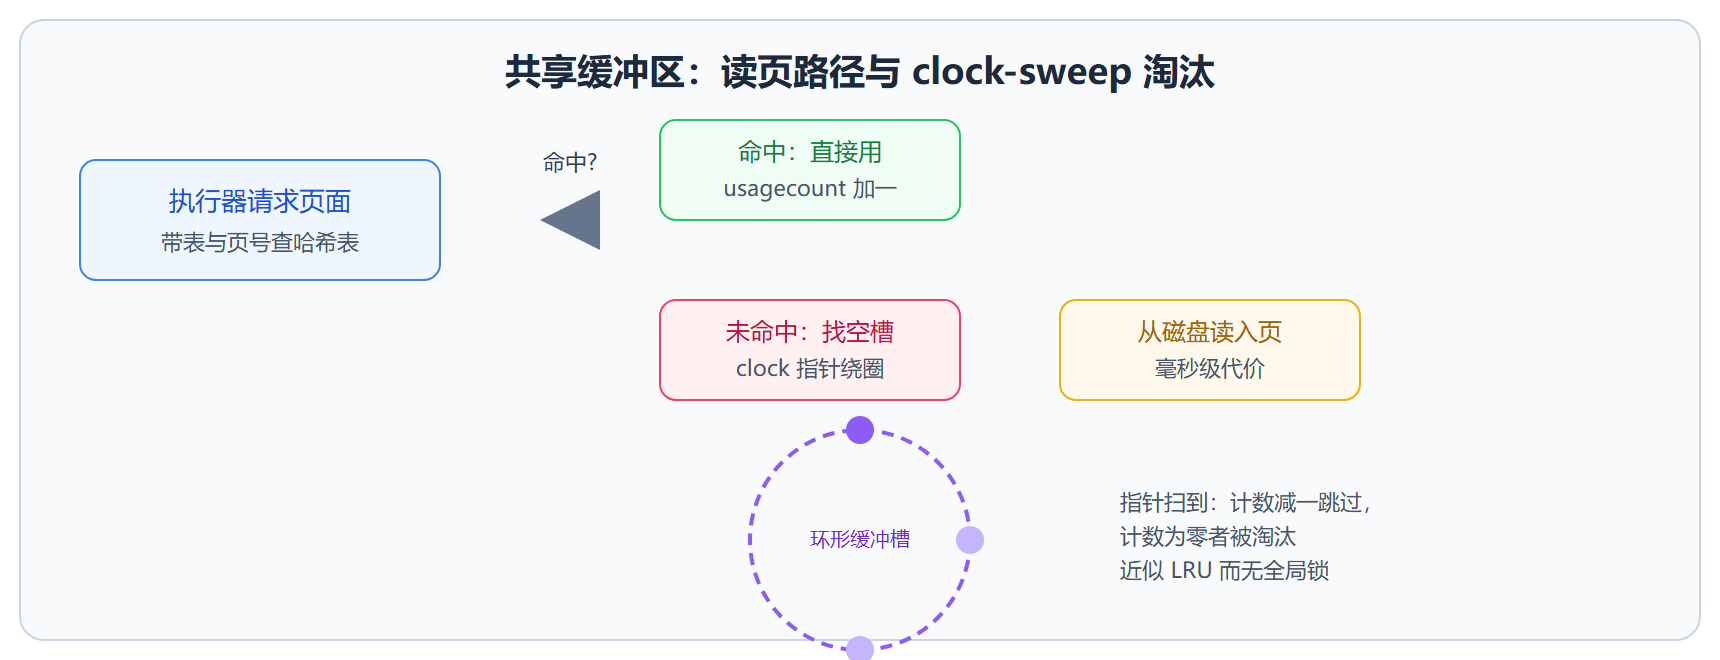
执行器需要某个表的数据时,并不是直接读磁盘:
-- 查看当前缓冲区状态 SELECT count(*) AS total, count(*) FILTER (WHERE usagecount > 2) AS hot FROM pg_buffercache;
页面请求的路径只有两条:
- 命中:页面已在缓冲区,直接返回,纳秒级
- 未命中:从磁盘读入一个空闲或被淘汰的缓冲槽,毫秒级——差两到三个数量级
所有 backend 修改数据也只改缓冲区里的页面副本,改完的页叫脏页,由 background writer 与检查点机制择机刷回磁盘(第 3 章展开)。也就是说,"写磁盘"永远不是用户会话亲自做的事。
clock-sweep:环形指针的淘汰智慧
缓冲区不像教科书式的 LRU 那样维护全局链表——那需要频繁加锁,多进程下会打起来。PostgreSQL 的做法:
- 所有缓冲槽排成一个环,一个指针绕圈扫描
- 每个槽有 usagecount(0 到 5),被访问一次加一,封顶 5
- 指针扫到一个槽:usagecount 大于 0 就减一并跳过,等于 0 就淘汰它装新页
效果等价于近似 LRU,但只需要对单个槽做原子操作。热门页面因为计数不断被补充,指针赶不走它;冷页面绕一两圈就归零让位。
图:缓冲区读页与淘汰流程
用数字说话:命中率
SELECT round(100.0 * sums.blks_hit / nullif(sums.blks_hit + sums.blks_read, 0), 2) AS cache_hit_ratio FROM (SELECT sum(blks_hit) AS blks_hit, sum(blks_read) AS blks_read FROM pg_stat_database) sums;
cache_hit_ratio ----------------- 99.87
经验参考线:
- 99% 以上:缓冲区工作良好,多数读在内存完成
- 95% 以下:工作集大于缓冲区,先考虑加大 shared_buffers,再考虑索引是否缺位
- 忽高忽低:可能有大批量顺序扫描在"冲刷"缓存,看看 pg_statio_user_tables 里哪张表的读量异常
⚠️ 常见坑:shared_buffers 不是越大越好。超过物理内存的四分之一左右,脏页管理与新页淘汰的开销反而上升,操作系统页缓存与数据库缓冲区之间的分工也会失衡。
动手实验:看一个表占了多少缓冲区
pg_buffercache 扩展把整个缓冲区数组变成一张可查询的表,配合它可以直接验证"访问会留驻"这件事:
CREATE EXTENSION IF NOT EXISTS pg_buffercache; -- 实验前先记下 customer 表占用的缓冲槽数 SELECT count(*) FROM pg_buffercache WHERE relfilenode = (SELECT relfilenode FROM pg_class WHERE relname = 'customer');
count ------- 12
-- 全表扫一遍再数:五万行约三百多个页面被读入缓冲区 SELECT count(*) FROM customer; SELECT count(*) FROM pg_buffercache WHERE relfilenode = (SELECT relfilenode FROM pg_class WHERE relname = 'customer');
count ------- 354
-- 再看这些页面的热度分布:usagecount 越高越难被淘汰 SELECT usagecount, count(*) FROM pg_buffercache WHERE relfilenode = (SELECT relfilenode FROM pg_class WHERE relname = 'customer') GROUP BY usagecount ORDER BY usagecount;
刚扫完时多数页面 usagecount 为一到二——clock 指针转一圈它们就会让位给别的表。若几天后再查,只剩高计数的老页面还在,这就是淘汰算法在"自然降温"。把同样的实验跑在一张反复被点查的热表上,会看到计数整体上移;这正是业务热集与算法互动的形状。
双层缓存:缓冲区不是唯一的内存
一个常见误判:把 shared_buffers 调大后命中率没变化,就断定"内存没用上"。实际上读路径有两层缓存——数据库自己的共享缓冲区,和操作系统为数据文件维护的页缓存。缓冲区未命中时,先问操作系统页缓存要,仍没有才真正发磁盘读。pg_stat_database 的 blks_read 统计的是后一种"两层都未命中"。
这带来两个实践推论。其一,shared_buffers 之外的那部分内存并没有浪费,它以页缓存的形式继续为数据库服务,这就是"总内存的四分之一给数据库、其余留给系统"这条经验法则的机制来源。其二,做"冷读"基准测试时必须同时考虑两层缓存,否则第二次跑出的快是页缓存的功劳,与索引优化无关。
排错案例:命中率漂亮,查询依然慢
一套报表库命中率长期 99.9%,但晚高峰报表总要十几秒。巡检发现真正的病灶不在缓冲区:pg_stat_statements 里最贵的语句全是宽表聚合,单条语句处理行数巨大——数据都在内存里,CPU 处理不过来。命中率衡量"取数快不快",不衡量"要做的事多不多"。
处置分两步:先给两张大表的过滤列补索引,让聚合前的扫描行数从百万级降到万级;再对一条确实要扫全表的汇总语句启用并行查询(第 5 章第 3 节)。两周后同报表稳定在三秒内,命中率纹丝没动——因为它从来不是瓶颈。这个案例的教训:指标正常只排除一种病因,定位永远要从最贵的语句出发,而不是从最显眼的指标出发。
本节要点回顾
- 读写都在缓冲区:磁盘只是缓存的兜底,脏页由后台进程刷写
- clock-sweep:环形指针加访问计数,近似 LRU 且免全局锁
- 命中率是第一指标:低于 95% 就值得深挖
- shared_buffers 有甜点区:通常在物理内存的 15%–25%