2.4 VACUUM:死元组的清道夫
2.4 VACUUM:死元组的清道夫
本节摘要:MVCC 留下的死元组需要 VACUUM 回收。常规 VACUUM 扫描表、把死元组空间标回"空闲空间表"供复用,不动活数据、不锁表;VACUUM FULL 则重写整表、真正归还磁盘空间但要排他锁。autovacuum 后台进程按死元组阈值自动触发,是生产库的健康底线。
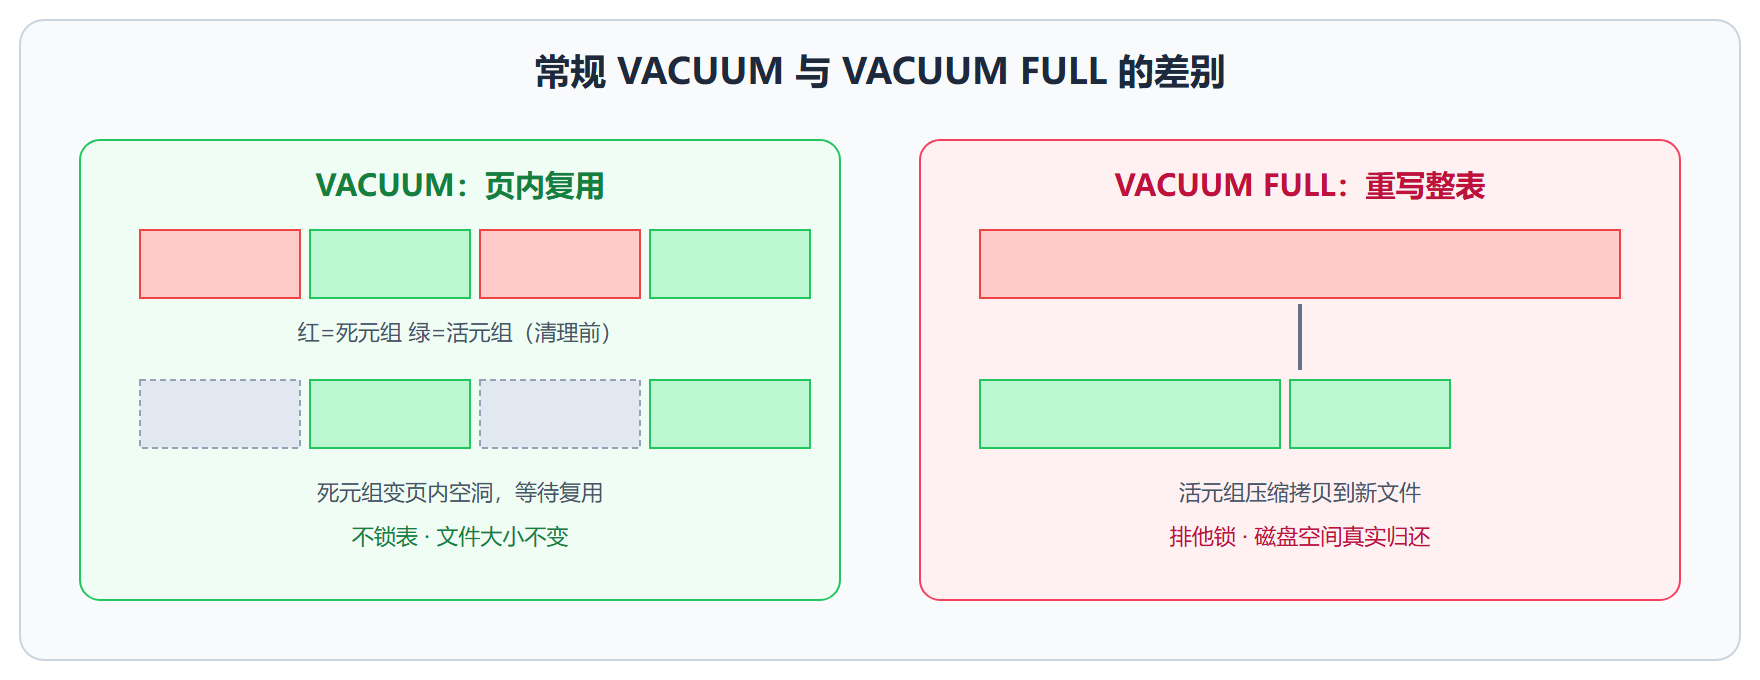
两级清理:复用与归还
| VACUUM | VACUUM FULL | |
|---|---|---|
| 空间去向 | 页内与文件内复用,不还给操作系统 | 重写整表,真正归还磁盘 |
| 锁级别 | 与读写并存 | 排他锁,全表不可用 |
| 耗时 | 增量,可中断 | 与表大小成正比,常以小时计 |
| 日常定位 | autovacuum 自动跑 | 膨胀后的急救手段 |
-- 手动触发一次常规清理并看统计 VACUUM (VERBOSE, ANALYZE) customer;
常规 VACUUM 的工作流:扫描可见性映射找到候选页——回收死元组空间到页内空闲区——整理页内指针——必要时截断文件尾部的空页。它还会顺带冻结足够老的元组(2.5 节)并更新统计信息(ANALYZE 语义)。
autovacuum 的触发算法
后台 autovacuum 不定时跑,而是按两张阈值表决定每张表何时清理:
触发阈值 = autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor × 活元组数 默认 = 50 + 0.2 × n_live_tup
一张一千万行的表,要积累约两百万死元组才会被自动清理——对更新频繁的 OLTP 表来说太迟钝了。大表应该按表覆盖系数:
-- 只对热点大表收紧阈值 ALTER TABLE customer SET (autovacuum_vacuum_scale_factor = 0.02); ALTER TABLE events SET (autovacuum_vacuum_scale_factor = 0.01, autovacuum_vacuum_threshold = 1000);
图:VACUUM 两级清理对比
观测清理健康度
SELECT relname, n_dead_tup, n_live_tup, last_autovacuum, autovacuum_count FROM pg_stat_user_tables ORDER BY n_dead_tup DESC LIMIT 5;
两个信号值得警惕:
- n_dead_tup 持续高位且 last_autovacuum 很旧:autovacuum 追不上写入速度,或被长事务卡住(回看 2.3 节)
- n_dead_tup 接近 n_live_tup:表已膨胀一倍以上,先查原因再决定是否 VACUUM FULL,否则清完很快再膨
⚠️ 常见坑:看到膨胀就无脑 VACUUM FULL,几百 GB 的表锁几小时。多数场景下,解决长事务、收紧阈值、让 autovacuum 追上来,配合 pg_repack 这类在线重排工具,比停机收缩划算得多。
VERBOSE 输出逐行解读
手动跑一次带 VERBOSE 的清理,它的自述比任何文档都直白:
VACUUM (VERBOSE) customer;
INFO: vacuuming "public.customer": 431 pages to be vacuumed INFO: scanned 431 pages, 312 removable, 50003 remaining INFO: table "customer": found 312 removable, 50003 nonremovable row versions 0 dead but not yet removable, 0 uses to be "frozen" INFO: avg read rate: 42.1 MB/s, avg write rate: 38.6 MB/s
最值得盯的是 nonremovable 里拆出的两行:dead but not yet removable 表示"确认死了但有快照还可能看它"——这个数非零且持续增大,几乎可以断言存在旧快照(长事务、废弃复制槽、悬空预备事务三者之一);uses to be frozen 是本次顺带冻结的数量,正常情况下很小。removable 与 nonremovable 的比例就是清理效率的直接读数。
进度也是可观测的,大表清理时不必干等:
SELECT phase, heap_blks_total, heap_blks_scanned, round(100.0 * heap_blks_scanned / nullif(heap_blks_total, 0), 1) AS pct FROM pg_stat_progress_vacuum;
phase 列会走过 scanning heap、vacuuming indexes、cleaning up indexes 等阶段,索引阶段耗时与索引数量成正比——这解释了为什么"表不大索引多"的库清理反而慢。
可见性映射:清理留下的加速器
常规 VACUUM 的副产品常被低估:它维护每个页的可见性映射(VM),一位标记"此页全部元组对所有人可见"。这个位图有两个大用处。其一,索引扫描可以跳过死元组检查,加速常规查询。其二,它是 index-only scan 的前提——如果叶层索引条目指向的页面在 VM 里全可见,只查索引就能返回结果,完全不必回堆表取页:
-- index-only scan 是否生效,看 EXPLAIN 的 Heap Fetches 数字 EXPLAIN (ANALYZE, BUFFERS) SELECT count(id) FROM customer WHERE id BETWEEN 100 AND 200;
Index Only Scan using customer_pkey on customer Heap Fetches: 0
Heap Fetches 为零是理想状态;表频繁更新后可见位失效,Heap Fetches 上涨,index-only scan 名存实亡——清理及时与否,直接写在查询计划里。这也是"更新密集表要收紧 autovacuum 阈值"的又一层理由:不只为了回收空间,还为了保住这条只读加速路径。
排错案例:autovacuum 的三个冤案
冤案一:表明明膨胀了,日志里却查不到该表的清理记录。多数时候不是没跑,而是每次只清理了部分(autovacuum 有成本预算,跑满预算就收工下次再来),pg_stat_user_tables 的 autovacuum_count 在涨,只是追不上写入。看 last_autovacuum 与 n_dead_tup 的组合即可证实。
冤案二:清理一直在跑,死元组数不降。几乎必然是旧快照卡住:用 pg_stat_activity 查xmin 找长事务,用 pg_replication_slots 查未推进的槽位,用 pg_prepared_xacts 查两阶段遗留的预备事务。三查齐全,凶手现形。
冤案三:清理把 IO 打满影响业务。每表可以限速:autovacuum_vacuum_cost_delay 给热点表的清理降速,代价是清得慢一点——在"清理慢"与"业务抖"之间,通常选前者,并靠更低的触发阈值让慢速清理高频小跑,代替低频大跑。
本节要点回顾
- 两级清理:常规 VACUUM 空间复用不锁表,VACUUM FULL 归还空间但排他
- 阈值公式:固定阈值加比例因子,大表务必按表调低比例
- 清理被卡三因:长事务、复制槽未推进、失效的槽位
- 膨胀先找根因:收缩是急救,不是养生