2.5 事务 ID 回卷与冻结:二十亿个事务的宿命
2.5 事务 ID 回卷与冻结:二十亿个事务的宿命
本节摘要:事务 ID 是 32 位无符号整数,最多约四十二亿个,且以"模运算比较先后"的方式使用——绕一圈后新旧关系会颠倒,这就是回卷灾难。解药是冻结:把足够老的元组打上特殊标记,从此不再依赖事务号比较。autovacuum 的防回卷清理是数据库的生死线,逼停它比慢查询严重得多。
32 位的事务号怎么比新旧
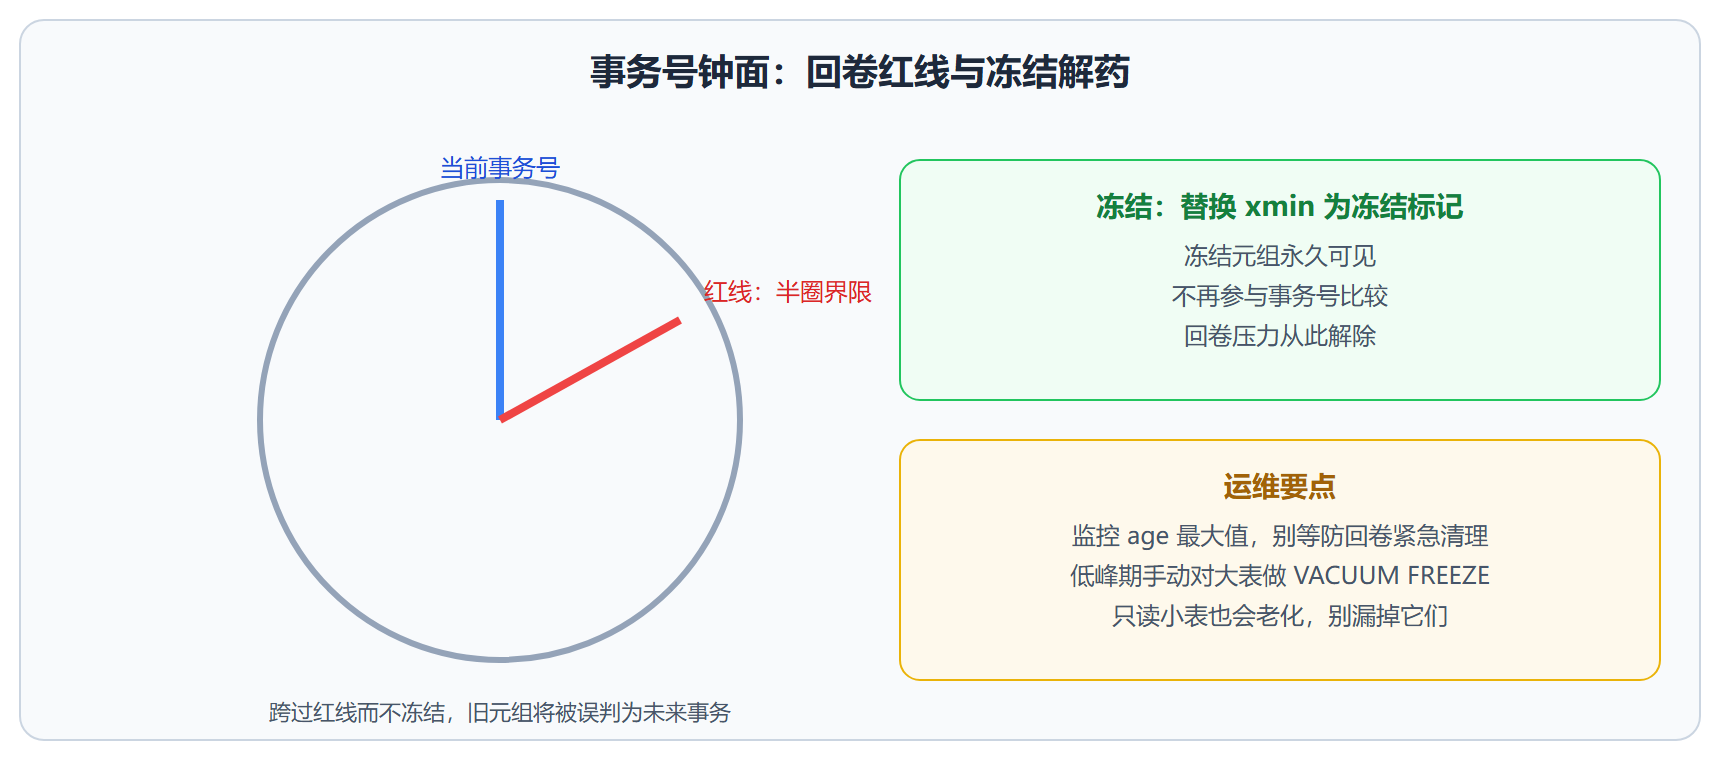
xmin、xmax 都是 32 位整数,但判断"谁先谁后"用的是模 2 的 32 次方语义:对任意两个事务号,位于它"逆时针半圈"以内的算更早。好比一个只有二十亿个刻度的钟面,转过一半刻度之后,先后关系开始反直觉。
极端情形:一张只写不删的老表,它的元组 xmin 停留在很久以前的事务号;当全库事务号绕行接近一圈、即将追上这些老 xmin 时,按模比较它们会被误判为"未来的事务",元组凭空不可见——数据像被集体删除。所以 PostgreSQL 的策略是:宁死不卷。
冻结:给老元组发免死金牌
在灾难到来之前,autovacuum 会对足够老(默认五千万元组量级)的表发起防回卷清理:把比某个界限更早、肯定已提交的元组的 xmin 替换成特殊的冻结标记。冻结元组永远可见,不再参与事务号比较,回卷危机解除。
代价是清理本身要扫描全表。最坏的情况下(大量几乎不动、又一直没被普通清理扫到的表),数据库会进入"防回卷紧急模式":
- 拒绝新事务?不会,但会疯狂打日志告警
- autovacuum 强制启动清理进程,即使你把它整体关掉,防回卷清理也会照样跑
- 高写入时刻撞上全表扫描清理,IO 双重挤压
-- 观察每张表距离回卷保护还有多远 SELECT relname, age(relfrozenxid) AS xid_age, 2^31 - age(relfrozenxid) AS headroom FROM pg_class WHERE relkind = 'r' ORDER BY xid_age DESC LIMIT 5;
relname | xid_age | headroom -----------+------------+----------- events | 1820000001 | 294967295 customer | 1500000002 | 619967294
events 距离回卷红线只剩约三亿个事务——写入量大的库可能几天就走完,此时防回卷清理一定会不请自来。
图:事务号钟面与冻结机制
为什么只读表也要清理
冻结界限按"每张表自己的最老 xmin"计算,与该表是否被写入无关。一张两年没人动的配置表,它的 relfrozenxid 一直停在两年前,age 照样随全库事务消耗增长。所谓"我只查不写,凭什么扫我的表",答案就在这里——它占着的老事务号必须被释放。
💡 关键直觉:把 age 当成水位线指标接进监控,报警线设在十亿以下;每周低峰对 age 偏高的表主动冻结,防回卷就永远轮不到"紧急"二字。
动手算一次回卷距离
回卷风险完全可以量化。全库的"事务号水位"取所有表里最老的 relfrozenxid 的 age,直接查:
-- 全库水位与最老的几张表 SELECT datname, datfrozenxid, age(datfrozenxid) AS db_age FROM pg_database WHERE datname = current_database();
datname | datfrozenxid | db_age -----------+--------------+----------- postgres | 1031 | 1042
实验库里 age 只有千级,毫无压力;生产高写入库以亿计很常见。红线在二十一亿附近——防回卷清理会在 age 抵达约二十亿时被强制触发(autovacuum_freeze_max_age,默认两亿起就有计划性冻结),留给你的缓冲从两亿到二十亿不等。把这张查询接进监控,按十亿设告警线,剩下的就是节奏问题。
计划性冻结也能手动做,且可以挑低峰:
-- 只冻结足够老的元组,按当前设定的冻结年龄门槛 VACUUM (FREEZE) events; -- 更激进:把门槛临时降为零,冻结表内全部元组 VACUUM (FREEZE, VERBOSE) events; -- 配合 SET vacuum_freeze_min_age = 0;
冻结完再看该表的 relfrozenxid,age 归零、水位解除——这就是"每周给高龄表续命"的标准动作。
辨析:两种"事务号不够用"
回卷灾难常和另一个话题混淆:事务号消耗速度。前者是"绕圈后新旧颠倒"的正确性问题,靠冻结解决;后者是"号发得太快、防回卷清理太频繁"的容量问题,靠减少事务数解决。两者常被统称为"事务号危机",但药方完全不同。
降低消耗的实战手段有三条。批量提交:把一百次单行更新合成一次事务,事务号消耗从一百降到一(代价是失败重做的粒度变大)。只读连接少用显式 BEGIN:纯 SELECT 事务不分配真事务号,但长开的 BEGIN 会让人误以为它占了号——真正的元凶是其中的写。清理遗留预备事务与废弃复制槽:它们各自钉住一个老事务号,把多张表的 age 一起顶高。第三条最隐蔽也最常见,巡检时值得优先排查。
一场真实的回卷惊魂
某支付库凌晨突告警:autovacuum 启动了十几个防回卷 worker,业务写入延迟翻倍。排查发现一张两年没人动过的归档表 age 高达十九亿——它不产生任何新事务,却把全库水位顶到红线。处理分三步:先对它执行手动 FREEZE(表是冷表,十分钟完成);再把这张以及同类冷表纳入每周冻结清单;最后在监控里把"按表 age 排序前十"做成固定面板,让最老的表始终可见。
事后复盘的关键认知:回卷风险的分配极不均匀——热表因为频繁被普通清理顺带冻结,age 反而低;冷表无人问津,age 一路裸奔。防回卷策略的要义不是全库统一动作,而是找出那几张"又老又没人动"的表点名照顾。
冻结的实现细节:提示位的改写
冻结并不是把 xmin 换成一个魔法数字那么简单。实现上它复用了元组头的提示位:设置"已冻结"标记后,这个元组的 xmin 从此不再参与任何可见性比较,读路径遇到它直接按"永远可见"处理。改写提示位本身也有讲究——只改标记不动数据字段的操作,允许用一种精简的 WAL 记录甚至无日志方式完成(取决于版本与场景),这让大规模冻结的日志开销远低于一次普通更新。
由此还能理解一个排障细节:某些工具报告的"xmin 等于 2 的事务",那个特殊的 2 就是老版本冻结标记的残留形态——不是真的有编号为 2 的远古事务,而是冻结语义的历史编码。看到它应当安心,说明该表被冻结机制正常覆盖过。
本节要点回顾
- 32 位模比较:转过半圈,先后关系颠倒,这就是回卷灾难的原理
- 冻结免死:老元组改打冻结标记,与事务号脱钩
- 防回卷清理不可禁:关掉 autovacuum 也拦不住它强制启动
- age 是水位线:所有表(含只读表)都要看,提前主动冻结