4.1 聚合函数与 COUNT 的三种数法
4.1 聚合函数与 COUNT 的三种数法
本节摘要:聚合函数把多行折叠成一个数——COUNT 数行数、SUM 求和、AVG 求均值、MIN/MAX 找边界。所有聚合函数遇到 NULL 都选择跳过(COUNT(*) 除外),这一条规则解释了 COUNT 的三种数法差异、AVG 分母的意外,也是报表数字对不上的头号原因。本节把折叠机制、NULL 规则与 DISTINCT 的位置一次讲清。
一、数一数的三种答案
先做一个小实验,问题朴素得不像会有分歧:"books 表里有多少行?"
-- 三种 COUNT,三个答案 SELECT COUNT(*) AS 数所有行, COUNT(price) AS 数价格非空, COUNT(published_at) AS 数出版日期非空 FROM books;
+-----------+--------------------+--------------------------+ | 数所有行 | 数价格非空 | 数出版日期非空 | +-----------+--------------------+--------------------------+ | 6 | 6 | 5 | +-----------+--------------------+--------------------------+
COUNT(*) 数的是行本身,六行就是六;COUNT(列) 数的是这一列非空的行,published_at 有一行是 NULL(《深入理解计算机系统》待定出版),所以只有五行被数进去。加上第三种 COUNT(DISTINCT category_id),数的是"去重后的非空值个数"。三种数法对应三种问题:
| 写法 | 数的是什么 | 典型问题 |
|---|---|---|
| COUNT(*) | 行数,NULL 照数 | 表里有多少条记录 |
| COUNT(列) | 该列非空的行数 | 多少本书定了出版日期 |
| COUNT(DISTINCT 列) | 该列非空且去重后的个数 | 多少个不同的分类被引用 |
把"活跃用户数"写成 COUNT(last_login_time),得到的其实是"登录过的用户数"——从没登录过的用户在这一列是 NULL,被悄悄跳过。数字没错,口径错了;报表之争多数是口径之争。
折叠:聚合函数的世界观
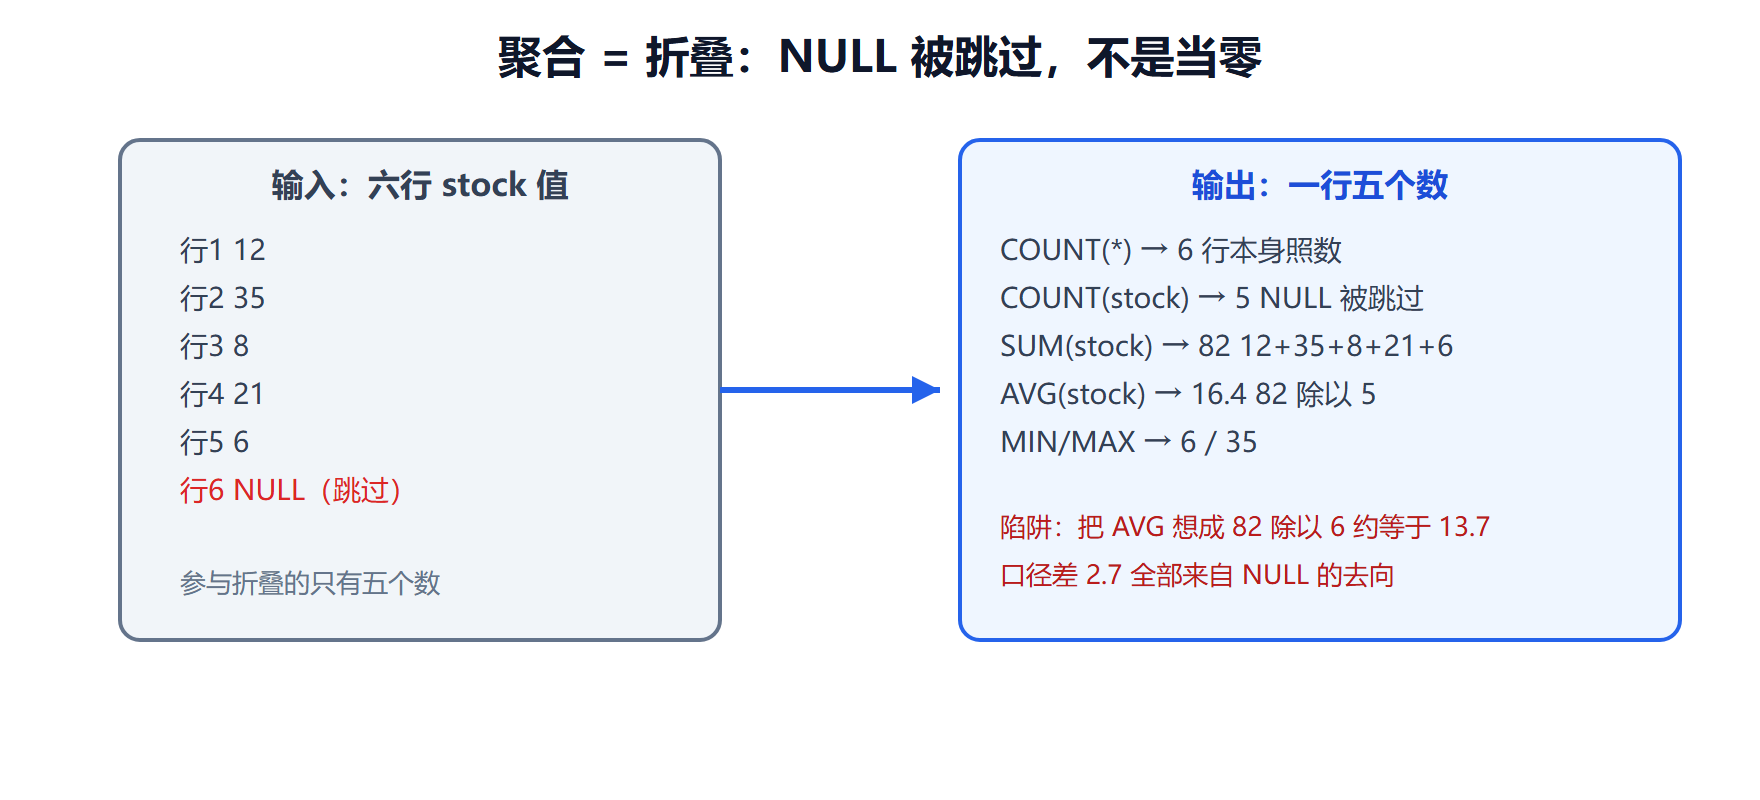
SELECT price FROM books 返回六行;SELECT SUM(price) FROM books 返回一行。聚合的本质是折叠:输入一组行,输出一个数。五员大将的分工:
- COUNT 数个数;SUM 求总和;AVG 求均值;MIN、MAX 找最小最大。
- 全员(COUNT(*) 除外)忽略 NULL:SUM 里 NULL 不当零,是压根不参与。
- 折叠后没有"行的概念":SUM 旁边若直接放列名 price,数据库不知道你要哪一行的 price——这正是下一节 SELECT 列限制的由来。
AVG 的分母最容易被想当然。演示数据里某列有六个值其中一个为 NULL:
-- AVG 的分母是"非空个数"而不是"总行数" SELECT AVG(published_year) AS 平均年份_跳过NULL, SUM(published_year) / COUNT(*) AS 错误算法_除以总行数, SUM(published_year) / COUNT(published_year) AS 手工还原AVG FROM books;
+----------------------+----------------------+----------------------+ | 平均年份_跳过NULL | 错误算法_除以总行数 | 手工还原AVG | +----------------------+----------------------+----------------------+ | 2015.6000 | 2013.0000 | 2015.6000 | +----------------------+----------------------+----------------------+
AVG(列) 严格等价于 SUM(列) 除以 COUNT(列)——分母只数参与运算的非空行。想要"NULL 当零参与平均"的口径,得显式写 SUM(COALESCE(列,0)) / COUNT(*)。口径没有对错,但必须与你嘴上说的业务定义一致,这就是为什么数据团队开会常为一行 SQL 争半小时。
图 4-1 聚合折叠:六行进,一个数出
无 GROUP BY 的聚合:全表就是一组
不带 GROUP BY 的聚合查询,把整张表当成一组折叠,永远返回一行(哪怕表是空的,COUNT 返回 0,其余函数返回 NULL)。这个特性常被用来回答"全店级"问题:
-- 全店体检:一次拿五个核心指标 SELECT COUNT(*) AS 在售品种, ROUND(AVG(price), 2) AS 平均定价, MIN(price) AS 最低价, MAX(price) AS 最高价, SUM(price * stock) AS 库存总价值 FROM books;
+--------------+--------------+-----------+-----------+--------------+ | 在售品种 | 平均定价 | 最低价 | 最高价 | 库存总价值 | +--------------+--------------+-----------+-----------+--------------+ | 6 | 72.67 | 39.00 | 128.00 | 4998.00 | +--------------+--------------+-----------+-----------+--------------+
注意两点。第一,聚合函数的参数可以是表达式:SUM(price * stock) 先按行算乘积再求和,这正是第 3 章列表达式与聚合的衔接点。第二,聚合与聚合可以嵌套吗——AVG(SUM(price)) 不行,聚合函数不能直接嵌聚合函数;想要"各分类总销售额的平均值"得先 GROUP BY 算出每组 SUM,再套一层查询取平均,这个"查询套查询"的需求就是第 6 章子查询、第 8 章 CTE 的直接动机之一。
DISTINCT 的两个落点
DISTINCT 关键字可以站在聚合函数里面或 SELECT 后面,含义不同:
-- 落点一:聚合函数内 —— 去重后计数 SELECT COUNT(DISTINCT category_id) AS 涉及分类数 FROM books; -- 输出:涉及分类数 = 3(六个品种只覆盖三个分类) -- 落点二:SELECT 后 —— 整行去重 SELECT DISTINCT category_id, price_band_dummy FROM books;
落点一输出:涉及分类数为 3 落点二(把 price_band_dummy 换成 CASE 档位列后):按 分类加档位 组合去重
第二个查询里的占位列请替换成第 3 章的 CASE 档位表达式——DISTINCT 作用于选择列表整体的组合,(category_id, price_band) 相同的行只留一条。日常口径"有多少个分类在售、各档位分布"就是这两个落点的组合拳。顺带一个性能事实:DISTINCT 需要去重排序,大表上代价不菲,第 7 章会给出用窗口函数去重的替代方案,两种写法的结果集语义完全一致、执行代价各有千秋。
⚠️ 常见坑:在 WHERE 里写聚合条件,例如 WHERE COUNT(*) > 3。WHERE 逐行判断,行还没聚成组,聚合无从谈起,数据库直接报错"聚合函数不允许出现在 WHERE"。组级筛选是 HAVING 的领地,下一节展开。
💡 关键直觉:聚合前先问两句话——"折叠的单位是什么"(全表还是某几组,由 GROUP BY 决定)、"NULL 去哪了"(跳过,除非 COUNT(*))。两句话答完,数字就能对上口径。
本节要点回顾
- COUNT 三种数法:COUNT(*) 数行、COUNT(列) 数非空、COUNT(DISTINCT 列) 数去重非空,口径不同答案不同;
- 聚合全员跳过 NULL:NULL 不当零、不参与,AVG 的分母是 COUNT(列) 而非 COUNT(*);
- 无 GROUP BY 即全表一组:聚合查询必返回一行,空表时 COUNT 得 0、其余得 NULL;
- 聚合参数可以是表达式:SUM(price * stock) 先行内计算再折叠,与第 3 章无缝衔接;
- 聚合不能嵌聚合:需要"聚合的聚合"时,先分组再套一层查询——第 6、8 章的伏笔;
- DISTINCT 两个落点语义不同:函数内是去重计数,SELECT 后是整行组合去重。
折叠的单位不该总是"全表"。下一节引入 GROUP BY:按分类折、按城市折、按月折——组的概念正式登场,HAVING 也随之就位。