4.2 GROUP BY 划定组界,HAVING 筛组
4.2 GROUP BY 划定组界,HAVING 筛组
本节摘要:GROUP BY 把表按指定列切成若干组,每组折叠成一行;SELECT 列表从此只允许"分组列 + 聚合表达式",违反即报错——这不是刁难,而是每组一个输出行的必然推论。HAVING 作用于组级结果,与 WHERE 的分工是"WHERE 筛行在前、HAVING 筛组在后"。本节把分组机制、列限制报错与完整流水线讲透。
当 WHERE 管不了分组之后
需求三连:"每个分类有几本书?哪些分类平均价高于 70?这些分类里再排除 2020 年后出版的书重算一遍。"第一问 GROUP BY 直接回答:
-- 按分类分组:每个分类折叠成一行 SELECT category_id, COUNT(*) AS 书目数, ROUND(AVG(price), 2) AS 平均价 FROM books GROUP BY category_id;
+-------------+-----------+-----------+ | category_id | 书目数 | 平均价 | +-------------+-----------+-----------+ | 2 | 2 | 70.50 | | 3 | 3 | 82.33 | | 5 | 1 | 39.00 | +-------------+-----------+-----------+ 3 rows in set (0.01 sec)
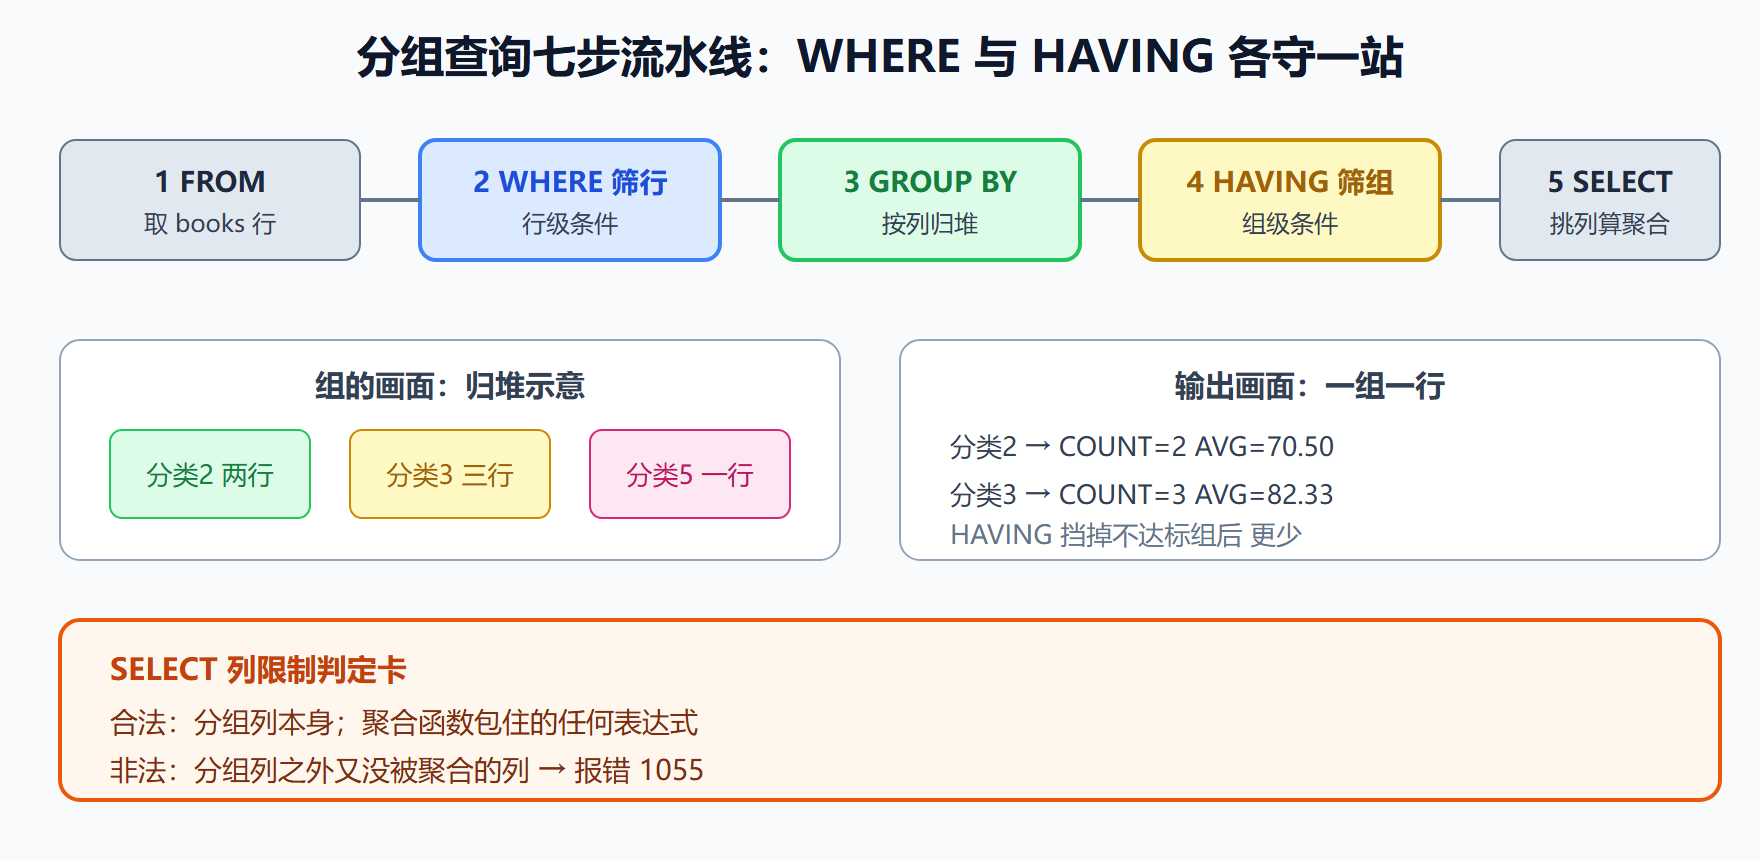
理解输出的关键一句:一行代表一个组,不再是代表一本书。三行输出对应三个分类,COUNT 与 AVG 各自只"看见"自己组里的行。GROUP BY 的执行画面是"先按 category_id 把相同值的行归拢成一堆,再对每堆分别折叠"。
第二问要"平均价高于 70 的分类",有人顺手把条件塞进 WHERE:
-- 反例:WHERE 里写聚合条件 SELECT category_id, AVG(price) FROM books WHERE AVG(price) > 70 GROUP BY category_id;
ERROR 1111 (HY000): Invalid use of group function
报错的道理在执行顺序里:WHERE 逐行判断时,行还没归堆,"平均价"这个概念尚不存在——组还没出生,谈何筛选组。组级条件的正确落点是 HAVING:
-- 正解:HAVING 作用于分组之后 SELECT category_id, COUNT(*) AS 书目数, ROUND(AVG(price), 2) AS 平均价 FROM books GROUP BY category_id HAVING AVG(price) > 70;
+-------------+-----------+-----------+ | category_id | 书目数 | 平均价 | +-------------+-----------+-----------+ | 3 | 3 | 82.33 | +-------------+-----------+-----------+
WHERE 与 HAVING 的分工由此立住:WHERE 筛行,HAVING 筛组;一个在分组前,一个在分组后。同一个条件写在哪一侧,语义完全不同——写 WHERE 是"先把 2020 年前的书挑出来再分组",写 HAVING(若条件涉及聚合)是"先分组再看组的指标"。第三问正是两种语义并存的实例:
-- WHERE 与 HAVING 同框:行级条件在前 组级条件在后 SELECT category_id, COUNT(*) AS 书目数, ROUND(AVG(price), 2) AS 平均价 FROM books WHERE published_at < '2020-01-01' -- 行级:先排除 2020 年及以后出版的书 GROUP BY category_id HAVING COUNT(*) >= 2; -- 组级:只要还剩两本及以上的分类
+-------------+-----------+-----------+ | category_id | 书目数 | 平均价 | +-------------+-----------+-----------+ | 3 | 2 | 82.33 | +-------------+-----------+-----------+
行级条件让每个组的"原料"变小,组级条件再把小样本组整个扔掉。顺序一换(先 HAVING 后 WHERE 的意图),统计的就是另一个问题了——口径之争的根源往往就在这一前一后。
SELECT 列限制:报错背后的必然
新手的经典报错时刻:想在分组结果里看看书名。
-- 反例:SELECT 出现分组列之外的非聚合列 SELECT category_id, title, COUNT(*) FROM books GROUP BY category_id;
ERROR 1055 (42000): Expression #2 of SELECT list is not in GROUP BY clause and contains nonaggregated column 'title' ...
道理拍在桌面上一想就通:输出一行代表一个分类,可一个分类里有好几本书,title 该显示哪一本?没有任何合理的答案,所以标准 SQL 直接禁止。MySQL 曾有 sql_mode 里的宽松模式放行此写法(随机挑一行的值显示),新版默认关闭——宽松模式下的"能跑"是最大的坑,结果不可复现。
合法列的判定规则一句话:SELECT 里出现的每一列,要么出现在 GROUP BY 里,要么被聚合函数包住。想"每组随便看一本代表作",标准做法是第 7 章的窗口函数或"每组取极值"的关联子查询,第 6 章会给雏形。多列分组的"组"定义同理扩展:GROUP BY category_id, price_band 是按两列的组合值分组,(2, '低价') 与 (2, '中价') 是两个不同的组。
图 4-2 从行到组的完整流水线
两个高频实战变式
变式一:按表达式分组。 分组的依据不必是原始列,日期按月归堆是报表刚需:
-- 按年月统计出版书目数:表达式也能当分组键 SELECT DATE_FORMAT(published_at, '%Y-%m') AS 出版月份, COUNT(*) AS 书目数 FROM books WHERE published_at IS NOT NULL -- NULL 没有月份 先在行级排掉 GROUP BY DATE_FORMAT(published_at, '%Y-%m') ORDER BY 出版月份;
+--------------+-----------+ | 出版月份 | 书目数 | +--------------+-----------+ | 2012-01 | 1 | | 2014-08 | 1 | | 2019-03 | 1 | | 2020-06 | 1 | +--------------+-----------+
GROUP BY 与 SELECT 里的表达式必须逐字一致(MySQL 也接受 SELECT 里的别名,标准 SQL 不接受,写一致最稳)。NULL 组的去向值得专门记一笔:GROUP BY 会把 NULL 也当成一个组——"出版日期待定"的书会挤在一组,报表里出现一个空标签的行,别当成 bug。
变式二:条件聚合打交叉表雏形。 第 3 章的 CASE 在分组场景火力全开,一个 GROUP BY 出多路口径:
-- 每个分类同时统计高中低价档的品种数:交叉表的雏形 SELECT category_id, SUM(CASE WHEN price >= 100 THEN 1 ELSE 0 END) AS 高价, SUM(CASE WHEN price BETWEEN 50 AND 99.99 THEN 1 ELSE 0 END) AS 中价, SUM(CASE WHEN price < 50 THEN 1 ELSE 0 END) AS 低价 FROM books GROUP BY category_id ORDER BY category_id;
+-------------+--------+--------+--------+ | category_id | 高价 | 中价 | 低价 | +-------------+--------+--------+--------+ | 2 | 0 | 2 | 0 | | 3 | 2 | 1 | 0 | | 5 | 0 | 0 | 1 | +-------------+--------+--------+--------+
行是分类、列是价格档——本来要"按分类再按档位"两层 GROUP BY 摊开的长表,被 CASE 压成了宽表。这个技巧在第 8 章 CTE 的分层统计里还会放大:先用 CTE 算中间层,再条件聚合出报表层。
⚠️ 常见坑:以为 HAVING 里的条件"看得见" WHERE 里被筛掉的行。WHERE 先执行,被它扔掉的行根本进不了组——想让某类行参与统计但单独标注,用 CASE 在聚合里分流,而不是事后补救。
💡 关键直觉:把 GROUP BY 读成"折叠的抽屉",SELECT 是抽屉标签(只能写抽屉编号和抽屉里的统计数),WHERE 决定哪些东西有资格进抽屉,HAVING 决定哪些抽屉值得拿出来展示。
本节要点回顾
- 一行一组:GROUP BY 输出的每行代表一个组,多列分组按组合值定义组,NULL 自成一个组;
- SELECT 列限制:分组列或聚合表达式,二选一之外即报错,MySQL 宽松模式是坑不是恩惠;
- WHERE 筛行在前、HAVING 筛组在后:聚合条件进 HAVING,行级条件进 WHERE,位置即语义;
- 七步流水线:FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT;
- 表达式可作分组键:日期按月归堆是刚需,GROUP BY 与 SELECT 表达式逐字一致最稳;
- 条件聚合造宽表:SUM 加 CASE 一层分组出多列口径,交叉表的雏形。
单表的世界到此全部打通:取数、加工、折叠。但书店的数据还散在七张表里。下一章走出单表——先解释当初为什么拆,再用 JOIN 把拆开的世界拼回来。