4.6 封闭世界约束校验器:Python实现
4.6 封闭世界约束校验器:Python实现
本节摘要:把封闭世界原则编码为组件清单的校验器——检查清单的完整性(两栏齐全、颗粒度合规)、依赖变量的环境在场性、方案与清单的引用一致性,并与 2.8 节的模板检查器合成完整工具链。完整代码可直接运行,附实测输出。
校验什么
2.8 节的检查器校验"操作记录"是否合规,但它有一个隐含前提:输入的组件清单本身是合法的。垃圾清单进,垃圾判定出。本节补上这块:封闭世界校验器专管清单质量。
清单的四类典型毛病,来自前三章反复出现的坑。其一,环境栏缺失(1.3 节坑二:任务统一与属性依赖无米下锅)。其二,颗粒度失当(3.1 节:主件超过 25 项是物料清单化,少于 5 项是太粗)。其三,组织视角越界(3.2 节:把"人事部"画进服务清单——客户看不见)。其四,依赖变量引用了不在场的环境资源(2.6 节坑一:变量 B 变化范围极小或根本不在场景里)。
前两类与第四类可以机器判定;第三类("客户是否看得见")机器判不了真值,但可以用启发式词表做预警——清单里出现"部门、管理、汇报、编制"等词时标记人工复核。
数据结构与规则
扩展 2.8 节的结构,给 Component 加颗粒度标记,给依赖记录补环境在场声明。
from dataclasses import dataclass, field ORG_WORDS = ("部门", "管理", "汇报", "编制", "绩效", "审批层") @dataclass class World: internal: list = field(default_factory=list) # 内部组件名 environment: list = field(default_factory=list) # 环境资源名 @dataclass class Dependency: dep_a: str # 因变量属性 dep_b: str # 自变量属性 b_source: str # 自变量来源:"internal" / "environment" b_object: str # 自变量所属对象名 def validate_world(world, deps, hard_min_i=5, hard_max_i=25, hard_max_e=15): issues, warns = [], [] # 规则一:两栏齐全 if not world.environment: issues.append("环境栏为空:任务统一与属性依赖将无资源可用") # 规则二:颗粒度区间 ni, ne = len(world.internal), len(world.environment) if ni < hard_min_i: issues.append(f"内部组件仅 {ni} 项(下限 {hard_min_i}):颗粒度过粗或清单未完成") if ni > hard_max_i: warns.append(f"内部组件 {ni} 项超上限 {hard_max_i}:疑似物料清单化,建议合并") if ne > hard_max_e: warns.append(f"环境资源 {ne} 项偏多:疑似写成场景描述,建议只留强交互对象") # 规则三:组织视角预警 for name in world.internal + world.environment: if any(w in name for w in ORG_WORDS): warns.append(f"组件 [{name}] 疑似组织视角,客户可能看不见,请人工复核") # 规则四:依赖自变量的在场性 env_set, int_set = set(world.environment), set(world.internal) for d in deps: if d.b_source == "environment" and d.b_object not in env_set: issues.append(f"依赖 [{d.dep_a} 随 {d.dep_b}]:自变量对象 [{d.b_object}] 未登记在环境栏") if d.b_source == "internal" and d.b_object not in int_set: issues.append(f"依赖 [{d.dep_a} 随 {d.dep_b}]:自变量对象 [{d.b_object}] 未登记在内部栏") return issues, warns
实测:坏清单与好清单
if __name__ == "__main__": # 坏清单:无环境栏 + 组织视角 + 依赖引用缺失 bad_world = World(internal=["运营部门", "后台系统", "审批流程", "风控管理岗", "客服管理组", "工单池"]) bad_deps = [Dependency("处理优先级", "客户耐心", "environment", "等候情绪")] i1, w1 = validate_world(bad_world, bad_deps) print("坏清单 →", "FAIL" if i1 else "PASS") for x in i1: print(" [issue]", x) for x in w1: print(" [warn ]", x) # 好清单:2.7节宠物医院推演的清单 good_world = World( internal=["诊室", "候诊区座位", "疫苗注射环节", "护士", "号码牌", "叫号屏"], environment=["猫", "狗", "主人手机", "等候时长"], ) good_deps = [Dependency("队列进度显示", "等候时长", "environment", "等候时长")] i2, w2 = validate_world(good_world, good_deps) print("好清单 →", "FAIL" if i2 else "PASS") for x in i2: print(" [issue]", x) for x in w2: print(" [warn ]", x)
运行输出:
坏清单 → FAIL [issue] 环境栏为空:任务统一与属性依赖将无资源可用 [issue] 依赖 [处理优先级 随 客户耐心]:自变量对象 [等候情绪] 未登记在环境栏 [warn ] 组件 [运营部门] 疑似组织视角,客户可能看不见,请人工复核 [warn ] 组件 [风控管理岗] 疑似组织视角,客户可能看不见,请人工复核 [warn ] 组件 [客服管理组] 疑似组织视角,客户可能看不见,请人工复核 好清单 → PASS
坏清单被抓出的三个毛病(环境栏空、依赖对象未登记、组织视角预警)与前三章人工踩坑的结论一一对应——机器复现了有经验引导者的直觉。
合成工具链
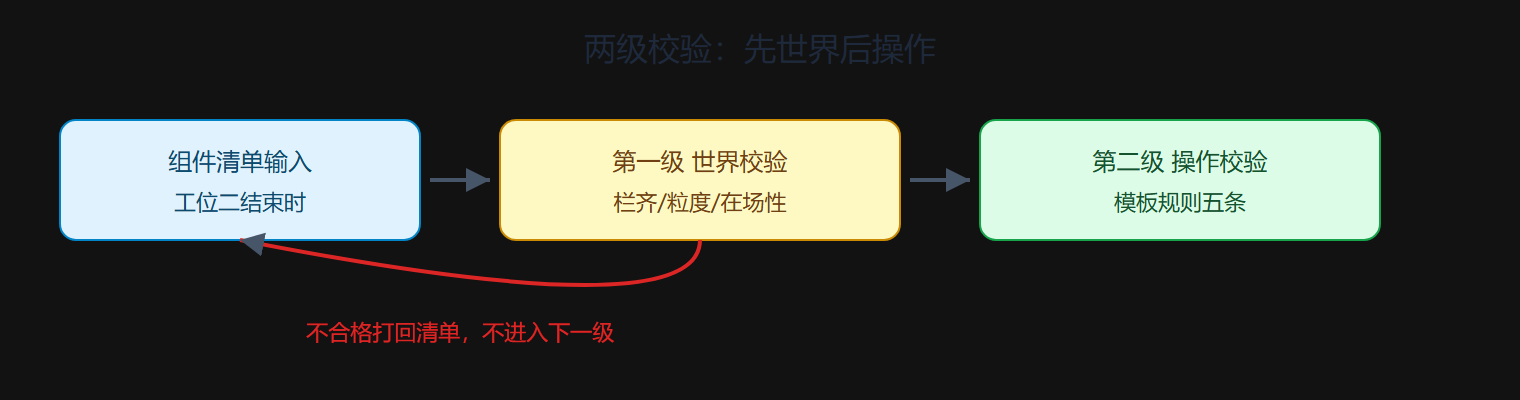
两个脚本合成时,校验顺序是关键:先 validate_world,后 check_proposal。清单不合格时直接打回,不进入操作校验——顺序反了的话,一个引用缺失的清单会让操作检查产生一串误导性报错(每个 target 都"不在封闭世界内")。
def run_pipeline(world, deps, proposal): issues, warns = validate_world(world, deps) if issues: return {"stage": "world", "issues": issues, "warns": warns} op_issues = check_proposal(proposal, [ Component(n, "internal") for n in world.internal ] + [Component(n, "environment") for n in world.environment]) return {"stage": "proposal", "issues": op_issues, "warns": warns}
(check_proposal 与 Component 沿用 2.8 节的实现。)这个两级流水线就是 3.5 节工作坊手册里"检查器预装"的完整形态:工位二结束跑第一级,工位五跑第二级。
图 4-6 两级校验流水线
边界:机器判不了什么
诚实地列出校验器的盲区。一,"客户是否看得见"的真值——词表只是预警,误报漏报都存在,复核在人。二,颗粒度的"合理"区间是经验值——特殊对象(超复杂工业品)需要调整参数。三,最重要的:它校验结构不校验价值。一个全 PASS 的方案仍然可能没人要——价值判断永远在工位四的人身上。工具链的价值是把引导者从机械裁判中解放出来,把精力全部投给机器做不了的那部分。
💡 收官建议:把两级流水线的输出接入 3.5 节工作坊的评估环节,让判定理由被现场念出来——"机器说什么"不重要,"团队听着理由学会判断"才重要。工具的终点是教学。
练习
给校验器加第五类规则:同一对象同时出现在内部栏与环境栏时的冲突检测(提示:同名对象双栏登记通常意味着边界划分错误)。用你自己业务的真实清单跑一遍两级流水线。
本节要点回顾
- 校验器职责:清单两栏齐全、颗粒度区间、组织视角预警、依赖自变量在场性;
- 四类毛病对四条规则:前三章人工踩过的坑全部被机器复现;
- 两级顺序:先世界后操作,顺序反了会产生误导性报错;
- 实测:坏清单三项问题被准确抓出,宠物医院好清单 PASS;
- 盲区诚实:可见性真值、颗粒度弹性、价值判断都在人这边;
- 工具的终点是教学:判定理由念出来,团队在听中学到判断。
全册到此收官。你的下一步:选一个真实对象,跑一遍流水线——用市场给推演打分。