1.4 五维审计清单:如何评估一个AI落地项目
1.4 五维审计清单:如何评估一个AI落地项目
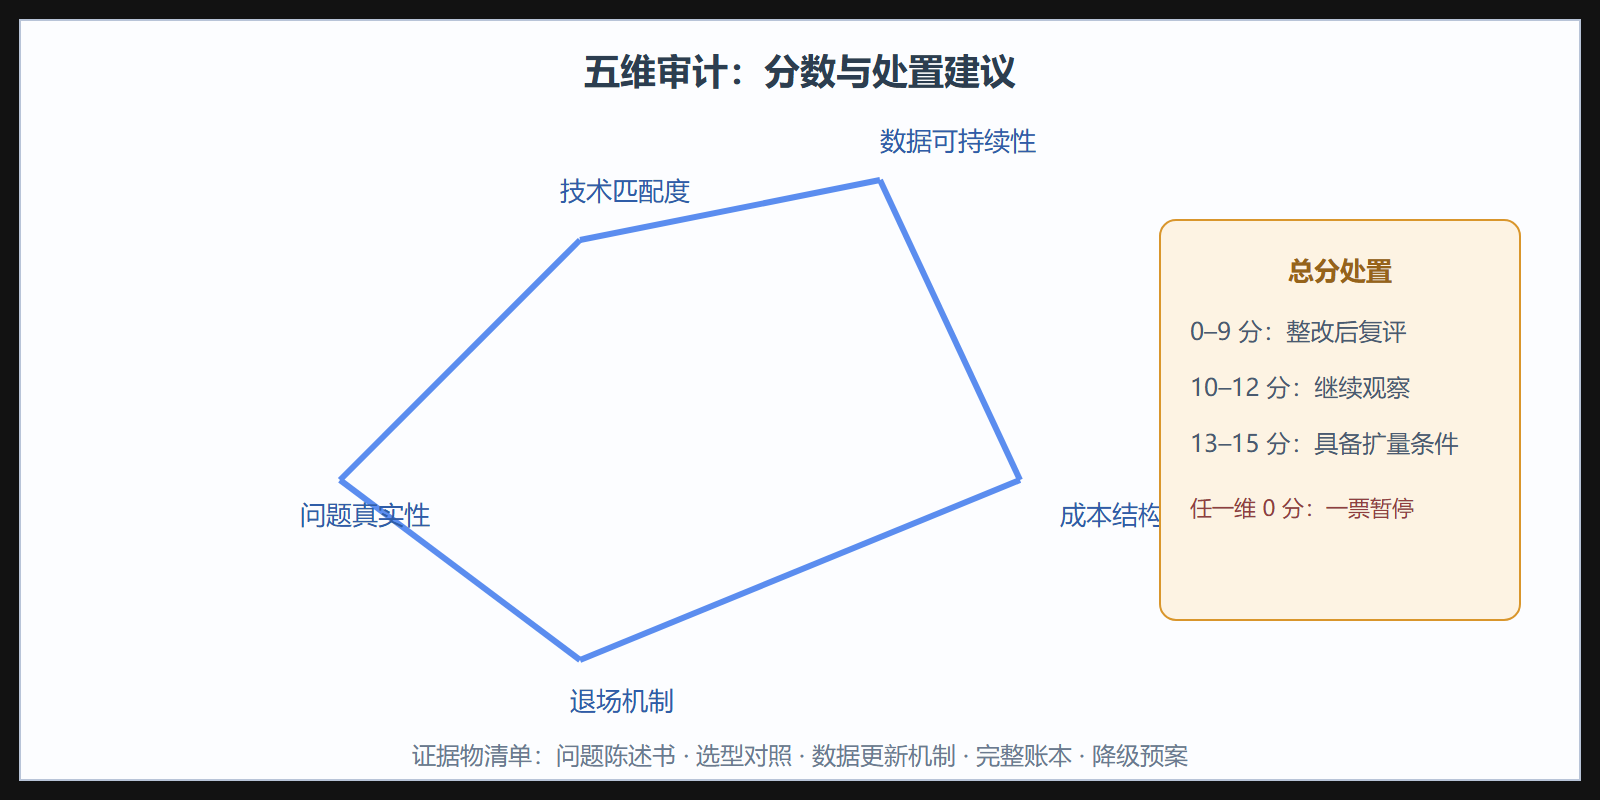
五维审计清单:评估AI落地项目的五个维度——问题真实性、技术匹配度、数据可持续性、成本结构、退场机制,每维0到3分,总分10以下建议整改,12以上具备扩量条件。本节是全册行业章节的公共量具。
前两节解决了"为什么审计"和"怎么算账",但真正到审计现场,你需要的是一份能拿着对项目逐项打分的清单。它的设计原则有两条:维度之间尽量正交,避免同一问题被两个维度重复计分;每个维度都要有可核对的证据物,不接受"负责人说没问题"。
五个维度与证据物
第一维,问题真实性。要核对的证据是书面的业务问题陈述与上线前基线指标。如果一份立项书通篇在讲技术名词,找不到"现状基线是什么、目标提到多少",这一维直接记零。第二维,技术匹配度。证据是选型对照:是否评估过更低台阶的方案。第三维,数据可持续性。证据是数据来源与更新机制:训练数据多久刷新一次、标签由谁持续供给、生产数据的漂移有没有监控。这一维最容易在项目半年后出事。第四维,成本结构。证据是包含标注、复核、运维的完整账本,即1.3节那套表。第五维,退场机制。证据是降级预案:模型失效或供应商退出时,业务回退到什么流程,多久能切换。
图:五维雷达与结论分区
用代码实现打分器
def audit_project(name, scores, evidence): """scores: 五维得分字典;evidence: 各维证据物是否存在的字典。 规则:任何一维没有证据物,该维得分按 0 计。""" dims = ["问题真实性", "技术匹配度", "数据可持续性", "成本结构", "退场机制"] effective = {} for d in dims: if not evidence.get(d, False): effective[d] = 0 # 无证据即无效 else: effective[d] = scores.get(d, 0) total = sum(effective.values()) if min(effective.values()) == 0: verdict = "一票暂停:存在无证据或零分维度" elif total >= 13: verdict = "具备扩量条件" elif total >= 10: verdict = "继续观察" else: verdict = "整改后复评" print("[%s] 五维=%s 总分=%d 结论=%s" % (name, effective, total, verdict)) return verdict audit_project( "连锁药店会员营销", scores={"问题真实性": 2, "技术匹配度": 3, "数据可持续性": 2, "成本结构": 3, "退场机制": 1}, evidence={"问题真实性": True, "技术匹配度": True, "数据可持续性": True, "成本结构": True, "退场机制": False}, # 没有降级预案 ) # 输出:退场机制归零,触发一票暂停——尽管其余四维都不差
这个"一票暂停"规则来自真实教训:一个四维全优的项目,因为没有退场机制,供应商合约到期后业务停摆三周。清单的第五维看似最不起眼,却常常是唯一不可逆的一维。
再用一段脚本演示审计结论如何随时间变化——同一项目在上线前、半年、两年三个时点的复评。
timeline = [ ("上线前", {"问题真实性": 2, "技术匹配度": 2, "数据可持续性": 3, "成本结构": 2, "退场机制": 2}), ("第6个月", {"问题真实性": 2, "技术匹配度": 3, "数据可持续性": 1, "成本结构": 2, "退场机制": 2}), ("第24个月", {"问题真实性": 2, "技术匹配度": 3, "数据可持续性": 0, "成本结构": 1, "退场机制": 2}), ] for phase, s in timeline: audit_project(phase, s, {k: True for k in s}) # 典型轨迹:数据可持续性随时间衰减,两年后归零——这就是"再训练预算"被砍掉的标准结局
解读与变式
背景是审计需要可操作的量具;操作是五维、分档、一票暂停的清单设计;结果是同一项目在时间轴上的分数轨迹暴露了数据衰减;解读为"审计不是一次性验收而是周期性复评";变式是高壁垒行业里"数据可持续性"往往与监管审批绑定(医疗影像模型变更要重新报批),衰减无法靠再训练修复,这是第2章的核心矛盾。方法篇到此收束,下一章进入第一个行业审计现场:金融。
清单的使用纪律
清单容易沦为走过场的打分表,三条纪律防止它退化。第一,每一维的评分必须附证据链接或访谈记录,"感觉不错"不算证据。第二,评分人里至少有一位业务一线代表——供应商和管理层都倾向乐观,一线的日常吐槽往往是最准的数据源。第三,五维得分不做简单平均:任何一维低于两分即触发一票否决讨论,这个规则逼着评审会把注意力放在短板上,而不是互相妥协出一个体面的总分。审计报告的结论页建议固定为三选一(扩量、整改、退场)加一句理由,格式越死板,越难被话术稀释。
一个真实的使用节奏
清单不是一次性工具。成体系的用法是按季度滚动:第一次全维度深审,之后每季度只复核两个最弱维,观察整改是否有效。半年后做一次全维度复审,与首次结果对比形成趋势线。趋势线比单次评分有价值得多——一个五维都在缓慢爬升的项目即使总分不高也值得继续,一个总分漂亮但数据可持续性逐季下滑的项目则要提前准备退场方案。
清单的边界
最后划一下清单的能力边界,免得它被神化。五维清单审的是"这个项目成不成色",不审"这个方向值不值得押注"——后者涉及战略赌注,清单给不了答案。它也不替代安全评测、算法审计这类专项检查,遇到推荐公平性、数据合规等专门问题,要在清单之外另走专项流程。工具的价值在于边界清晰:一把好尺子量它能量的事,越界的尺子量什么都不准。
补充一份常见的评分误区清单:把"供应商品牌"当证据(大厂也有失败产品线);把"参考客户名单"当验证(名单只说明卖出去过,不说明用得好);把"演示现场效果"当指标(演示集与生产集的鸿沟见1.1节);把"上线时长"当健康证明(勉强活着不等于产生价值)。评分人若同时扮演采购决策者,还要警惕自我证实倾向——人倾向于给已经想买的东西打高分。规避方法笨但有效:评分在采购谈判之前完成并封存,谈判后不得修改。