3.5 规模效率行业复盘:毛利里的AI
3.5 规模效率行业复盘:毛利里的AI
本节把四个效率现场收拢到一张账本上:用统一的回收期公式核对零售、制造、物流、农业的AI项目,回答一个问题——效率型AI的钱到底从哪里省出来,以及为什么同样的技术在四个行业成色差异巨大。
一条公式走四个现场
第3章开篇给出的成色公式在这里正式化:项目价值 = 单次决策节省额 × 决策频次 × 有效期 − 建设成本 − 维护成本 × 维护次数。四个现场的全部差异,都可以归结为公式里四个变量的不同取值。
图:四行业的价值结构对比
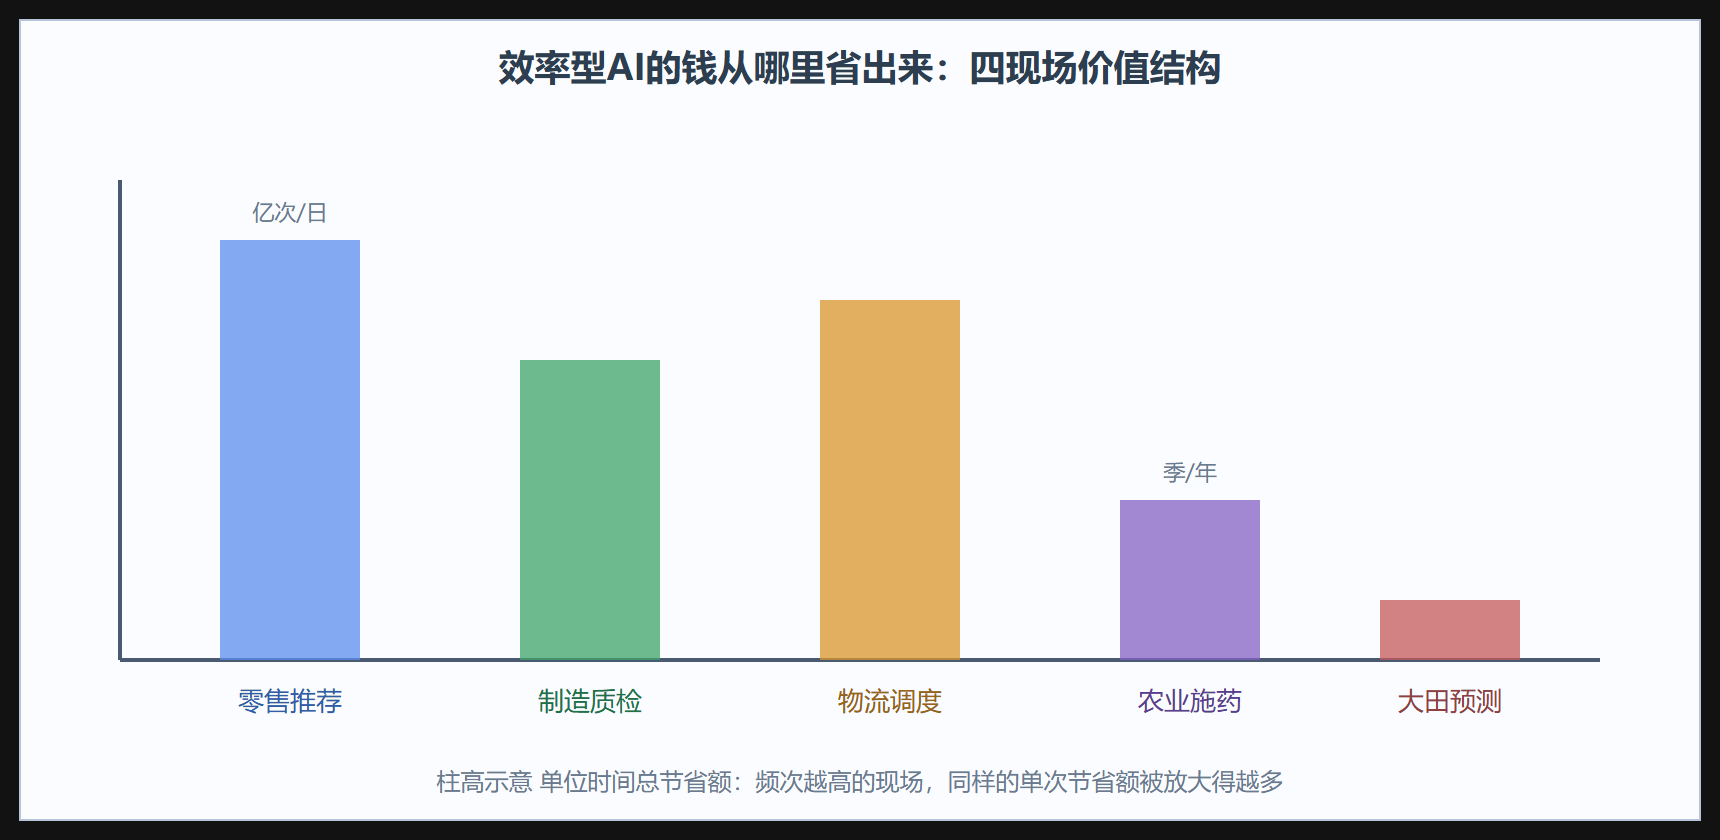
零售的柱子最高不是因为它单次推荐赚得多,而是频次是天文级的;农业柱子矮不是技术差,而是一年一季的频次封顶。这张图解释了一个反直觉现象:农业AI的论文水平不低,产业规模却始终起不来——公式里频次这一项压死了总盘。
用公式复算一遍
cases = { # (单次节省额, 日频次, 有效期天, 建设成本, 年维护成本) "零售推荐位": (0.4, 2_000_000, 365, 1_500_000, 400_000), "产线质检": (8.0, 160_000, 365, 800_000, 300_000), "站点调度": (150.0, 30, 365, 600_000, 150_000), "变量施药": (120_000.0, 1, 90, 180_000, 30_000), } def annual_value(name, params): unit, freq, life, build, maint = params gross = unit * freq * (life / 365.0) # 年化总节省 net = gross - maint years = build / net if net > 0 else float("inf") print("%s: 年净省 %.0f 万元, 回本 %.1f 年" % (name, net / 10000, years)) for name, p in cases.items(): annual_value(name, p) # 零售与质检频次高、回本快;调度单次节省大但频次低,靠的是决策重量; # 农业频次封顶,回本周期直接被拉长——与3.4节结论互相印证。
三个横向发现
第一,频次是杠杆,漂移是折旧。频次决定价值上限,数据漂移速度决定有效寿命。零售数据漂移快但重训便宜,农业漂移慢但重训等一年——两种现场都在"漂移成本与频次"这个乘积上分高下。
第二,维护成本是效率型项目的头号杀手。四个现场里唯一让回本周期翻倍的都是维护项:换型重训、算法服务费、季节性再标定。第3.2节那个从四个月变八个半月的案例不是例外,是常态。
第三,"谁付钱、谁省钱"经常错位。变量施药省的是农药钱,硬件钱却要种植户先掏;门店需求预测省的是总部库存资金,采集数据的活儿却压在店员身上。错位不解决,再好的账面模型也推不动——这与第2章医疗的成本错位同构,只是金额小一个量级。
本节在知识体系中的位置
本节收束第3章,也完成了成色公式从第1章账本到行业量具的最终成形:五维清单负责判断"该不该做"(第2章),回收期公式负责判断"值不值得做"(第3章)。第4章将面对一个公式算不进的变量——误伤的社会成本:教育里的误判影响一个学生的升学,政务里的误拒影响一个家庭的救济资格。公式还在,但分母上开始站着人。
公式的三个盲区
公式虽好用,也有三个盲区要当面说清。盲区一是学习曲线:效率型AI上线后头三个月的效果通常低于稳定期,回收期计算若用稳定期数据会系统性乐观,稳妥做法是把爬坡期单独建一栏。盲区二是对手跟进:你省下的钱在同行全面采用后会被竞争吃掉一部分(价格战或服务升级),超额收益的有效期取决于技术扩散速度——零售推荐的例子最典型,全行业都用时它从竞争优势退化为运营成本。盲区三是最难量化的间接收益与间接伤害:门店补货省下的店员时间如果被挪去做了更有价值的顾客服务,公式看不见;反之,过度自动化导致的技能流失,公式也看不见。三个盲区不推翻公式,但提醒我们把它当望远镜而非天平:用它排优先级足够准,用它做精确的年度预算就是自欺。
给一线的启示
对没有数据科学家的一线企业,本章最可执行的建议是:优先选漂移慢、频次高的"傻瓜场景"(水电费预测、排班优化、库存预警),用轻量工具做到七成效果,把省下的精力花在数据口径治理上。等哪天确有高价值场景再引入重模型,那时干净的数据资产比任何算法都值钱。规模效率行业的AI竞争,前半场比模型,后半场比数据底子——大多数企业现在还停在前半场的幻觉里。
一个综合练习
本章收尾的练习:任选你熟悉的一家企业,用公式完整算一遍它最适合的AI切入场景。步骤是先列出该企业所有"高频重复判断"(每天发生上百次的决策点),对每个点估单次节省额与年频次,排序取前三,再逐一检查漂移速度与维护成本。多数读者算完会发现:真正的最优场景几乎从不是供应商推销的那个。这个落差本身就是审计价值的量化——它就是避免一次错误采购的学费。
与第2章的拼图
最后把两章拼起来看一个完整图景:一个AI应用从技术上可行的千百个场景里,高壁垒行业筛掉了"责任与合规不允许"的,效率行业筛掉了"账算不平"的,剩下的交集才是值得投入的窄门。第4章还会再筛一层"误伤不可接受的"。三层筛子叠完,你会对"AI能做什么"有一个远比新闻标题克制的地图——而克制,正是成色二字的起点。
数字之外的提醒
效率章的最后一句话留给"数字之外":公式算的是钱,但一线员工对一个系统的接纳度,算不进任何公式。同样的补货系统,店员觉得"它替我扛了夜盘"就用心维护数据,觉得"它是来查我绩效的"就学会喂它假数。系统读到的数据质量,是员工态度的镜子。审计访谈里加一问"一线怎么看这个系统",答案对成色的预测力,常常超过整套财务模型——这不是修辞,是被反复验证的实操经验。
再给一个速算技巧:判断一个效率场景值不值得立项,先粗估"年决策次数乘以单次可省金额",得数若低于建设成本的三倍,直接放弃,不用进入详细论证——三倍是经验性的安全边际,覆盖爬坡期、维护与盲区的联合折损。这个粗筛五分钟就能做完,能替组织挡掉大半注定亏损的立项热情,把评审资源留给真正的边界案例。