1.3 六款OLAP引擎同台对比
1.3 六款 OLAP 引擎同台对比
本节摘要:选型会的经典尴尬是没有反例的 PPT。本节构造一个具体场景——电商平台订单分析中台,日增三亿行明细、近七日热数据常查、季度级别冷数据偶发回溯——然后把 Doris、StarRocks、ClickHouse、Trino、Druid 与 Hive 离线体系放进同一约束条件下逐一评估。结论不是宣布谁最好,而是演示一套可复用的打分方法。
学习目标
阅读完本节,你应当能够:
- 把模糊的业务需求翻译成分维度评分卡;
- 说清 Doris 与 StarRocks 这对"亲缘引擎"的真实差异面;
- 判断 ClickHouse 的强项区域为什么恰好绕开了多表关联;
- 解释 Trino 与 Hive 在这张评分卡上的位置为什么"零重叠";
- 输出一份带权重的选型结论模板。
一、先把需求钉死
一家电商中台的原始诉求通常是这样一句话:"老板要实时的销售大屏,分析师要自己拖拽取数。"翻译成工程语言是五条硬约束:
| 维度 | 本例的具体形态 | 权重 |
|---|---|---|
| 数据新鲜度 | 从下单到大屏变更不超过一分钟 | 25% |
| 查询模式 | 七日内多维过滤加聚合为主,跨三张以内事实表关联 | 25% |
| 并发压力 | 大屏与自助分析合计峰值五百并发 | 15% |
| 更新需求 | 订单取消、退款要改历史事实行,占比约百分之三 | 10% |
| 冷数据与成本 | 季度以上数据很少访问但必须可查,预算敏感 | 25% |
权重没有标准答案,它反映的是这家公司"犯错最痛的地方"。同样的产品换一家财务合规严格的公司,更新一致性的权重会被顶到首位。这一步的意义在于:后面所有引擎的差异都只是"输入",权重才是你自己的东西。
二、六个选手的快照
Doris:FE/BE 两角色架构,MySQL 协议直连,主键模型支持行级更新,近年补齐了物化视图自动改写与湖仓联邦。学习曲线平缓,社区中文资料密度高。短板是超大规模冷数据的存储成本与顶级离线吞吐。
StarRocks:与 Doris 同源异流的分析数据库,同样走 MPP 加列存路线。差异化侧重在 CBO 优化器成熟度、多表关联性能与存算分离的产品化程度。对重度 Join 场景给出的上限略高,社区生态与国产云厂商绑定更深。
ClickHouse:单表扫描与压缩比天花板极高,写入吞吐强悍。代价是多表关联传统偏弱、更新语义受限、分布式形态依赖 ZooKeeper 组合的版本演化(近年也在补)。以日志分析、行为事件宽表起家的团队往往已经用了它,迁移动机要看 Join 占比。
Trino(Presto 系):本身不持有数据,是纯粹的联邦查询引擎,连接一切然后现场计算。适合"数据散落在多个系统里且不想搬迁"的阶段;一旦查询频率与数据量上升,缺乏本地加速层的短板开始显现——它解决的是聚合问题,不是性能问题。
Hive 离线体系:生态最厚、成本最低的存量资产,但 T+1 的节奏天花板明摆在那里。它的正确位置是承担全量回刷、口径审计与非实时大盘,而不是被强行推进实时赛道。
Druid:面向事件流的时序式摄入与低延迟过滤聚合,运维面较宽,SQL 能力相对受限。在"仅事件型、无关联、超高频写入"的窄道上仍是可用答案,但作为通用中台底座会显得别扭。
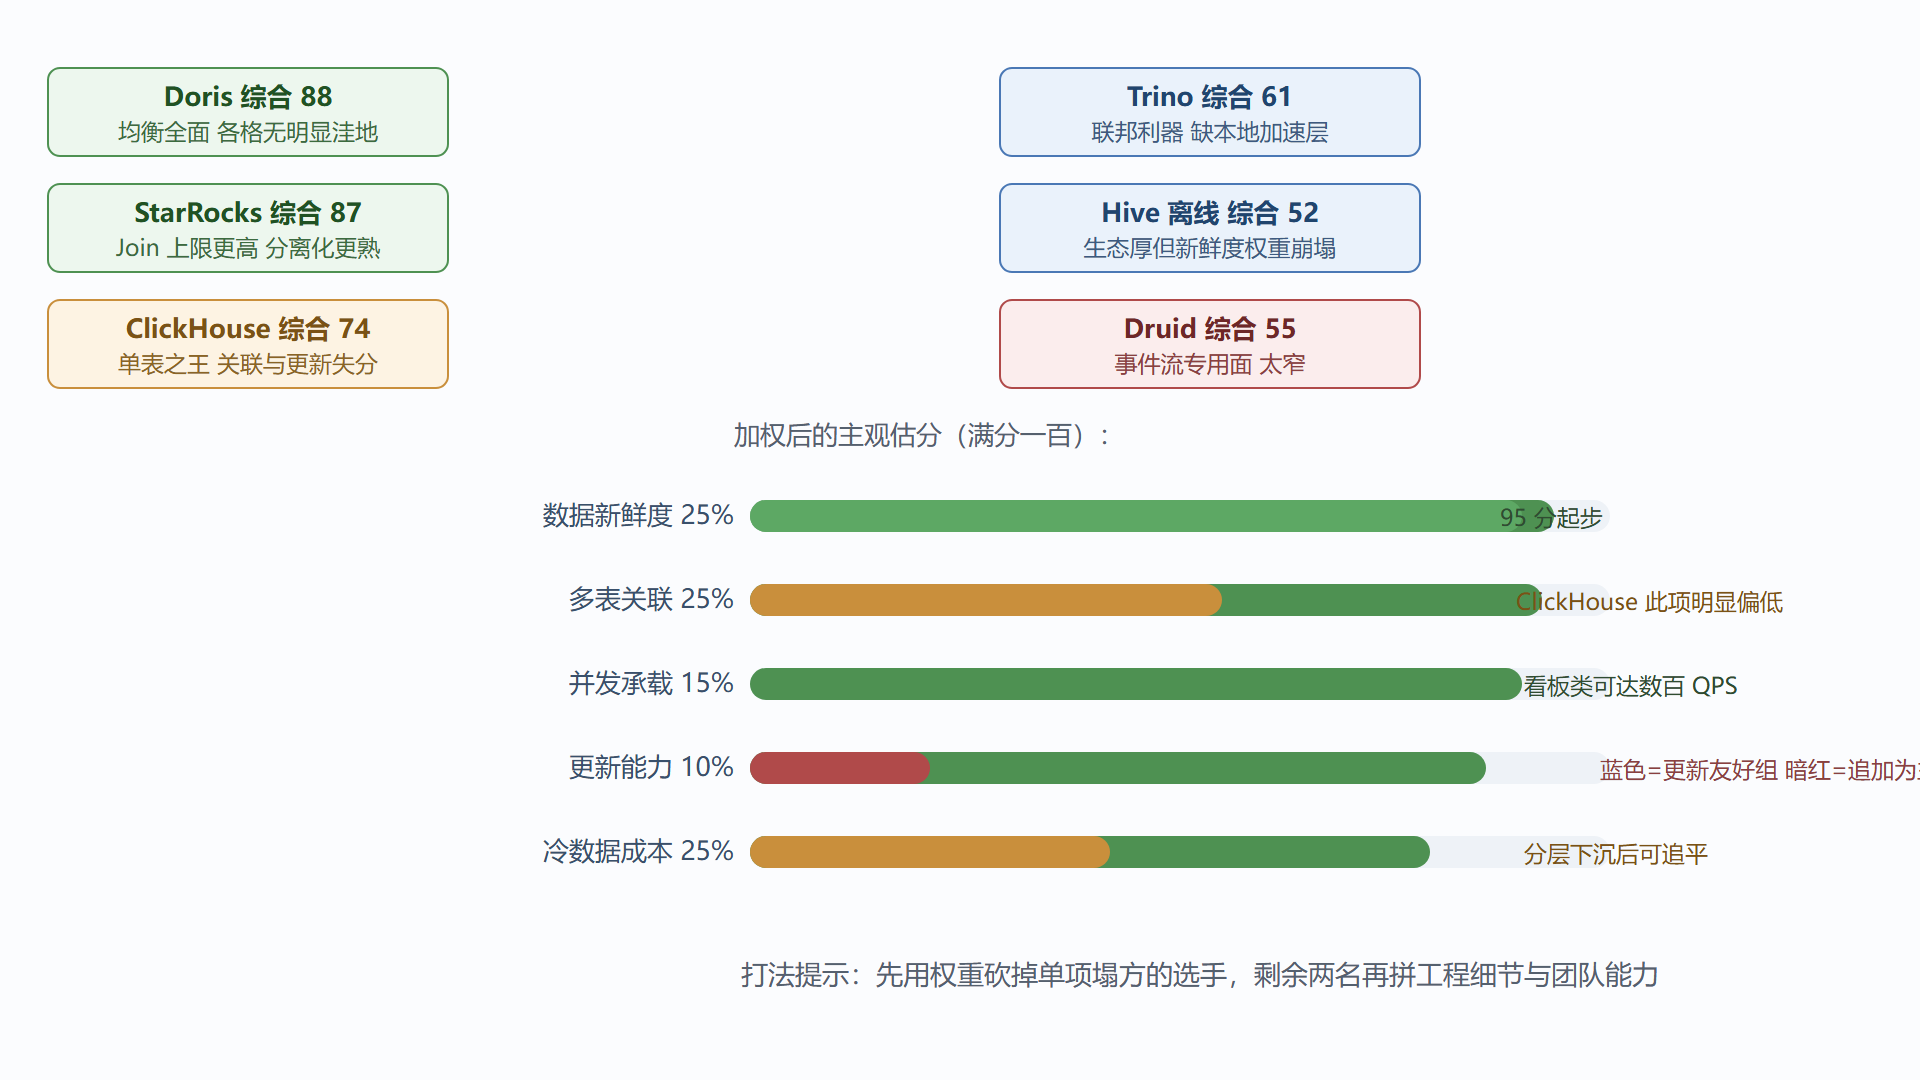
图 1-3:六引擎在本场景约束下的雷达式得分
三、几组容易吵起来的对手戏
Doris 对 StarRocks:血缘相近使功能清单高度趋同,差异沉淀在细节里。StarRocks 的 CBO 与 Join 策略在大宽表加维表的星型场景常给出更稳的计划;Doris 的物化视图自动改写与 Multi-Catalog 迭代节奏也有独到处。务实做法是用自家真实 SQL 各跑一轮基准,重点看 P99 而不是均值。
Doris 对 ClickHouse:分歧点是 Join 与更新。行为埋点这类"宽表 + 少关联"的负载,两者都会让你满意;一旦数清涉及多张事实表的口径,ClickHouse 的方案复杂度开始上升,而这是 Doris 的主场。反过来,若团队已有成熟的 ClickHouse 运维经验且查询大多单表,更换动机就不足。
Trino 与 Hive 的正确站位:它们不是失败者,而是另一个时代的正确答案。很多理想架构其实是三者混编——Hive 承担全量与审计,Trino 打通长尾系统,Doris 承接高频交互查询。承认各自的位置,比争论谁取代谁更有产出。
四、落到本例的裁决
按上面的权重逐项乘加,本例的方向是明确的:Doris 或 StarRocks 二选一进入 PoC,负责七日热数据的实时服务;Hive 体系原样保留,承担季度冷数据与口径对账,并通过外部表目录让两边互通。 ClickHouse 不入选的原因单一而充分——跨表关联占查询总量的四成,权重压倒了它所有其他优点。
💡 关键直觉:选型文档最有说服力的部分从来不是"我们选了 A",而是"我们淘汰 B 时牺牲了什么、为什么不心疼"。
五、PoC 该测什么
一旦锁定两名候选,验证清单收敛为五件事:
-- 一、代表性 TopN:看板上出现频率最高的那条聚合 SELECT province, category, SUM(pay_amount) AS gmv FROM dws_order_wide WHERE dt >= '2026-08-20' GROUP BY province, category ORDER BY gmv DESC LIMIT 100; -- 二、双事实表关联:考验 Join 策略与 Runtime Filter 收益 SELECT u.member_level, COUNT(DISTINCT o.order_id) AS orders FROM dwd_order_detail o JOIN dim_user u ON o.user_id = u.user_id JOIN dwd_refund r ON o.order_id = r.order_id WHERE o.dt = '2026-08-26' GROUP BY u.member_level;
补充三项:以生产峰值两倍的速率灌入数据观察导入积压;模拟 BE 单节点宕机看查询抖动幅度;最后估算三年 TCO,把冷数据分层方案一并计入。五项都有了数字,评审会就不用再吵气质和信仰了。
常见疑问
问:对比表的结论会过时吗? 各引擎的能力边界随版本演进在变,尤其联邦查询与物化视图这类快速演进的领域。但对比的框架不会过时:按"数据形态、时效、查询模式、运维成本"四个维度打分的方法,任何新版本、新产品都适用——记住框架,表格自己会更新。
问:能不能多引擎混用? 能,而且是大团队的常态:Hive 承载超大规模离线、Doris 承载实时分析、ClickHouse 承载单表极致扫描,各守各的舒适区。混用的代价在链路——每多一个引擎就多一条同步链路和一套运维手册,所以混用要按"引擎数量最小化"原则收敛,而不是按"每个场景配最优引擎"发散。
本节要点回顾
- 权重先行:评分卡的权重属于业务方,引擎表现只是公式的输入。
- 亲缘引擎找细节差:Doris 与 StarRocks 的分辨靠 P99 基准与既有运维栈,不靠功能表。
- ClickHouse 的失效开关是关联占比:单表王座不受影响,但四成关联查询足以翻转结论。
- 老引擎各有其位:Hive 保审计与冷数据,Trino 打通孤岛,混合编排优于互相取代。
- PoC 只测五件事:代表 Query、峰值灌入、节点宕机、TCO、口径关联合练。
第 1 章到此完成了"要不要用、凭什么信"的闭环。下一章我们打开引擎舱盖,看清 FE 与 BE 这两个角色如何分工协作——那是理解后面所有行为差异的解剖学基础。