5.4 慢查询降耗演练实录
5.4 慢查询降耗演练实录
本节摘要:方法论读三遍,不如完整跟一次手术。本节复盘一条真实运营日报 SQL 从十二秒四压到零点八秒的全过程:怎么接的工单、Profile 里看到了什么、每一刀下去时间省在了哪、以及四种变式场景下同一套思路怎么变形。它是 5.1 执行流程、5.2 优化技术、5.3 调优实践三节知识的合流口,也是通往第 6 章物化视图的引桥。
这场演练练什么
阅读完本节,你应当能够:
- 独立走完"取证—归因—干预—验证"四步降耗流程并留存可比对证据;
- 把一次优化收益拆解到扫描、关联、聚合三层,说清每层的收益来源;
- 面对日期条件无法改写、维表膨胀、并发翻倍等变式时知道下一步棋;
- 判断一条稳定报表何时应当交给物化视图接管。
一、案件卷宗:一条十二秒的日报
早晨八点半,运营负责人照例打开日报页面,转圈十二秒。工单三件套齐全:语句文本、发生时间(每天 08:30 必现)、期望时长(三秒内)。语句形态是典型的小型星型查询:订单明细事实表按天分区,单分区约三百八十万行,关联九十万的用户维表与四十五万的商品维表,按大区加一级品类聚合,再取支付金额前十的分组。
三个维度的画像先立起来。业务侧:这是固定日报,形态长期稳定,无人为的随机过滤;数据侧:事实表按天分区、按 user_id 哈希三十六桶,维表各自独立建表;执行侧:高峰期与它同台的有实时大屏看板和若干 ad-hoc 查询。画像决定了处置原则——这条语句值得花半小时做一次性的深度手术,而不是靠资源组排队让它慢慢等。
二、取证:EXPLAIN 与 Profile 的双重确认
先跑 EXPLAIN,三个信号里两个亮红灯。其一是分区命中:扫描节点列出了全部九十个分区,而不是当天一个——回头看语句,日期条件写的是对分区列套函数比较的形态,裁剪机制认不出这是一个分区内的区间,直接放弃了裁剪。其二是过滤器传递:计划里没有运行时过滤器的注记,两张维表的过滤条件无法反推到事实表扫描侧。其三倒是正常:统计信息在最近一次采集之后有效,Join 顺序没有离谱。
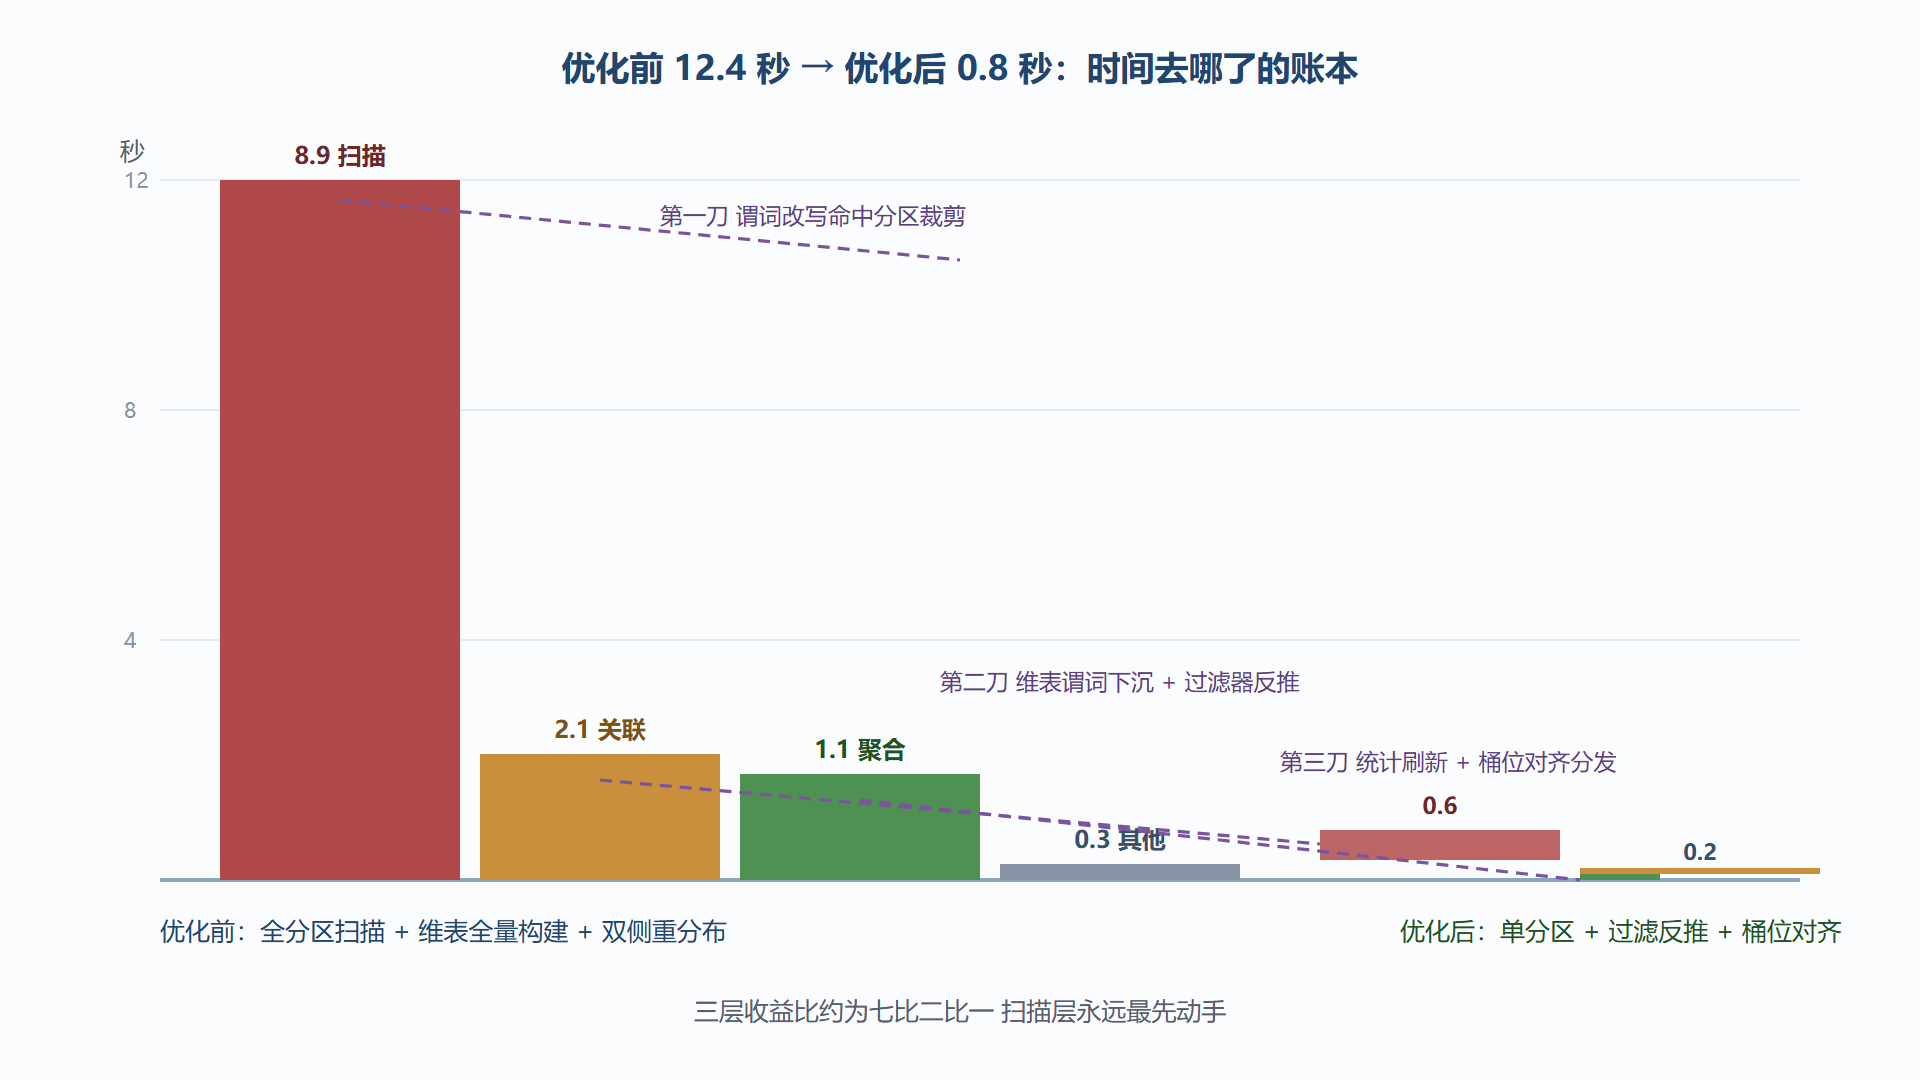
再看 Profile。总览里计划时间不足百毫秒,嫌疑集中在执行段;进入最长的 Fragment,账本是这样的:扫描算子耗时八点九秒,输入三点八百万行、输出三点八百万行——输入输出几乎一比一,说明过滤全部发生在扫描之后的关联阶段,裁剪完全没干活;两个哈希关联合计二点一秒,其中构建侧吃满了维表全量;两阶段聚合一点一秒,局部阶段输出行数只有输入的百分之四,聚合本身健康。时间账很清楚:十二秒里约九成花在了"本不该发生的扫描"上。
三、手术:三刀的次序与依据
第一刀,把日期条件改写成裁剪器认识的形态。 放弃对列套函数的写法,改为分区列上的左右闭区间比较。这一刀零成本、零风险,是所有优化里优先级最高的动作。改完复跑:扫描耗时从八点九秒跌到一点二秒,输入行数从全表累计跌到单分区三点八百万——总耗时降到四点六秒,第一刀就拿回了六成收益。
第二刀,让维表过滤先发生,再借用运行时过滤器反推。 语句里本来就有渠道与类目过滤,问题在于它们写在关联之后的外层。把这两个谓词下沉到维表子查询内部,过滤后用户维表剩约十一万行、商品维表剩约六万行;同时确认会话打开了运行时过滤器的生成开关。复跑:事实表扫描在关联阶段被反推过滤后再砍掉近半行数,扫描段进一步落到零点六秒,两个关联合计缩到零点一五秒——小表构建哈希的开销随行数同比例缩水。总耗时进入两秒以内。
第三刀,修正分布假设,把双重重分布换成桶位对齐。 前两刀之后计划里仍是标准的 Shuffle 关联:两侧都要按键重分布。回看建表语句,事实表与用户维表恰好都以 user_id 哈希分桶。补跑一次统计信息采集让优化器拿到新鲜行数,它自动把这条关联切换为桶位对齐的分发方式——只重分布维表一侧甚至完全本地化。关联段的开销几乎归零,聚合成为新的最大头,总耗时定在零点八秒。
图 5-2:三刀前后三层耗时的瀑布对比
四、解读:收益为什么是这样分布的
把三刀的收益摆在一起看,比例大约是七比二比一,这个分布不是巧合。扫描层的收益最大,因为分析型负载的第一性成本就是"读了多少字节"——分区裁剪把数据量砍了一个数量级,后面的所有环节都跟着受益;关联层第二,它的收益一部分来自扫描层(进入关联的行数变少),一部分来自构建侧收缩与分发方式修正;聚合层最后才轮到,而且本案例里它本来就健康。顺序感比技巧感重要:先裁剪、再收敛、后对齐,倒过来做的团队常常在三分钟里就能跑完的查询上浪费一下午调关联参数。
另一条值得写进案例库的观察:每一刀之后都留存了前后两份 Profile 对比。零点八秒这个数字本身并不重要,重要的是"扫描输入行数从全表累计降到单分区""关联构建侧从四十五万行降到六万行"这两条证据链——它们让优化结论可以被复核,也让三个月后接手的人在档案里能看懂当时为什么这么改。
五、变式:四种常见变形怎么接
变式一,日期条件来自应用层拼接,改不了写法。 报表平台用固定模板生成 SQL 时,可以让平台侧统一改为区间比较;若平台真的动不了,退而求其次用动态分区兜底——把热分区的保留窗口调小,让"全分区扫描"扫描的分区总数本身变小。这是治标,但能把十二秒压到三秒量级,为治标换治本争取时间。
变式二,维表持续膨胀,过滤后仍有百万行。 收敛失效时,重复本案例第三刀的前提:检查两表是否同键分桶。若维表也按关联键分桶且建模期声明了同布属性,关联可以完全本地化;若业务上维表无法同布,考虑把高频的关联结果下沉为异步物化视图,让查询直接命中预聚合结果——这正是第 6 章第一节的正题,判断依据在 5.2 已经给过:形态稳定、高频、可预计算的查询才值得接管。
变式三,大促峰值并发翻倍。 单条语句的手术做完,还要回答"一百个人同时点这个报表会怎样"。结果集形态稳定的报表适合加一层结果缓存或让网关做相同语句归并;同时用资源组给这条日报划出保底配额,防止它被突发 ad-hoc 挤出队列——隔离手段来自 5.3 第三节。
变式四,同类报表还有二十条。 一条一条手术不现实。按 5.3 的周榜思路把同形态语句归组,对组内共性的部分(分区改写模板、维表过滤下沉、统一统计采集节奏)做成规范写进 SQL 评审清单。个案 surgery 的终点永远是组案的制度。
常见疑问
问:为什么不第一时间就上物化视图,而是先做三刀手术? 因为预计算是用写入成本换查询成本,前提是查询形态已经稳定且无法再简化。本案例前两刀属于"语句写错了"的范畴,任何预计算都救不了写错的语句;先把语句修正到健康形态,再评估是否值得物化,否则只是把坏语句的代价转移给了导入链路。
问:零点八秒之后还有必要继续压吗? 看边际成本。这条语句的剩余耗时里聚合占大头,再压只能靠预计算接管,收益不到半秒,却要付出维护视图刷新的任务。判断标准回到业务侧:日报场景三秒内无人投诉,零点八秒已经进入"体感即时"区间,把工时留给下一条十二秒的语句更划算。
本节要点回顾
- 取证先于动手:EXPLAIN 三信号加 Profile 四步读法,先拿到证据链。
- 收益分布有规律:扫描、关联、聚合约为七比二比一,先裁剪再收敛后对齐。
- 每刀留存前后对比:优化结论靠行数证据说话,不靠耗时孤证。
- 变式决定第二刀的方向:改不了语句就缩小分区窗口,收不动维表就交物化视图。
- 个案沉沦为制度:同形态语句归组治理,评审清单是优化的复利载体。
至此演练场的四节收拢成一个完整的闭环。下一章把加速的视角从"单条语句怎么救"切换到"让系统自己记住计算结果":物化视图与联邦查询登场。