6.4 寄存器开发与库开发之争
6.4 寄存器开发与库开发之争
本节摘要:直接读写寄存器,还是调用厂商库函数?这条路线之争在嵌入式社区吵了二十年。本节还原争论的历史由来,算清两条路线在效率、可控性、可移植性、团队协作四本账上的差异,评析图形化代码生成的利弊,最后给出按项目与团队分层的混合路线建议。读完你能做出自己的路线选择,并说清选择的代价。
争论从哪来:库出现之前的世界
在库普及之前,嵌入式程序员人人都是"寄存器派"——别无选择。每个外设的每个功能,都要翻数据手册找到控制寄存器的每一位,按位拼装配置。这造就了初代嵌入式工程师的深厚功力:他们对芯片的了解到比特级。转折发生在 32 位时代:Cortex-M 的外设复杂度数量级上升(一个 USART 的配置相关位超过三十个),靠手拼寄存器出错的概率与时间成本都失控了。厂商顺势推出标准外设库,再演进为今天主流的 HAL(硬件抽象层)与 LL(底层库)体系。争论由此而生:老一代觉得"库把年轻人惯坏了,出了问题连寄存器都不会看";新一代觉得"都 2020 年代了还手拼寄存器是自虐"。两边都对,也都没说到点子上——路线选择的本质是四本账怎么算。
同一外设的两种写法:直接感受差异
以 4.2 节配置过的串口为例,先看两种写法的并排对比:
/* 路线A:寄存器直写——每一行都对应手册里的一个位域 */ RCC->APB2ENR |= RCC_APB2ENR_USART1EN; /* 开串口时钟,位6置1 */ USART1->BRR = 39; /* 波特率分频值,自己算好 */ USART1->CR1 = USART_CR1_UE | USART_CR1_TE | USART_CR1_RE; /* 路线B:HAL 库——意图直白,细节被封装 */ HAL_UART_Init(&huart1); /* huart1 结构体里声明时钟、波特率、帧格式 */
寄存器写法的信息密度高:每一行就是手册里的某一节,改哪个位、为什么这么改,写的人心里有电路图。HAL 写法的信息密度低但意图直白:读代码的人知道"在初始化串口",不必关心位 6 是谁。前者写给芯片看,后者写给人看——这句概括够形象,但四本账的差距比这更细。
四本账:效率、可控、移植、协作
效率账:差距存在但常被高估。 寄存器直写生成最精简的指令序列;HAL 库为了通用性做了参数检查、句柄管理等额外工作,同一操作的目标代码可能大几倍、执行慢几倍。但注意量级:一次 GPIO 翻转,寄存器写法两个周期,HAL 可能十几二十个周期——在 72MHz 下差距是零点几微秒,对多数应用无关痛痒。真正要计较的是三处:极高频的操作(ISR 里的翻转、位带操作)、Flash 与 RAM 极端紧张的型号、以及启动路径。效率差距是真实的,但它是局部问题,用局部手段解决(热点处下沉到寄存器),不必全局殉道。
可控性账:寄存器派最有力的论点。 调试疑难杂症时,"知道库里那行函数动了哪些寄存器"的人排查速度占优——5.4 节的两个案例,若不懂寄存器层,打点测 ISR 耗时、查挂起寄存器都无从下手。此外库也有 Bug:厂商库的历史版本里出现过外设配置错误,会看寄存器的人能绕过去,纯库用户只能等更新。这一账的结论不是"都要寄存器开发",而是**"用库的人也要有寄存器的读能力"**。
可移植性账:库派的地盘。 换一颗同系列芯片,HAL 代码几乎零改动;跨系列甚至跨厂商,寄存器地址与位定义全要重写。产品换代、供货切换频繁的商业项目,这一账的分量比效率账重得多。
协作与维护账:库派再得一分。 新成员上手 HAL 项目一两周即可干活;寄存器项目的新人要先啃完整个数据手册。三年后的维护者面对 HAL 代码能看懂意图,面对手拼寄存器则要逐位考古。团队规模越大、人员流动越频繁,这一账权重越高。
| 账目 | 寄存器直写 | 库函数开发 |
|---|---|---|
| 代码效率 | 最优 | 有额外开销,热点可下沉 |
| 可控与排错 | 比特级理解,疑难杂症占优 | 需补寄存器读能力 |
| 可移植性 | 换芯片基本重写 | 同系列近乎免改 |
| 协作与上手 | 学习曲线陡 | 新人两周可干活 |
| 代码量 | 冗长但精确 | 简短但黑盒 |
| 适合 | 教学、极端资源受限、底层驱动 | 产品开发、团队协作、快速迭代 |
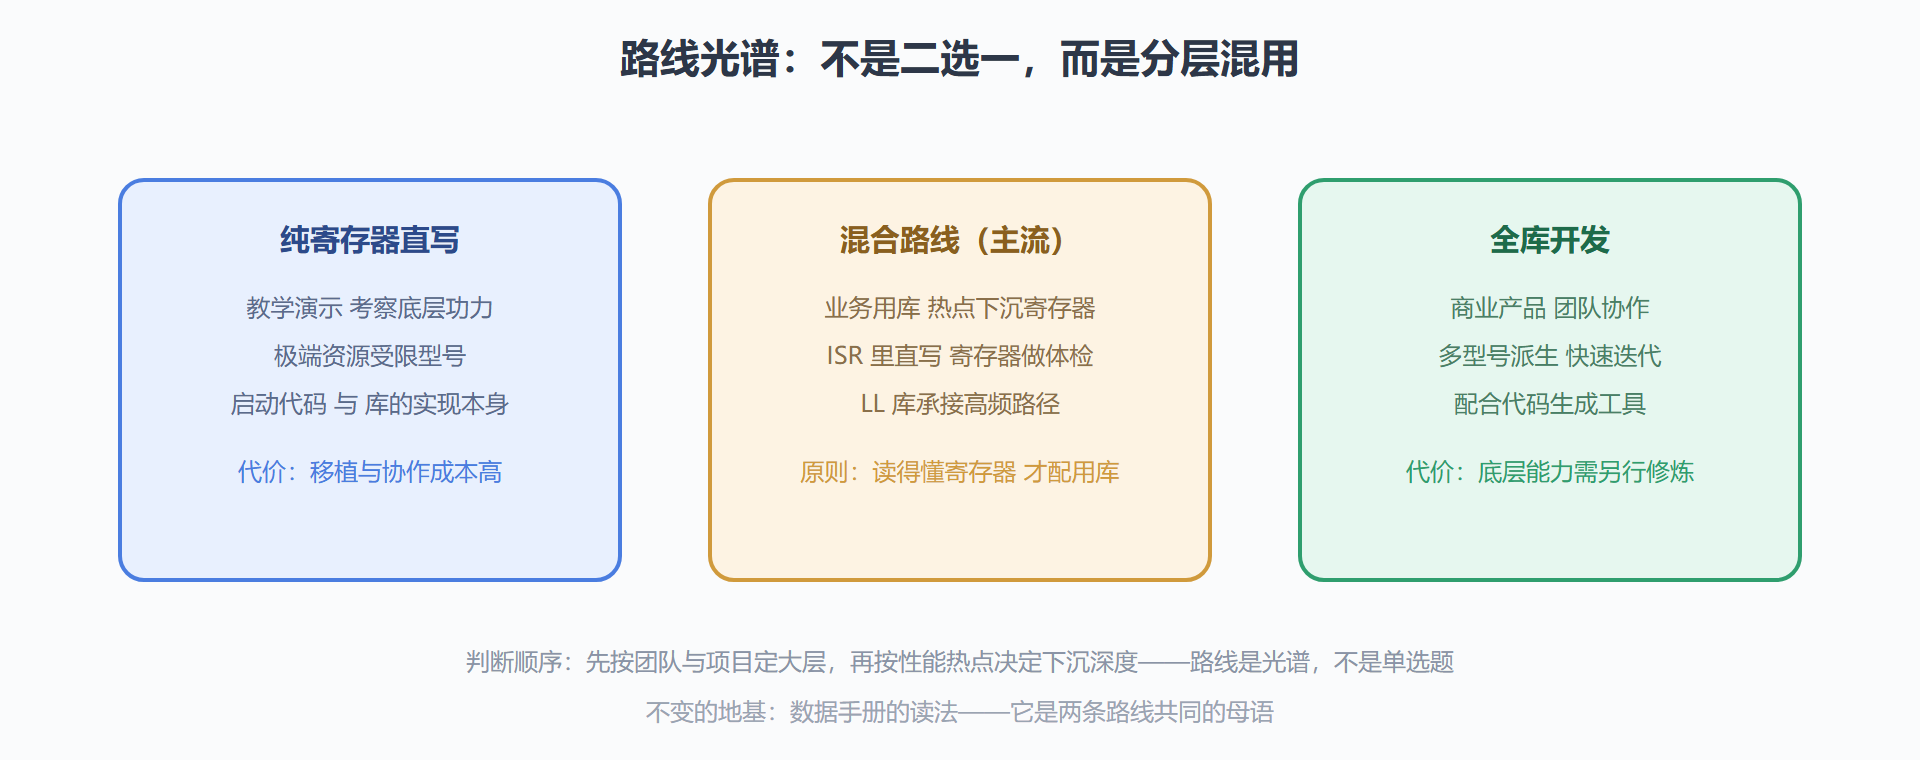
图 6-4:两条路线的定位与混合地带
代码生成工具:加速器与黑盒的双面性
图形化配置工具(引脚点选、时钟树拖拽、外设参数填表,一键生成初始化工程)把 HAL 的效率红利又放大了一层。正面:配置错误率大降(时钟树非法组合工具会直接拒绝)、工程搭建从半天缩到十分钟、引脚冲突一目了然。反面要同样清醒:生成代码是"配置的快照",理解它仍需回到寄存器层——4.2 节的串口五步配置,用生成工具三十秒完成,但出问题时会看生成的初始化代码与寄存器视图的人,才有能力修;此外,生成工程再生成时可能覆盖手工修改,工程管理上要把手工改动隔离在标记区之外。使用建议一句话:让工具写你确认过的配置,而不是让工具替你决定配置——配置前先懂配置,工具才是加速器。
给学习者的路线建议
回到本节开头的老少之争,给正在学习的你一个具体路径。第一阶段,寄存器打底:挑一个外设(GPIO 最合适)用纯寄存器写通,配合数据手册逐位对照——这一步买的是"读寄存器"的终身能力。第二阶段,库开发建立生产力:项目代码全面转 HAL 或 LL,体会意图式编程的效率。第三阶段,混合成熟:业务用库,热点(ISR 内的翻转、高频采样)下沉直写或用 LL 库,调试时用寄存器视图做体检。三条阶段走完,路线之争对你就不复存在——因为两条路你都能走,选择只是场景题。争论的双方争的是"哪条路",高手关心的是"哪种能力"。
一段真实的迁移故事:读寄存器的能力救过一次量产
用一段编年史给这场争论作注。某小家电产品用某国产 Cortex-M0 芯片量产两年后,新批次整机出现千分之三的串口偶发丢字节,老批次完好。团队用库开发写的代码,逐项核对初始化参数无差别,一度怀疑芯片批次问题。最后是寄存器层的比对破了案:把两批次芯片的外设寄存器逐个读出对比,发现新批次出厂默认的时钟输出配置位有差异,影响到采样点微移——厂商手册的勘误里有记载,但 HAL 库的参数层根本暴露不出这个差异。修复是在初始化序列里补一行寄存器直写,把该位钉死。这件事的教训双面:库没有错,错在只看得到库的人;而"能下到寄存器层去比差异"的能力,平时看不出价值,出事时就是唯一的那条路。这也是本节反复强调"寄存器读能力是可控性那一本账"的具象版。
问题:换芯片时,库代码真的能"平移"吗?
能平移的是结构,不是代码。HAL 的移植承诺覆盖外设初始化的"形":接口名、配置结构、调用流程基本一致,改动量远小于寄存器重写。但三处差异要诚实对待:外设差异本身(老型号没有的功能不能凭空移出,比如低型号没有 DAC)、时钟与引脚映射的重新核对(每个型号的复用表不同)、以及行为细节的隐式变化(同样的采样时间参数在不同工艺的 ADC 上噪声表现不同)。经验上的公平结论:库把移植成本从"重写"降到"重验",而重验这一步省不掉——凡是直接碰物理世界的配置(时序、采样、驱动强度),换芯片后都要上板重新确认。这与 7.1 的接口合同一脉相承:接口名字可以合同化,物理行为必须实测。
本节要点回顾
- 争论的由来:外设复杂度上升催生了库,路线之争的本质是四本账的权重分配。
- 四本账:效率差距真实但局部化;可控性是寄存器读能力;可移植与协作是库的强项。
- 混合是主流:业务用库、热点下沉、ISR 直写、寄存器视图体检——按层选择而非站队。
- 代码生成是双面刃:配置快、错误少,但"让工具写你确认过的配置",理解仍需回到寄存器。
- 能力比路线重要:寄存器打底、库开发提效、混合成熟——三阶段走完,争论自动终结。
- 体系位置:代码写出来了,如何让它经得起现场十年折腾——下一章进入系统工程。