2.4 栈溢出排错实录:从偶发复位到钩子定位
2.4 栈溢出排错实录:从偶发复位到钩子定位
本节摘要:栈溢出是嵌入式领域最会伪装的故障——症状从来不在病根处。本节以一张"智能表计偶发复位"的工单为主线,完整走一遍排障闭环:从现象研判、双级溢出检测的启用、钩子函数抓取出错任务、栈水位测量复核,到定位一个藏在格式化日志里的巨型局部缓冲。除了解案本身,更重要的产出是溢出的机理模型与检测手段的边界认知——哪些溢出内核根本测不到。这是本册故障工单池的第一单。
前两节分别讲了任务的栈(私有工作台、向下生长)与调度规则,本节让它们在最凶险的场景里会师。栈溢出值得用一整节讲,不仅因为它高发,更因为它完美演示了"工单式排障"的方法论:不猜,逐步收紧包围圈。
一、工单进场:现场偶发复位
背景。某电池供电的智能表计,功能全部验收通过后在试点小区运行。两周后陆续有设备反馈"莫名重启":一天零到三次不等,复位后一切正常,读数不丢。实验室烤机四十八小时无法复现。固件基于 FreeRTOS,任务划分是:计量(优先级四)、通信(三)、显示(二)、日志(一)、空闲钩子里喂狗。
初步研判。复位且能自动恢复,最先怀疑三个方向:电源跌落(看门狗复位源寄存器可排除)、硬故障(复位寄存器会记录硬故障原因,读出来是干净的)、看门狗超时(喂狗逻辑一直在跑)。复位寄存器显示的是"软件复位"——也就是说,某段代码主动请求了复位。谁会主动复位?固件里只有两处:断言失败的兜底分支,和栈溢出钩子。而断言宏在量产版里是空的。嫌疑瞬间集中到栈溢出钩子——但它也没配置。那复位从哪来?进一步排查发现,工程早期有人写过一个"内存管理异常兜底复位",藏在分配失败处理路径里。线索闭合了:某种内存异常触发了兜底复位,而最常见的运行期内存异常,就是任务栈溢出。
二、启用双级检测:让内核替你站岗
FreeRTOS 内置两级栈溢出检测,都在配置文件里一个宏开启。一级检测的原理:任务创建时栈被填充固定模式,上下文切换时检查栈底最后一段是否仍是模式值——被改写说明栈已经用到了栈底附近。二级检测更进一步:切换时扫描整个栈区找模式字节,能抓到"曾经深潜又浮上来"的历史性越界,灵敏度更高、开销也更大(每次切换多一次扫描)。
/* 排障配置:检测等级 2,钩子必须成对出现 */ #define configCHECK_FOR_STACK_OVERFLOW 2 void vApplicationStackOverflowHook(TaskHandle_t xTask, char *pcTaskName) { /* 排障期动作要短、要立刻、要不依赖被破坏的内存 */ emergency_log("STACK OVF: %s", pcTaskName); /* 记下出错任务名 */ reset_capture_state(); /* 保留现场供复位后分析 */ taskDISABLE_INTERRUPTS(); for (;;) { } /* 停在这里等调试器或看门狗复位 */ }
操作。烧入排障版固件,钩子里只做三件事:把出错任务名写进一块掉电不丢的存储区、停机等复位。设备重新铺回试点,同时实验室用压力模式跑(通信频度拉满、按键随机连按——结果:第三天实验室压力机先复现了。钩子留下的名字清清楚楚:显示任务。再看复位前的紧急日志,出事前显示任务刚刷新过一次整屏。
解读前的一个关键复核:检测钩子抓的是"溢出发生",但要定罪还需要"证据链"——为什么显示任务的栈会爆?用栈水位测量工具(它从栈底向高地址扫描填充模式的残留边界,返回"历史最深水位之上有多少字未用")逐任务测量:
/* 启动后跑一段时间再调用水位测量才有意义 */ UBaseType_t w = uxTaskGetStackHighWaterMark(xLcdTask); printf("lcd free-stack-words=%u\r\n", (unsigned)w); /* 单位:字,非字节 */
显示任务的水位只剩个位数——距爆栈一步之遥。打开显示任务的代码找"深潜嫌疑人":局部数组是头号惯犯。果然,整屏刷新函数里躺着一行:
void lcd_full_refresh(void) { char line_buf[LCD_WIDTH * 2 + 8]; /* 局部缓冲,整行像素的文本渲染中间量 */ for (uint8_t row = 0; row < LCD_ROWS; row++) { render_row(row, line_buf); lcd_write_row(row, line_buf); } }
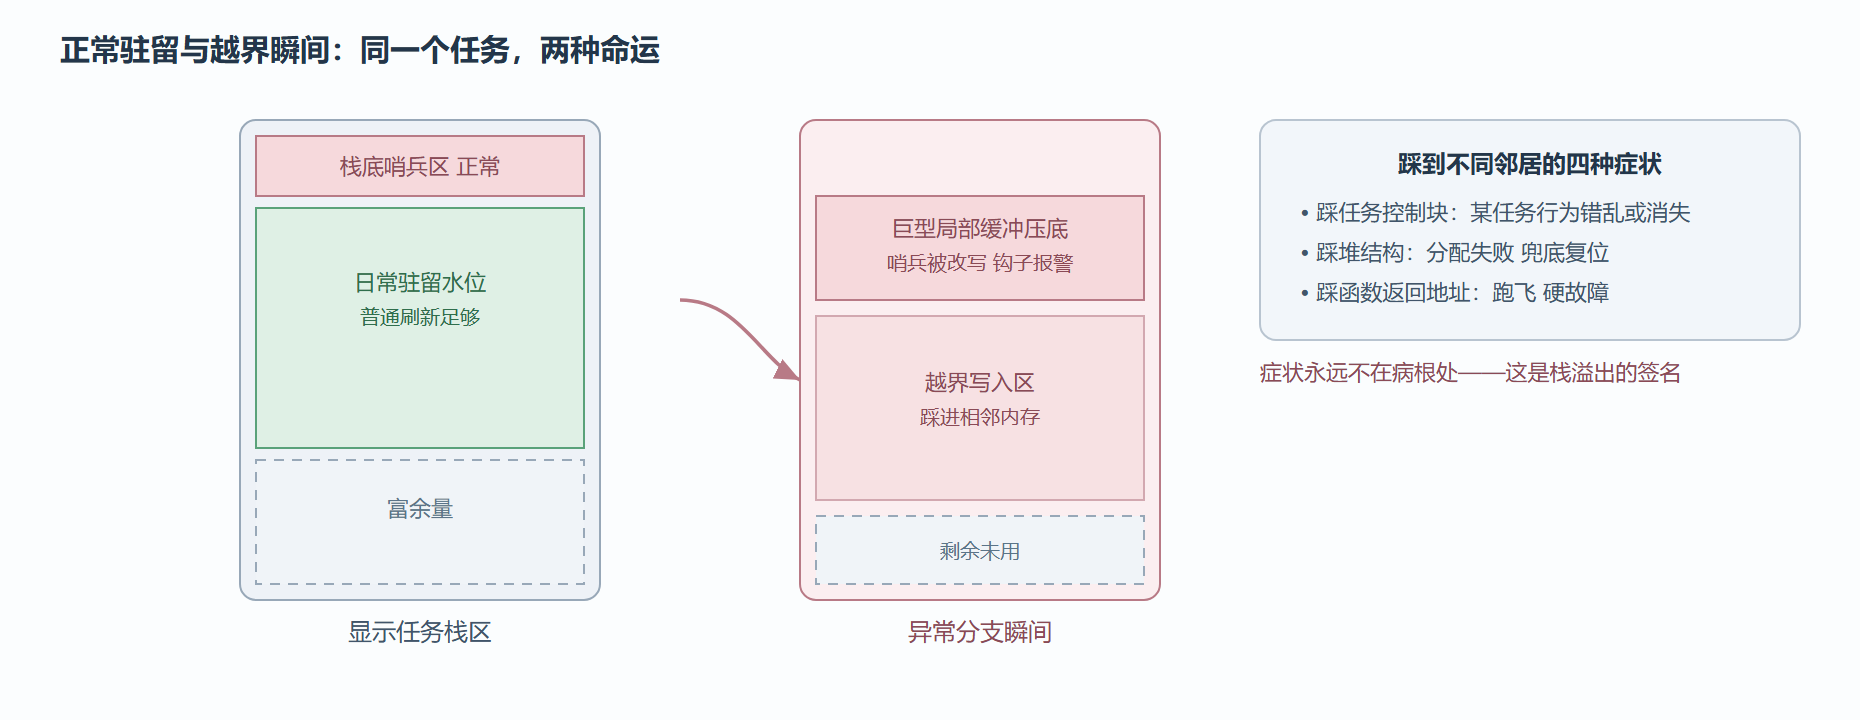
这个缓冲按屏幕宽度分配,占了几百字节的栈——而显示任务的栈本来按"普通任务"的标准配置,只留了很小的余量。平时恰好够用,一旦走到"异常重绘"分支(多一层调用深度),栈顶就越过了栈底,踩进相邻内存。踩到什么看运气:踩到别的任务控制块,那个任务行为错乱;踩到堆管理结构,分配失败路径被触发——这正是兜底复位的来源。偶发、复现难、症状漂移,三个特征全部对上。
溢出踩踏与水位证据
三、修复与变式:一种病因,多种处方
修复给了三张处方,团队最终选了组合拳。处方一:巨型缓冲搬出栈——把行缓冲改为函数外层的静态数组(显示任务独占使用,不存在重入冲突),栈深立减数百字节;处方二:栈配置上加码——显示任务栈深上调并留出至少四分之一余量;处方三:把水位测量做成定期自检——空闲钩子里每小时巡检一次各任务水位,低于阈值就记日志。三张处方分别对应"消除病因、提高裕度、持续监控",缺一不可。
变式把这个案例的边界画出来——同样的排障流程,在这些变体下要换打法:
- 变式一:中断栈溢出。 Cortex-M 上任务用各自的过程栈,中断却共用一条独立的主栈。任务级检测对它完全失明——钩子永远不会响。排查中断栈要用调试器直接监视中断栈区,或启用芯片的栈边界警戒。这是"内核检测不到的溢出"第一类。
- 变式二:切换间隙的快速越界。 两级检测都发生在上下文切换时,一个"深潜后迅速返回"的调用如果两次切换之间完成,二级检测能抓到(扫描历史水位),但若越界写恰好没碰到模式字节,仍会漏网。MPU 栈保护(第 7 章)是终极防线:硬件级、零漏报。
- 变式三:创建即溢出。 任务栈小到第一个函数调用就爆,切换都还没发生过——检测没机会运行。防御靠代码评审盯住"栈深小于最小推荐值"的创建语句。
| 检测手段 | 抓什么 | 漏什么 | 开销 | 建议用法 |
|---|---|---|---|---|
| 一级检测 | 切换时刻的底部越界 | 历史性深潜 | 极小 | 量产保留 |
| 二级检测 | 含历史水位的越界 | 切换间隙快速往返 | 切换时扫描 | 开发与排障期开 |
| 水位测量 | 渐进逼近的趋势 | 瞬时爆栈 | 按需调用 | 定期巡检常驻 |
| 硬件保护 | 一切越界 | 无 | 略降性能 | 安全关键必开 |
解读(方法论沉淀):这张工单从头到尾没有"猜"过一次。复位寄存器排除电源与硬故障、兜底复位代码定位内存异常类别、双级检测指认任务、水位测量定量确认、代码走查找出病因——每一步都把包围圈收窄一格。排障的底气来自工具链的完整,而工具链来自第 1 章基线工程里预埋的那些钩子。如果当时没埋,这张工单的处理周期就不是三天,是三周。
通用排障决策流程
本节要点回顾
- 栈溢出的签名是症状漂移:复位、错乱、分配失败轮流出现,病根永远不在症状处;
- 双级检测原理不同:一级看栈底哨兵、二级扫历史水位;钩子动作要短且不依赖受损内存;
- 定罪要证据链:任务名加水位数值加代码走查,三者闭环才算结案;
- 修复开三张处方:巨型局部量搬出栈、栈深加余量、水位定期巡检;
- 内核检测有盲区:中断栈、切换间隙、创建即爆——硬件级栈保护是终极防线;
- 方法论:不猜,逐步收紧包围圈——复位源、类别、任务、定量、代码,五个格子依次收口。
第 2 章到此收束。你已经知道任务怎么创建、怎么流转、谁裁决、爆了怎么查——但调度器"立刻切换"的那几十纳秒内部发生了什么,还是黑盒。第 3 章开盖:滴答、就绪链表、上下文切换的汇编世界,以及把这一切搬到一颗全新芯片上的完整移植复盘。