1.3 选型对比:llama.cpp 与 Ollama、vLLM、MLC
1.3 选型对比:llama.cpp 与 Ollama、vLLM、MLC
本节摘要:本地推理不是只有 llama.cpp 一条路。Ollama 主打体验,vLLM 主打服务器吞吐,MLC 主打移动端编译。本节用一张对比矩阵和三个真实场景,把四条路线的能力边界画清楚,并给出结论:消费级硬件上要控制力,选 llama.cpp;企业级高并发,选 vLLM;其余按需。
先讲一个反面案例。社区里一位开发者照着 vLLM 教程在自己的笔记本上装环境:装 CUDA 工具链、装 PyTorch、拉数 GB 的依赖,折腾一个晚上,启动时却报显存不足——vLLM 的分页注意力机制为吞吐而生,默认就会预留大量显存块,在 6GB 显存的消费级显卡上连 7B 模型都容纳不下。他最终用 llama.cpp 十分钟跑起了同一个模型。这不是 vLLM 不行,而是工具与场景错位:它假定你有一张 24GB 以上的专业卡,为的是同时服务几十路请求。翻车的原因不在参数,在选型。
本节要解决的问题
把「选型」从玄学变成查表。你读完应当能:对着自己的硬件与需求清单,在一分钟内判断四条路线谁适合你;明白 Ollama 与 llama.cpp 的真实关系(前者是后者的封装发行版之一);知道什么情况下应该毫不犹豫地放弃本地推理改用云接口。
一、四条路线的能力画像
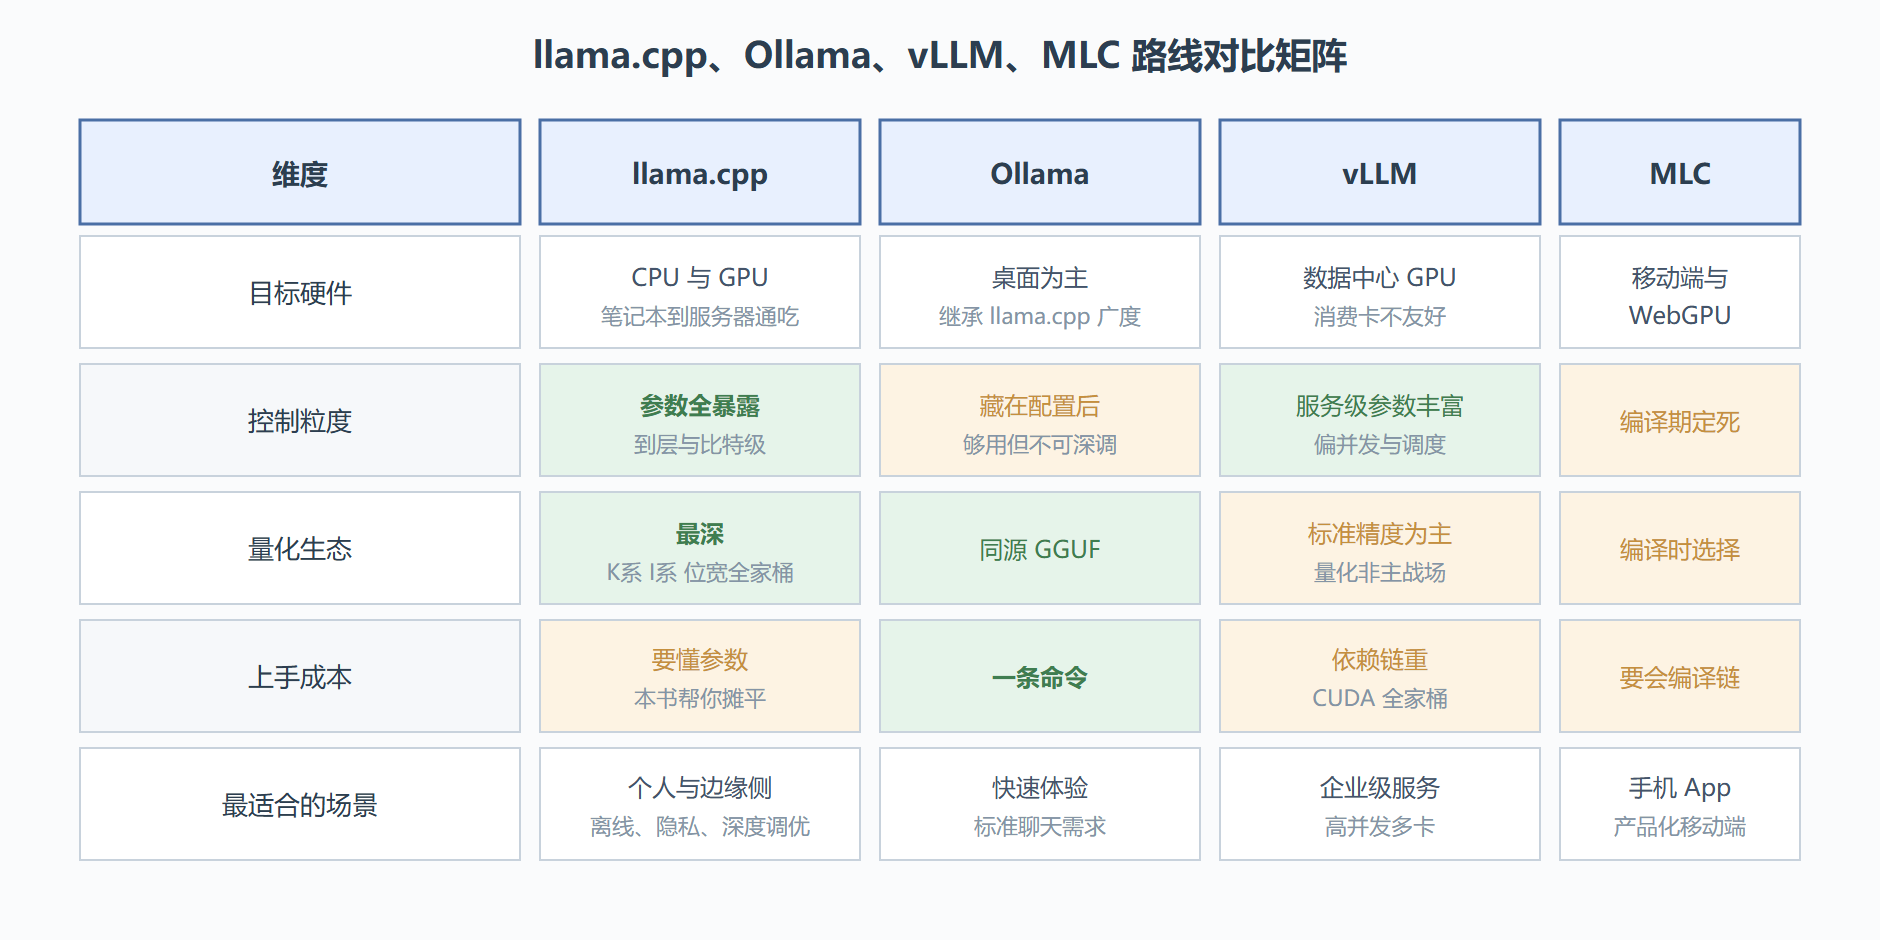
llama.cpp:推理引擎本体。C/C++ 实现,CPU 与 GPU 都能跑,量化生态最深,可编译出命令行工具与本地服务。它的所有能力都暴露成参数,控制粒度到「第几层放显存」;代价是上手需要理解这些参数——这正是本书存在的理由。
Ollama:体验外壳。它把 llama.cpp 编译好、模型源整理好,一条命令拉模型就能聊。适合「先体验、不求细节」的用户。但它隐藏了量化选择、分层策略等关键旋钮,当你需要精细化控制(本书第 5、6 章的实验)时会发现壳太厚。工程上还有一层关系要想清楚:Ollama 的模型格式与 llama.cpp 同源,都是 GGUF,两者可以互通底盘。
vLLM:服务器吞吐王。分页注意力让它能用显存换并发,多卡张量并行成熟,OpenAI 兼容接口完善。前提是硬件配得上:企业级显卡、专业运维。在 6GB 消费卡上,它的默认内存管理策略根本展不开。
MLC(机器学习编译路线):把模型编译成平台原生应用的路线,手机端体验好,能利用移动 GPU。但每换一个模型要重走编译流程,迭代成本高,适合产品化移动端,不适合桌面端的快速实验。
对比矩阵
图 1-2 四条本地推理路线的多维对比
二、三个场景的对号入座
场景一:离线笔记助手,装在自己的旧笔记本上。 数据不出机器是硬需求,硬件是消费级。答案是 llama.cpp:量化模型塞进内存或显存,服务化后接任何前端。Ollama 也能胜任,前提是你接受它给定的默认量化。
场景二:公司内部要给两百个同事提供问答服务。 并发是核心矛盾,一台服务器要同时处理几十路请求。这时 6GB 消费卡没有意义,正确路径是 vLLM 加几张专业卡;llama.cpp 的 server 模式能扛小规模并发(第 7 章),但企业级吞吐不是它的主场。
场景三:把聊天模型装进没有网络的工业平板。 ARM 架构、内存紧张、需要原生 App 交付。MLC 的编译路线对移动 GPU 利用更充分;llama.cpp 在 ARM 上也能编译运行(它的起点就是 MacBook),两者都可行,取决于团队更看重运行时性能还是开发迭代速度。
三、常见问题
有了 Ollama 还需要学 llama.cpp 吗?
需要,如果满足下面任一条件:你想选特定的量化位宽与上下文长度(第 3、6 章);你需要做显存分层实验(第 5 章);你的部署环境装不了 Ollama 的运行时。Ollama 适合用,llama.cpp 适合懂——懂了之后再用 Ollama,你也知道它替你做了什么决定。
llama.cpp 能扛多少并发?
单实例的并发能力受限于 KV 缓存显存与槽位配置,第 7 章实测:6GB 显存下跑 8B Q4 模型,2 到 4 路并发是舒适区。再多就该上 vLLM 或多实例加负载均衡了。
四条路线会互相取代吗?
不会。它们分别压住了「控制」「体验」「吞吐」「移动」四个角,生态位很少重叠。真正会发生的流动是:体验层用户(Ollama)在需求变深后下沉到引擎层(llama.cpp),服务层用户在业务变大后从引擎直连迁到 vLLM。
自查三问
一问:Ollama 与 llama.cpp 是竞争关系吗?答:是外壳与引擎的关系,模型文件同源互通,用外壳体验、用引擎深调是标准路径。二问:vLLM 在 6GB 显卡上翻车的根源是什么?答:它的默认内存策略为大显存高并发设计,消费级卡根本展不开——是场景错配不是工具不行。三问:三秒判断法是哪三个约束?答:显存或内存的硬上限、是否必须离线、并发人数——三个答案基本锁定选型。
一笔隐性账:总拥有成本
选型除了「跑不跑得动」,还要算长期成本。llama.cpp 的成本曲线是「前期陡、后期平」:前几小时在学参数、踩报错(本书把这段摊平了),之后升级维护是低频小事。Ollama 相反,前期十分钟,但一旦需求超出默认参数的覆盖范围,要么接受要么迁出,迁移时格式虽然同源,积累的配置经验却要重学。vLLM 的成本在基础设施:服务器、驱动、运维,人力投入是持续的。MLC 的成本在每次换模型的编译迭代。按三年周期估算,个人与小团队的最低总成本几乎总是落在 llama.cpp 或 Ollama 上;机构级服务则 vLLM 的总账反而最省。这笔记账方式比任何性能跑分都更能解释社区里「各用各的」的现状。
把选型写成一页备忘
本节的决策框架值得固化成一页备忘,下次朋友问「我该用什么」时直接展开:第一行写三个约束(显存或内存上限、离线与否、并发人数);第二行写四条路线各自过不过关;第三行写下结论与主要取舍。这个动作的深层价值在于把「选型判断」从直觉升级为可复查的推理链——结论错了可以回看哪一行的约束写错了。社区里大量选型争论,其实是各方约束不同却共用一张嘴;写下一页备忘,你就同时拥有了立场与体面。
常见问题
混用可以吗?比如开发用 Ollama、上线用 llama.cpp?
可以且常见。模型文件同源互通,开发期用外壳快速迭代,验证后把参数清单搬到引擎层固化——本书教的就是那套「搬得过去」的参数语言。
云接口那么便宜,还有必要本地化吗?
按用量算账本,云接口确实便宜;但有三类需求是价格覆盖不了的:数据不能出内网的合规约束、网络不可用的离线场景、以及想深度定制推理行为的产品需求。命中任一,本地化就不是可选项而是必选项。
MLC 的编译路线会不会才是未来?
移动端产品化场景它确实领先。但「每换一个模型重走编译」的迭代成本,让它在快速演进的通用场景里吃亏。两条路线服务的节奏不同:一个求极致的端上体验,一个求即时的模型跟进——节奏匹配比技术优劣更决定选择。
带走的要点
- 选型先看约束再看功能:显存大小、离线与否、并发规模,三个约束基本锁定答案;
- Ollama 与 llama.cpp 同底盘:模型互通,外壳与引擎的关系,不是竞争关系;
- vLLM 的翻车几乎都发生在消费级硬件上:它的默认策略为服务器而生;
- 本书的立场:以 llama.cpp 为轴,其余路线作为你未来扩展时的参照系。
主线继续推进:工具选定后,第 2 章拆开那个你即将反复打交道的文件——GGUF。