4.3 llama-cli 首航:参数逐条拆解与生成调优
4.3 llama-cli 首航:参数逐条拆解与生成调优
本节摘要:一条最短命令就能跑通推理,但读懂十来个核心参数才算真会用了。本节从最小参数组合起步,先解剖一次推理的完整生命周期,再逐条拆解高频参数——每个都给出「改了会怎样」的行为对照。这一节是第 5、6 章调参实验的操作基础。
跑通只是开始
4.2 节的三关校验里已经偷偷跑过推理了。现在把参数摊开讲透——首航的目标不是「能出字」,而是建立参数与行为之间的因果直觉。这份直觉比任何参数表都值钱:第 6 章的采样实验、第 7 章的服务化,全靠它支撑。
一、一次推理的完整生命周期
按下回车之后,程序里发生了什么?拆成七步看:
图 4-2 一次推理请求的生命周期:预填充与生成两阶段
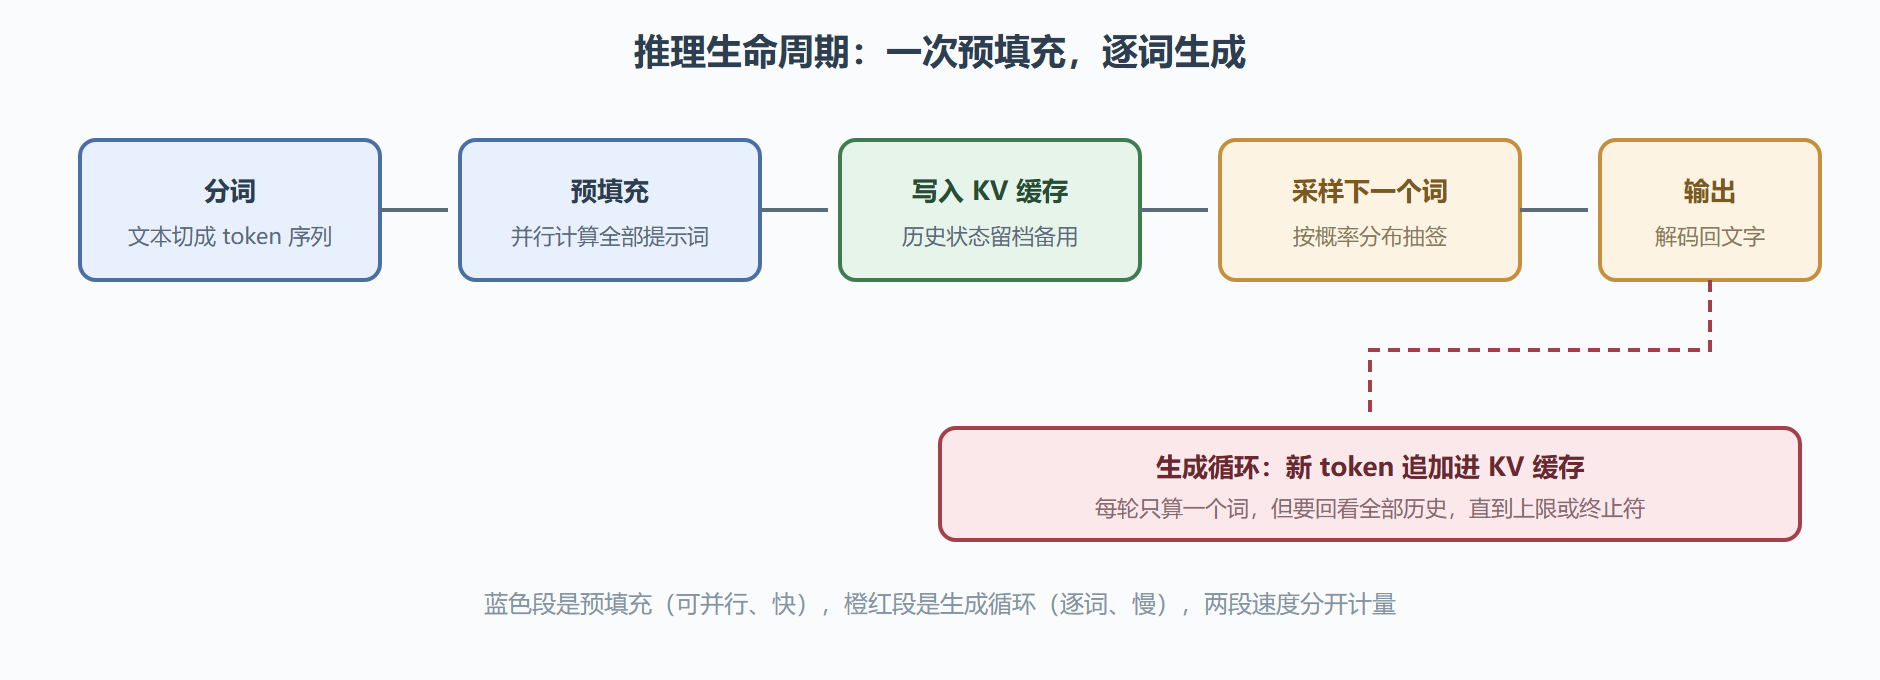
理解这张图,两个速度指标就有了物理意义:预填充快是因为整段提示词并行计算,速度取决于算力;生成慢是因为每个词都要回看全部历史,速度取决于内存或显存带宽。第 5 章的分层实验之所以对两段速度区别对待,根源就在这里。
二、最小组合与逐参数拆解
最短可跑命令只有两个参数:
llama-cli -m qwen2.5-7b-instruct-q4_k_m.gguf -p "给我三个周末去处的点子"
但默认值未必合身。高频参数按「模型与硬件、长度、质量」三组拆解:
| 参数 | 作用 | 不调会怎样 |
|---|---|---|
| -ngl | 卸载进显存的层数,99 表示全部 | 不给则纯 CPU,速度差数倍 |
| -c | 上下文窗口 token 数 | 默认偏小,长对话被截断记忆 |
| -n | 单轮生成上限 | 默认可能中途截断长回答 |
| --temp | 采样温度,低则保守高则发散 | 写代码用 0.2,闲聊用 0.8 |
| --top-p | 核采样截断累积概率 | 配合温度控制胡言乱语概率 |
| --repeat-penalty | 重复惩罚 | 长回答容易绕圈复读 |
| --seed | 随机种子,固定则可复现 | 排错时无法复现怪输出 |
| -no-cnv | 关闭交互,答完即退 | 脚本场景挂起等输入 |
一份把上述参数全部用上的「日常模板」,建议原样存下来作为个人基线:
# 日常基线模板:聊天场景,可复现性留有余地 llama-cli -m qwen2.5-7b-instruct-q4_k_m.gguf \ -ngl 99 -c 4096 \ --temp 0.7 --top-p 0.9 --repeat-penalty 1.1 \ -n 1024 --seed 42
三、交互模式与系统提示
不带 -no-cnv 时程序进入交互模式:你的输入持续追加进上下文,模型带着记忆连续对话,直到 token 数逼近 -c 上限。两个实用细节:其一,对话开头的系统提示决定模型的角色与风格,命令行的交互模式支持用参数文件方式注入,把「你是严谨的技术顾问」这类设定写进文件比每次敲一遍体面;其二,上下文满了之后最早的记忆会被挤出窗口,模型会「忘事」——这不是故障,是窗口机制本身,第 6 章讲压缩与扩展时再细拆。
四、常见问题
输出中途断掉是 bug 吗?
先查 -n:单轮生成上限到了就会戛然而止。再查 -c:上下文装不下「历史加新回答」时,新内容会被截断。两者都与模型能力无关。
同样的命令每次回答不一样?
正常。采样带随机性,固定 --seed 即可复现。排错的标准姿势就是固定种子、最小化参数,把变量一个个加回来定位问题。
提示词很长时卡一下才开吐字?
那不是卡顿,是预填充在工作。几百上千 token 的提示词需要先并行算完写进缓存,这段耗时与提示长度成正比。日志里的 prompt processing time 就是这段耗时,长文档问答场景它才是主要等待成本。
启动日志逐行精读
首航的启动日志信息密度极高,值得逐段拆解。系统信息段:开头几行报告构建版本与编译开关,排错时先核对自己跑的是哪个后端哪个版本。设备探测段:列出可用计算设备与显存,显卡没出现在这里,后面的卸载必然落空——驱动或运行时问题在此暴露。加载段:词表与架构元数据逐项载入,随后是第 5 章要精算的缓冲大小行。分层段:offloaded 行数与总层数,这是你 -ngl 参数的直接回执。预热段:首次推理前的计算图构建与预热计时,冷启动慢在这里,属正常现象。养成「启动先读日志」的习惯,4.4 节的六大翻车现场有一半能在日志里提前看到征兆。
自查三问
一问:为什么生成速度远低于预填充速度?答:预填充整段并行算,生成逐词走且每词回看全部历史,瓶颈在搬运不在计算。二问:-c 设多大才算「够」?答:最长一次输入加最长一次输出,再乘一点二留余量——超出需求的窗口只是白付的显存房租。三问:改了参数行为没变化,先查什么?答:先查日志回执确认参数生效(层层数、窗口值都有回执行),再怀疑参数语义——静默回退是新手最大的迷惑源。
提示词工程的最小集
参数之外,提示词本身的两个基本功对本地模型尤其重要。系统提示要短而硬:本地小模型的注意力资源有限,冗长的角色设定反而稀释指令权重,三句话内说清角色、格式与禁区效果最好。示例比描述有效:想让输出固定为某种结构,直接给一个输入输出示例,比一段格式描述可靠得多——这与云端大模型的提示词习惯略有差异,根源是小模型更依赖模式匹配而非指令泛化。
常见问题
参数写错会报错吗?
多数参数有默认值且宽容,写错常见结果是「静默回退」而不是报错——比如层数超界自动收敛到最大值。所以关键参数要对照日志回执确认生效,不能只凭「没报错就是对的」。
批处理大小这类参数需要动吗?
默认值已按多数硬件调优,动它的收益集中在预填充吞吐的极限压榨上。日常使用不必碰,第 7 章服务化的并发配置会涉及它的服务侧版本。
同样参数在别人机器上行为不同?
先查三件事:模型文件是否同一份(哈希)、引擎版本是否相近、采样种子是否一致。三件对齐后行为应可复现;仍不同,多半是文档里没写的环境差异,这正是实验志记录基线的原因。
首航日的十五分钟验收
参数讲完,给首航日一个可执行的验收流程:第一分钟,跑最小命令确认能出字;第五分钟,对照日志逐行核对层卸载与窗口回执;第八分钟,用固定种子跑同一提示两次,确认输出一致;第十二分钟,把温度从 0.2 拨到 1.0 再跑一次,亲眼看分布塑形对文风的影响;第十五分钟,把这次的完整命令与日志存成「首航卡」。十五分钟做完,你对这台机器的第一次系统性认识就建立了——第 5 章的一切调优,都将基于这张首航卡的基线展开。
参数的记忆法
与其背参数表,不如记三个「锚点问题」。问容量:这次输入有多长、输出要多长——对应 -c 与 -n。问场地:模型放哪算——对应 -ngl 与显存账本。问性格:回答要稳还是要活——对应温度、截断与惩罚。三个问题按顺序自问一遍,参数就齐了。这套记忆法的副产品是排错直觉:输出异常时同样按三问回查——容量不够会截断、场地不对会变慢、性格不合会胡言,症状与参数的对应关系从此不再是散点。
本节要点回顾
- 生命周期两段论:并行预填充加逐词生成,两段速度分开计量、瓶颈不同;
- 参数按三组记:模型硬件组(ngl、c)、长度组(n、c)、质量组(temp、top-p、惩罚);
- 存一份个人基线模板:参数齐备、可复现,后续实验都在它上面改;
- 「忘事」与「断尾」都有明确机制:窗口挤出与上限截断,不是 bug;
- 首航顺利则直接进第 5 章;若中途翻车,下一节的排错手册正候着。