4.3 一次在线扩容全程复盘
4.3 一次在线扩容全程复盘
本节摘要:扩容是 MinIO 运维里最考验"模型是否真懂"的动作:做对了一小时内完成且业务无感,做错了轻则水位失控、重则旧池数据悬空。本节复盘一次真实的双池扩容,从告警触发到 decommission 收尾,每个动作都标注当时的判断依据。
复盘的起点:一封水位告警
视频监控项目接入 MinIO 一年半后,告警平台报出:主池(四节点 16 盘,可用 45 TB)水位爬到 82%,按近三个月的写入斜率,十周后触顶。这是 4.1 模型的一次实战检验:容量规划的对象是池,触顶的是池,需要扩的也是池。复盘从这里开始,到旧池退役为止——一次完整的"扩仓"生命周期。
第一步:规划纸上的三个决定
决定一:新建池,拒绝往老池塞盘。 老池的 16 盘纠删集已定型,物理上加盘既不生效也不被模型支持——盘的集合在建池时锁定。这条红线的来历 4.1 讲过,不再赘述。
决定二:新池与老池同规格。 四节点、每节点四块 16T 盘、EC 10+6,与老池完全一致。规格一致的意义在多池运维里会兑现:监控阈值、坏盘剧本、巡检脚本全部复用,值班工程师不需要为第二个池学一套新规则。
决定三:一次性备足三年增量。 按写入斜率外推三年约需 110 TB 可用容量。当初老池规划两年就已经告急,这次把外推周期拉长到三年,多花的钱远低于一次扩容项目的工程成本——硬件可以折旧,工程师的时间不能。
第二步:施工窗口内的动作序列
新机器到货后,按第 2 章的部署纪律完成 minio-5 到 minio-8 的系统准备:主机名、hosts、四盘 XFS 直通挂载、环境变量文件。然后是关键的扩容动作——把新池写进所有八台机器的启动配置:
# /etc/default/minio —— 八台机器完全一致(差异部分省略凭证行) MINIO_VOLUMES="http://minio-{1...4}/data/minio{1...4} http://minio-{5...8}/data/minio{1...4}" MINIO_OPTS="--console-address :9001"
两个池的地址串用空格拼接在同一个变量里。这是扩容唯一的"手术动作",但生效方式是保守的滚动重启:逐台执行 systemctl restart minio,每台之间观察集群健康与业务指标。因为 3.3 的双仲裁机制,任意时刻只有一台节点在重启,读写仲裁始终有足够分片,业务全程无感——这正是"在线"扩容的含义:不在线的是升级动作,不是服务。
滚动重启完成后的验收清单:
# 集群信息:两个池都在线,盘数 32,无 offline mc admin info fleet # 关键验收:老数据仍可读、新写入开始落新池 mc cp ./verify-1gb.bin fleet/resize-check/test-after.txt mc stat fleet/resize-check/test-after.txt
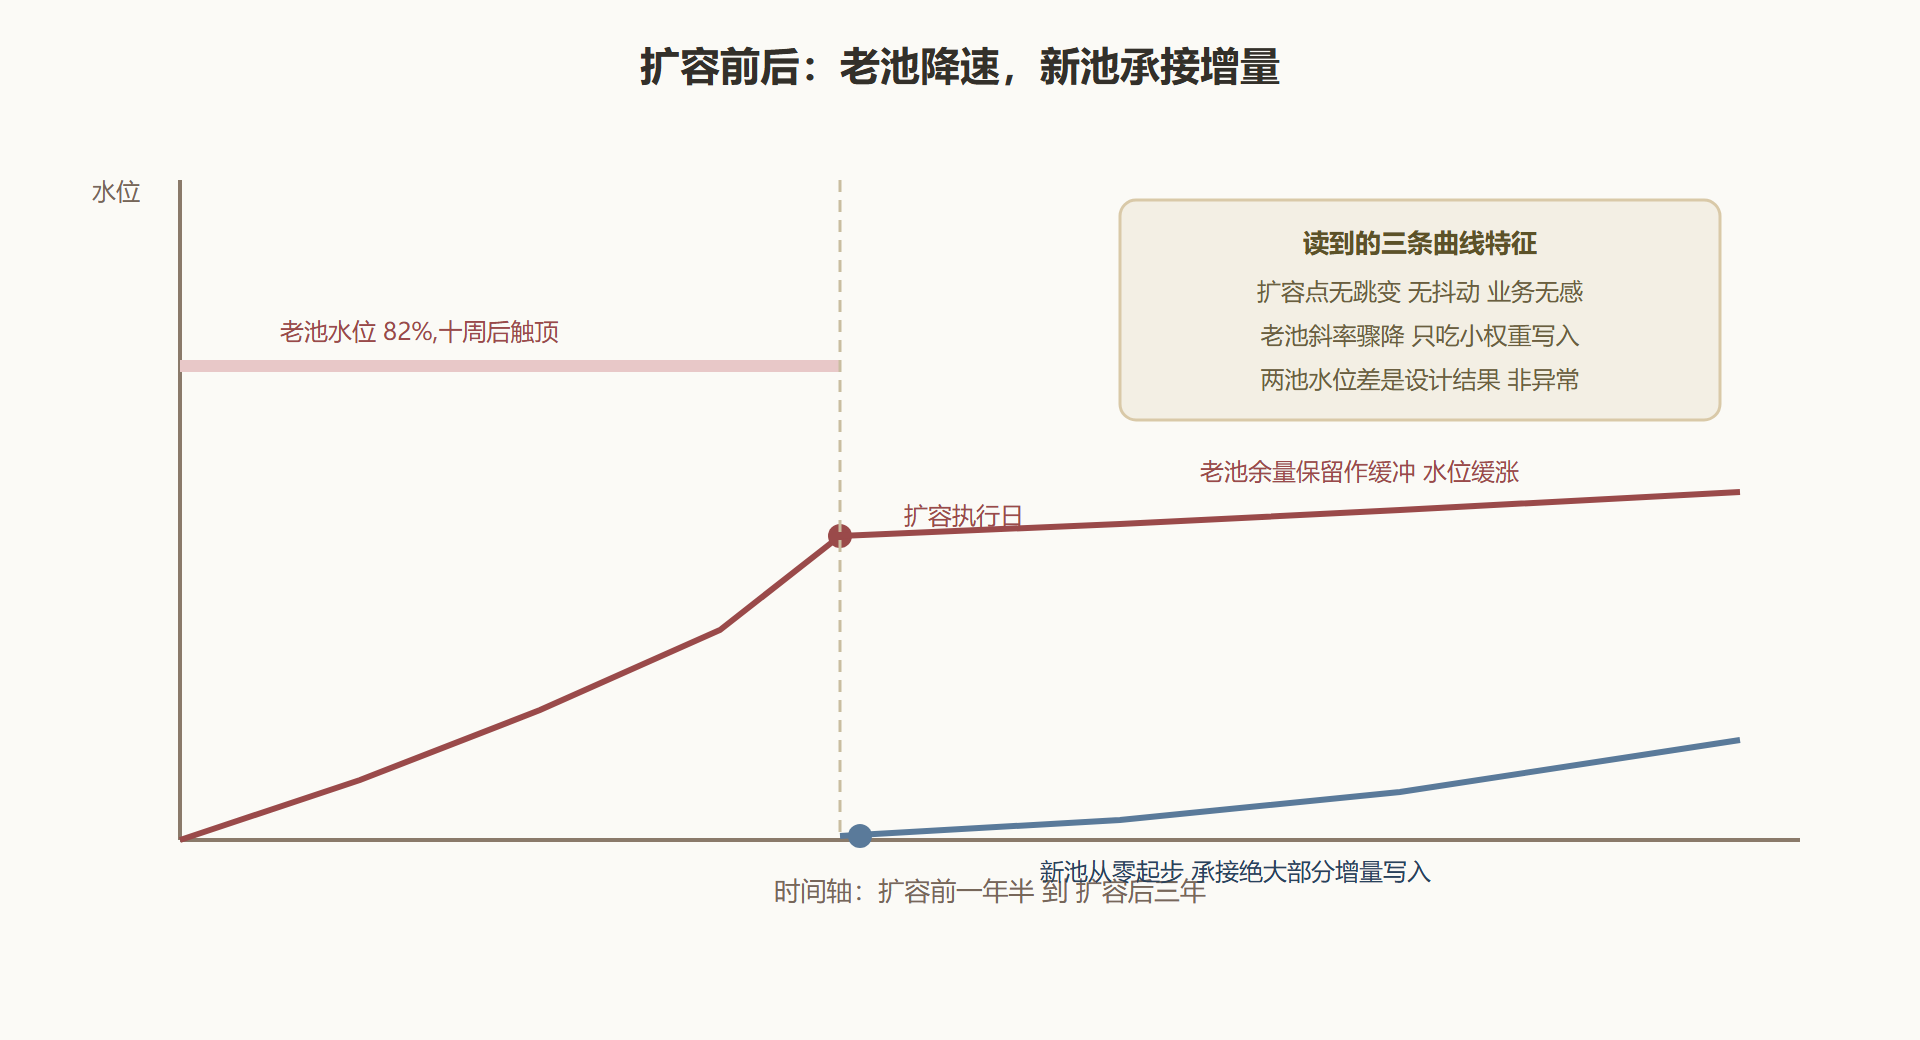
验收的隐藏重点在第二条:写入测试对象后,检查它实际落在哪个池(stat 输出中的分片位置)。由于新池剩余空间大、加权高,新对象应当集中落新池——这正是设计行为,不是数据被重平衡了。
图 4-3 扩容前后的水位走势与新池承接
第三步:结果的核对口径
扩容后第一个月的月度巡检,核对三件事:其一,集群总可用容量翻倍,两池 health 全绿;其二,写入流量分布符合加权预期,新池承接了绝大部分新增对象;其三,老池水位如预期缓慢爬升——它仍在接收小比例写入,只是不再背主力负载。三件都对上,扩容才算收尾。
第四步:老池退役(decommission)
第二年,老池的硬件到保修期,公司决定整体换新。这时才用到本章真正的重头戏——让老池把数据完整交给新池:
# 发起退役:指定要退出的池的地址串 mc admin decommission start fleet http://minio-{1...4}/data/minio{1...4} # 查看进度:对象数与字节数的搬运进度条 mc admin decommission status fleet # 全部数据搬移完成且校验通过后,老池进入可摘除状态 # 更新 MINIO_VOLUMES 只保留新池,滚动重启,再物理下线老机器
退役动作的三个注意点,每一条都是别人踩过的坑:先跑一遍 heal——带伤的分片会让搬移反复重试;避开业务高峰——搬移的读流量与业务共享网卡;搬完先验证再断电——status 报告完成后,抽检老池上的对象在新池可读、校验一致,再更新配置摘除。整个退役在一个季度内从容完成,旧机器带着完整数据副本离场,任何一步可回退。
解读与变式
解读:这次复盘里最贵的认知是"扩容的所有难点都在规划纸,不在命令行"。命令只有两段:改配置滚动重启、decommission 三连。真正保平安的是规格一致的决定、三年外推的容量观、"先演习后动刀"的退役纪律——4.1 的模型理解转化为规划习惯,就是这个过程。
变式一:小步快扩。若预算不允许一次备三年,可以按年扩池,但每次仍是同规格新建,绝不要为省钱缩小新池规格——不一致的池会让纠删集容量、监控水位、故障剧本全部碎片化。
变式二:机房级扩容。若新池放在另一个机房,跨机房链路延迟会改变写入路由的表现(延迟敏感场景建议主备而非双活),并与 5.4 的站点复制联动设计——那是另一个量级的规划题。
本节要点回顾
- 扩容单位是池:改配置、滚动重启、验收双池,在线完成且业务无感。
- 新池承接增量是设计行为:水位差不是异常,别期待也不需要"重平衡"。
- decommission 是正式变更:先 heal、避高峰、验完再摘除,数据跟着流程走而不是跟着运气走。
- 规划纸比命令贵:同规格、三年外推、退役窗口,三个决定决定成败。
仓会长大,粮会变老。第 5 章转向时间维度:版本、生命周期、锁定与复制——粮食的岁月管理。
扩容四段检查单
复盘的完整流程折叠成一张检查单,直接可用于变更评审:
| 阶段 | 必查项 | 完成标志 |
|---|---|---|
| 规划 | 池规格同构、容量外推、退役年限 | 评审通过的规划纸 |
| 施工 | 盘位核对、配置八机一致、滚动重启 | 管理命令显示双池全在线 |
| 验收 | 测试对象落新池、老数据抽读、监控无异常 | 验收记录归档 |
| 退役 | 先 heal、decommission 进度盯守、抽验后摘除 | 老池数据完整迁出并下线 |
变式三:按桶迁移的轻量路径。 若需求只是"把某几个桶挪到新硬件",不必动池——mc mirror 加生命周期切换的组合(先镜像、双写、切读、旧桶到期下线)能在桶粒度完成搬迁,代价为零风险。池级扩容与桶级迁移各有领地:前者解决容量,后者解决归属。
复盘讲到这里,4 章的三节形成一个闭环:4.1 给模型,4.2 给地基,4.3 给施工。下次容量告警响起时,你应该已经知道第一张要写的纸是什么——不是采购申请,是规划纸。