4.4 缓存与离线安装对照实验
4.4 缓存与离线安装对照实验
本节摘要:缓存是安装性能的第一杠杆,也是离线安装与供给固化的物理基础。本节亲手做一组对照实验:同一项目在缓存命中、缓存未命中、离线三种条件下的安装时长与行为差异;随后勘验两种工具缓存结构的差异,并讨论缓存校验为何不可跳过。读完你会拿到一组自己机器上的真实数字,以及"缓存该信任到什么程度"的判断依据。
实验设计:三组对照
实验环境越干净,结论越可信。设计三组条件,每组安装前把依赖目录清空,保证测的是完整安装而非增量更新:
A 组 热缓存: 缓存目录保留,网络可用,预期大部分包命中缓存 B 组 冷缓存: 缓存目录清空,网络可用,预期全程远端下载 C 组 离线: 缓存目录保留,断网安装,测试缓存能否独立支撑安装
记录指标有三个:总时长、网络请求数(有条件就用代理日志统计,没有就靠输出里的 fetch 字样估算)、安装结果(成功或失败)。三个指标合起来才能回答"缓存在替我们做什么"。
动手跑实验
先跑 A 组热缓存:
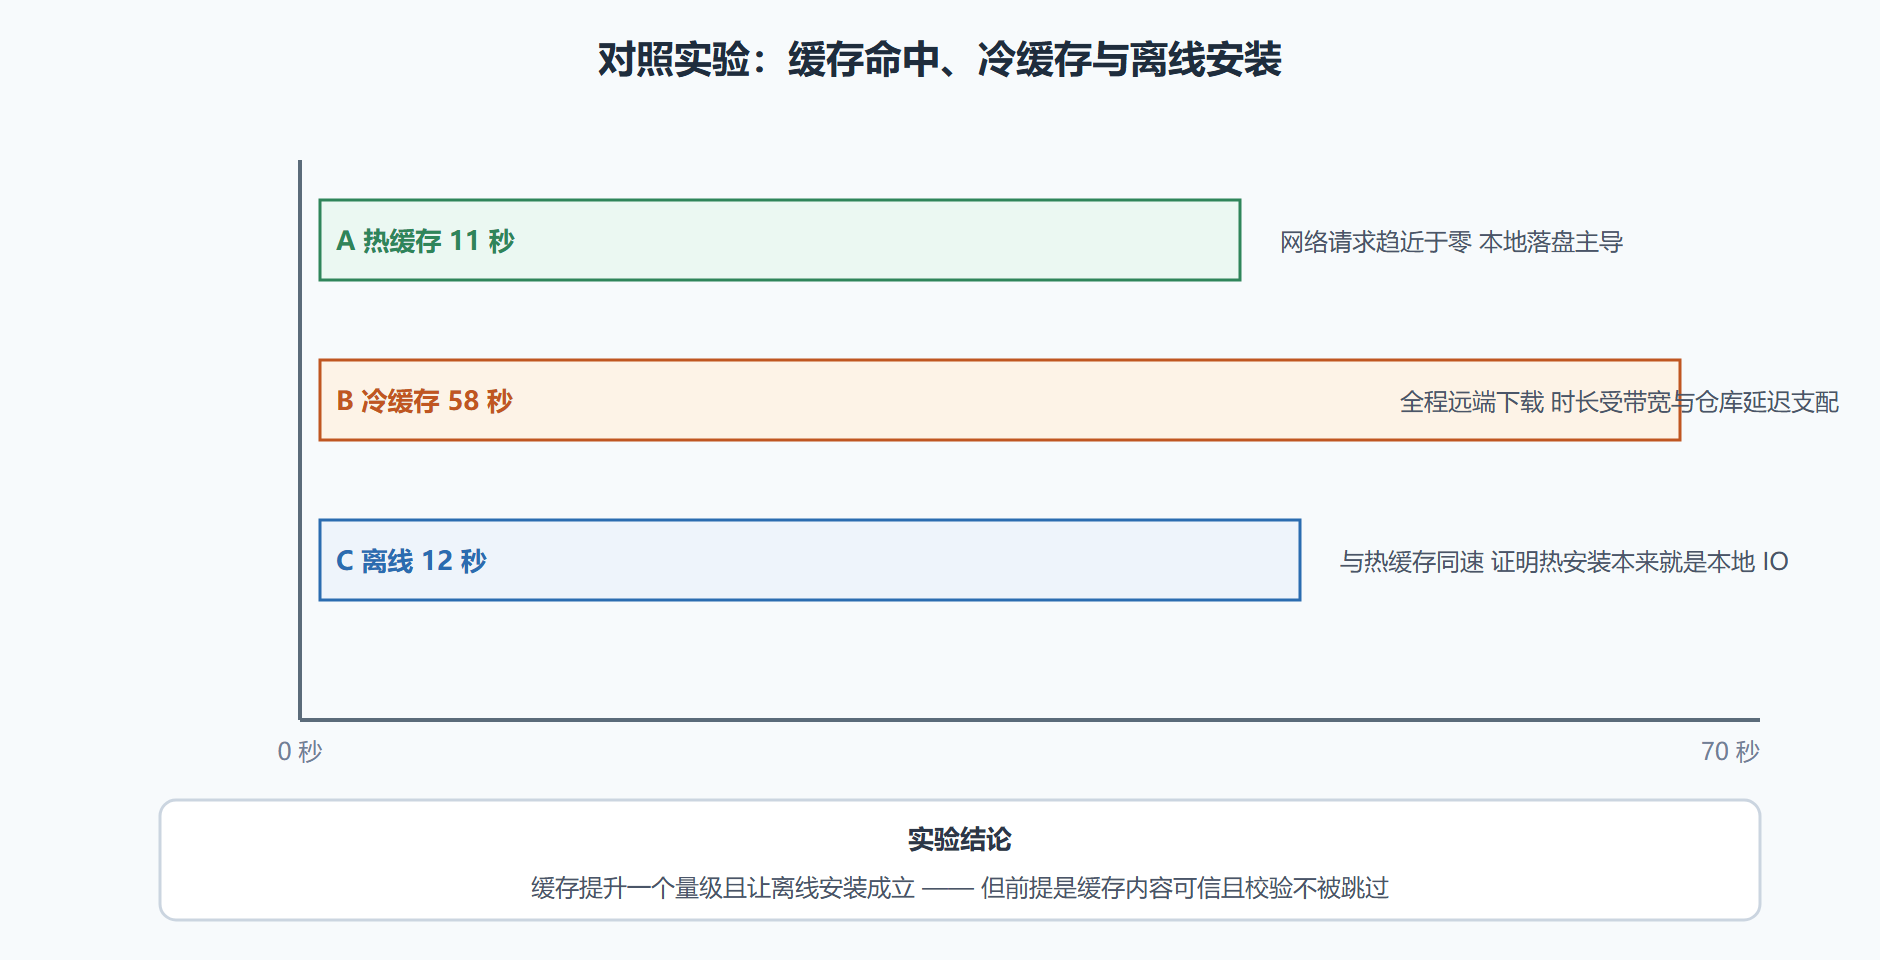
$ npm ci added 1187 packages in 11s # 再跑 B 组:清缓存后安装 $ npm cache clean --force $ npm ci removed 1204 packages in 6s # ci 先清依赖目录 added 1187 packages in 58s # 全程远端,慢了一个量级 # 最后 C 组:恢复缓存 断网安装 $ npm ci --offline added 1187 packages in 12s # 与热缓存几乎同速
一组典型的结果:冷缓存约一分钟,热缓存与离线都在十秒上下。缓存把安装提速了一个量级,且热缓存与离线的速度几乎相同——这说明热缓存的安装时间本来就花在本地 IO 上,网络只是被绕过了,不是被压缩了。同时注意 B 组清缓存命令输出的那个 removed 数字:缓存里躺着一千多个包的副本,跨项目复用正是缓存的价值来源——你机器上每个项目都在为其他项目预热缓存。
图 4-4 三组实验的时长对照与结论
缓存结构勘验:两家工具的两条路线
同是缓存,内部组织差别不小。Npm 的缓存以"内容寻址"为核心:每个包压缩包按其哈希存储,目录名就是内容指纹,命中判定就是哈希匹配——内容不对根本不会命中。Yarn 一代的缓存按包名加版本组织,语义直观;Yarn 二代则把缓存目录收进项目内、随仓库走(可选零安装模式直接把缓存提交进版本库),把"缓存"从机器私有资源变成了项目资产。
两种组织的工程含义不同,值得各记一条:内容寻址让缓存天然抗篡改与去重(同内容只存一份),但人类不可读;项目内缓存让新成员克隆即有完整依赖、真正离线可用,代价是仓库体积膨胀。第七章横评里,缓存路线会作为"工具哲学差异"的一个切片再次出现。
# 缓存健康自检 $ npm cache verify # 输出:校验缓存完整性 压缩与索引统计 —— 定期跑一次当体检
缓存校验:为什么这行参数永远别关
实验里有个细节没有展开:命中缓存的包还要不要校验完整性?答案是要,而且永远要。理由在威胁模型里:缓存目录是本机所有项目共享的可写目录,一旦有恶意程序或其他项目的依赖污染了缓存,后续所有项目的安装都会"命中"被污染的内容。完整性校验是这条污染链上唯一的断点——它让缓存从"信任源"降级为"加速层":命中只是省去下载,信任仍由锁文件里的哈希说了算。
缓存可信的前提是校验在场。跳过校验换来的那点提速,买不回一次缓存投毒的损失——这不是权衡题,是免费的安全。
工程上的对应纪律:流水线的缓存配置(各种构建平台的缓存机制)只缓存包管理器的正规缓存目录,不要自建"加速目录"绕过安装器的校验;发现缓存行为异常时,清空重建缓存永远优于诊断缓存——重建成本以分钟计,污染排查以天计。
离线安装:性能话题的另一面
实验的 C 组其实打开了一扇更大的门:离线安装不仅是断网应急,它是三件正经事的共同基础——内网环境交付(生产环境禁止外网访问时,离线包是唯一正解)、供给固化(把依赖快照固定下来,远端撤版不影响重放,呼应 3.2 节)、新成员加速(项目内缓存或离线镜像让首次安装不再依赖外网)。第六章 6.3 的私有源部署会把这件事做成完整方案,本节的实验数据就是那个方案的收益证明。
实验的科学性:误差控制与参数辨析
自己动手做这组实验时,有三个变量要控制住,否则结论会被噪声淹没。其一:网络抖动。 冷缓存组全程走网络,单次测量的波动可能高达三成以上——每组至少重复三次取中位数,是这类微基准的最低纪律。其二:磁盘类型。 机械盘与固态盘的落盘耗时会差出一个量级,而热缓存组的成绩几乎完全由磁盘决定——对比必须同机同盘,跨机器比较毫无意义。其三:系统级预热。 首次安装后操作系统的文件缓存已经热了,第二遍天然更快——严谨的做法是每组之间清掉包管理器自己的缓存即可,系统级缓存的影响两组均摊,不必刻意清除。
另有两个容易混淆的参数值得辨析:偏好离线与强制离线。前者允许缓存未命中时回源下载,后者严格禁止任何网络访问、缓存不齐直接失败。日常开发用前者,流水线与内网交付用后者——一个求顺手,一个求严格,语义差别正是使用场景的差别。
把实验结论变成团队配置
数字要落到配置才算收益。三处配置直接消费本节结论。流水线缓存:包管理器缓存目录接入构建平台缓存,缓存键绑定锁文件哈希——锁一变缓存自动失效,既新鲜又命中。本地开发:日常安装启用偏好离线语义,命中即离线、未命中回源——把 A 组的体验变成日常默认。私源叠加:6.3 节的私有源在本节结论之上再叠一层——组织内所有项目共享同一份预热缓存,冷缓存组(B 组)的成本从"个人重复支付"变成"组织支付一次"。三层配置合起来,安装耗时的长期曲线应该是一条持续下移的斜线;如果曲线不动,回头检查是哪一层没配到位。
本节要点回顾
- 实验结论:缓存把安装提速一个量级;热缓存与离线同速,说明热安装的主导成本是本地 IO;
- 缓存是跨项目公共品:每个项目都在为其他项目预热,冷缓存的代价全队共同摊还;
- 两条缓存路线:内容寻址(抗篡改去重)与项目内缓存(离线即开箱),工具哲学在此分岔;
- 校验不可跳过:缓存是共享可写目录,完整性校验是污染链唯一断点,跳过校验省的时间买不回安全;
- 离线安装三用途:内网交付、供给固化、新成员加速——性能实验的尽头是供应链工程。
第四章流水线至此走完。第五章转向规模问题:当一个仓库里装着多个互相依赖的包,流水线、布局与锁文件会变成什么形态——工作区与 Monorepo 的完整实战。