- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
Npm与Yarn包管理机制 · 教程导读
"把 node_modules 删了重装就好了。"——前端圈流传最广的一句行话。它听起来像玩笑,其实是一份集体诊断书:说这话的人默认了两件事——依赖目录是个没人看得懂的黑盒,安装结果本身不可信。这门课要做的,就是把这台黑盒机器当众拆开:依赖到底怎么解析的,目录为什么长这样,锁文件里那些哈希串是干什么用的,postinstall 脚本在哪个瞬间被执行,缓存又藏在哪。拆完之后,"重装就好了"这五个字就不再是咒语,而是一条可以被解释、被预防、被审计的工程判断。
为什么值得把机器拆开
包管理器在日常开发里存在感极低——低到大多数人只会敲 install。可一旦它出问题,代价往往以天计:同事机器上能跑、CI 上必挂;合并一次代码,锁文件冲突几百行;随手装了一个小工具包,整条流水线的凭据被人顺走。这些事故的共同点是:表层症状千奇百怪,根因都落在同几处机制上——依赖解析算法、锁文件结构、提升策略、生命周期脚本、缓存与完整性校验。把机制看透一遍,八成的事故就能在发生前被识别。
本教程不打算罗列命令参数。市面上不缺命令速查表,缺的是把"为什么"讲清楚的材料:为什么扁平化解决了磁盘问题却制造了幽灵依赖;为什么锁文件冲突几乎总在版本范围处爆发;为什么 npm ci 在流水线里比 install 更受青睐。每个"为什么"背后都是一条可迁移的判断力,换工具、换语言时依然管用。
这门课的叙事主调:锁文件勘验室
全册采用「锁文件勘验室」的写法——每一节都从一段真实现场起步:一次安装的完整输出、一段锁文件的原始片段、一条报错信息、一次合并冲突的 diff。先摆证物,再动手勘验:逐行读输出,指出哪一行对应哪个内部机制;给出处置动作,并说明这个动作改动了机器的哪个部件;最后推演变式——条件变了,结论怎么跟着变。你可以把每一节当成一份勘验笔录来读,也可以照着命令在自己机器上把现场复原一遍,两种读法都成立。
全册的行进路线
全书七章,按"先建全局观,再逐层下钻,最后回到选型"的顺序排布。第一章铺历史与格局:Npm 从何而来、Yarn 为什么出现、竞争如何把整个生态的水位抬高。第二章钻进依赖解析与 node_modules 的物理布局,幽灵依赖的成因将在这一章现出原形。第三章是全册的重心——锁文件:它的结构、生成与校验时机,以及冲突排错和可复现安装两场实战。第四章沿安装流水线走完全程:从预检到生命周期脚本,再到二进制编译与缓存实验。第五章处理规模问题:工作区、Monorepo 与 Yarn 的免安装实验。第六章转到攻防与效能:供应链安全、审计、性能优化与企业私有源。第七章收束全局,给出 Npm、Yarn、pnpm 的横向评测与迁移路线。
图 0-1 全册知识地图:章节依赖与行进顺序
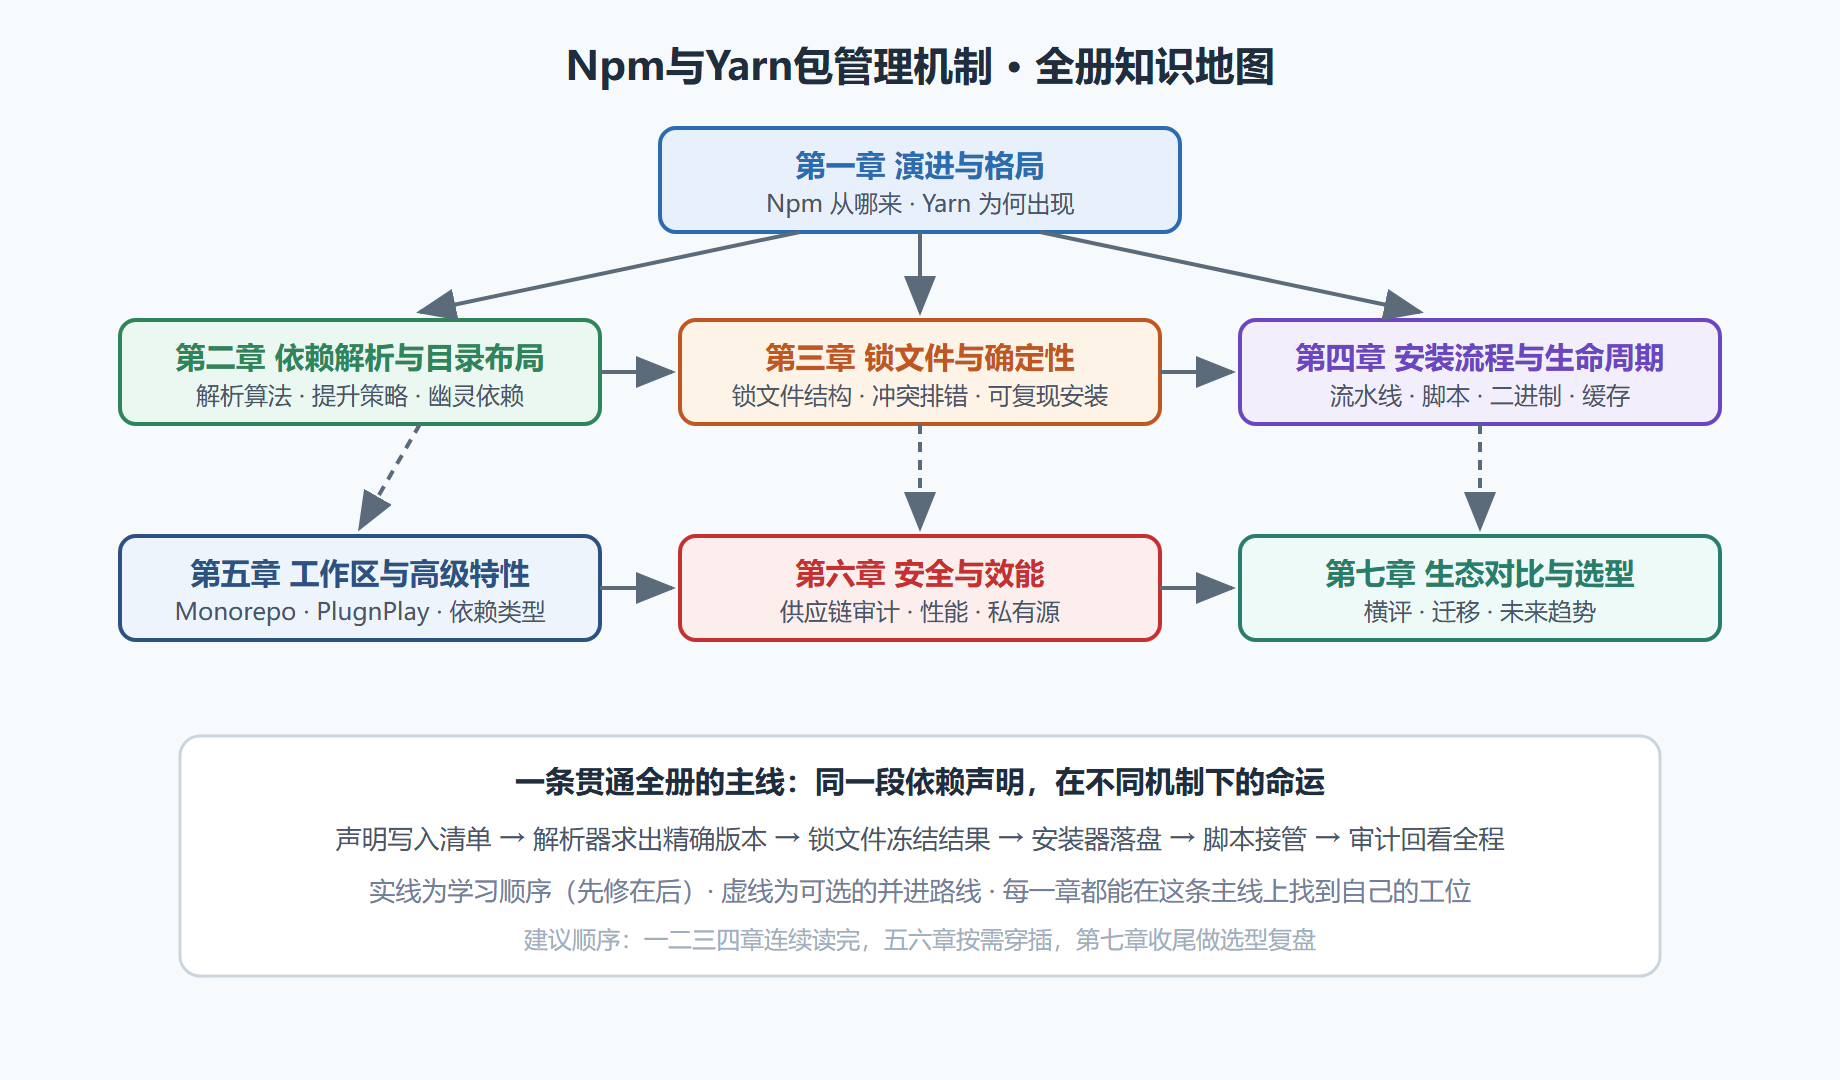
读图要点:主线一行是全册的骨架句。任何一次 npm install 或 yarn add,都在重演这条链路——清单、解析、冻结、落盘、脚本、审计。后续每章只是把链路上的一环放到显微镜下。
读完你会带走什么
到最后一章收尾时,你应当能独立完成这些事:读懂一段锁文件并说清每条记录的用途;在锁文件冲突现场判断该保留哪一边、如何处置;解释幽灵依赖的成因并在项目里根治它;为一个 Monorepo 仓库设计工作区结构;为流水线选对安装命令并配好缓存;对一次依赖引入做出安全评估;以及在新项目开工时,有依据地在几大包管理器之间做出选型。
这些能力没有一条靠背诵获得——它们来自勘验现场的次数。所以每节末尾的命令都建议真的敲一遍:把现场复原,把输出对上,判断力才会长在自己身上。
勘验的第一课:不要相信任何"应该没问题"。安装日志、锁文件、目录结构,三样东西摆在一起,真相通常就藏在那行没人细读的输出里。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...